그로킹은 선형 회귀에서도 일어난다
일반화가 늦게 찾아오는 까닭과 그 시간을 식으로 밝힌 ICML 2026 우수논문 가작
To Grok Grokking: Provable Grokking in Ridge RegressionICML 2026 Spotlight, Outstanding Paper Honorable Mention
3줄 요약
- 훈련 데이터를 다 맞힌 뒤 한참이 지나서야 일반화가 시작되는 그로킹(grokking)은 신경망에서만 생기는 일이 아니다. 이 논문은 과매개변수화된(over-parameterized) 선형 회귀를 가중치 감쇠(weight decay)와 경사 하강법으로 학습해도 그로킹이 일어난다는 것을 처음부터 끝까지 증명한다.
- 까닭은 단순하다. 데이터가 걸쳐 있는 방향의 가중치는 금방 맞춰지지만, 데이터가 닿지 않는 방향의 가중치는 초기값 근처에 남아 있다가 가중치 감쇠가 조금씩 깎아 낼 때까지 테스트 성능을 붙잡는다.
- 일반화가 늦어지는 시간은 가중치 감쇠 \(\lambda\)에 반비례하고, 초기화 크기의 로그에 비례해 늘어난다. 저자들은 이 관계가 두 층 ReLU 신경망에서도 방향만큼은 맞는다는 것을 실험으로 보였다.
선정 이유
ICML 2026 우수논문 가작(Outstanding Paper Honorable Mention)이다. 심사위원회는 그로킹이 이렇게 단순한 설정에서도 나타난다는 것을 보인 점을 높이 샀다. 깊은 선형망이 비선형망을 분석하는 발판이 되었듯, 이 모델이 그로킹을 연구하는 장난감 모형(toy model)이 될 수 있다는 평이다.
블로그의 연구 여지 지도에서 이 논문이 속한 ‘신경망 일반화와 암기’는 LLM 중심 주제를 뺀 109개 주제 가운데 23위다. 연산 부담이 거의 없는 학습 이론이라 10월 테마 중 ’덜 붐비는 학습 이론’ 갈래와 맞닿아 있다.
- 전후로 아는 것이 달라졌나. 달라졌다. 그로킹을 설명하려는 시도는 많았지만 이른 과적합, 오래가는 나쁜 일반화, 뒤늦은 일반화의 세 단계를 한꺼번에 증명한 결과는 없었다. 이 논문은 비선형성도 깊이도 없는 모델에서 세 단계를 모두 증명했다.
- 새 질문을 여는가. 연다. 가중치 감쇠 없이 생기는 그로킹, 잡음 섞인 레이블, 신경망 특유의 학습 국면 전이로 설명되는 그로킹은 이 틀 밖에 있다. 어디까지가 같은 원리인지가 다음 질문이다.
- 일반화될 근거가 있나. 무작위 특징(random features) ReLU 망, 두 층을 모두 학습하는 ReLU 망, 무작위 푸리에 특징, 레이블 잡음 실험에서 비슷한 경향이 나왔다. 다만 정량식이 들어맞는 것은 선형 모델뿐이고, 신경망에서는 방향만 맞는다.
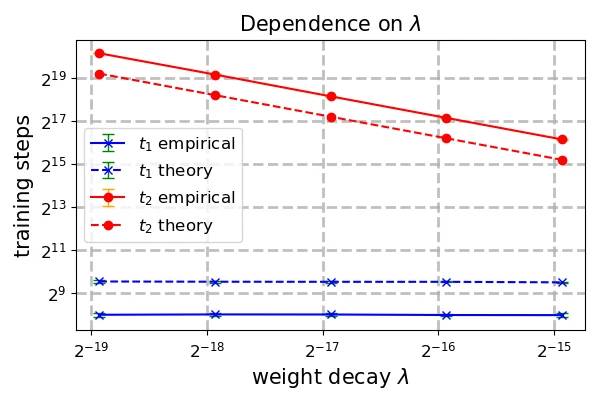
- 증거가 주장만큼 강한가. 선형 모델에서는 이론 곡선과 실험 곡선이 네 가지 하이퍼파라미터 모두에서 같은 모양으로 움직인다(논문 그림 2). 반면 그로킹을 ’두 문턱 사이의 시간 차’로 넓게 정의했다는 비판이 심사에서 나왔다.
왜 중요한가
그로킹은 Power 등(2022)이 모듈러 덧셈 같은 작은 알고리즘 데이터셋에서 처음 이름 붙인 현상이다. 학습 정확도는 일찍 100%에 이르는데 검증 정확도는 한참 동안 우연 수준에 머물다가 훨씬 뒤에야 올라간다. 학습 단계를 로그 눈금으로 그려야 한눈에 들어올 만큼 그 간격이 길다.
그 뒤로 설명이 쏟아졌다. 표현 학습의 관점, 외우는 회로와 일반화하는 회로의 효율 경쟁, 학습 초반의 게으른(lazy) 국면에서 풍부한(rich) 국면으로 넘어가는 전이 같은 설명이다. 그런데 대부분 실험으로 뒷받침했거나 일부 단계만 증명했다. 과적합이 일찍 오고, 나쁜 일반화가 오래 이어지고, 결국 일반화가 좋아진다는 세 단계를 끝까지 증명한 결과는 없었다.
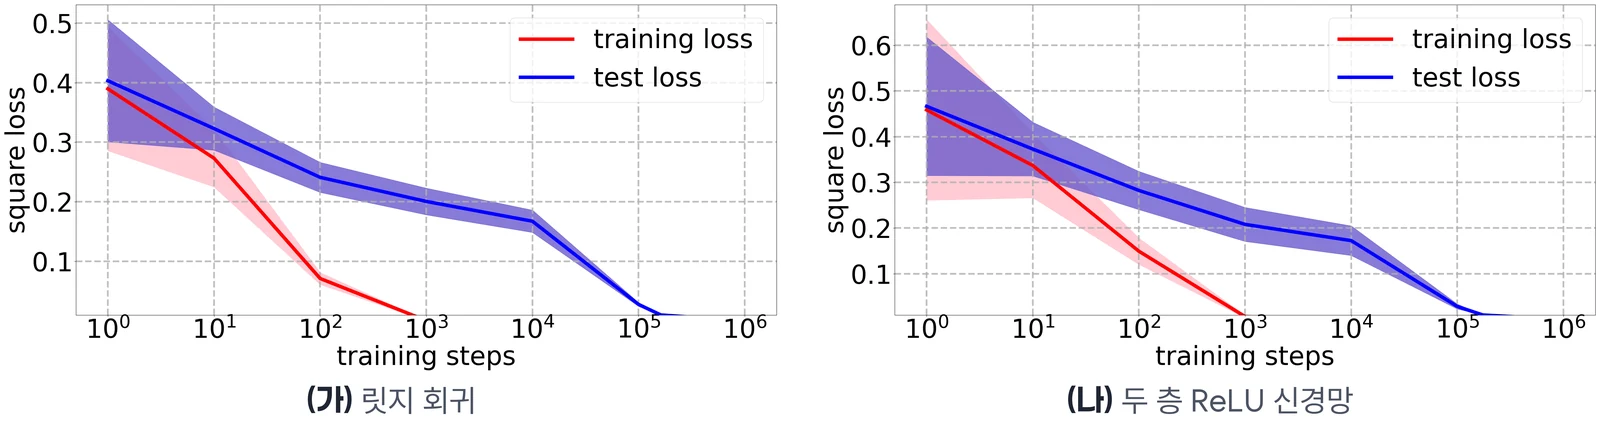
실무자에게도 뜻이 있다. 이 논문의 결론대로라면 그로킹은 딥러닝에 숨은 고장이 아니라 학습 조건이 빚어낸 결과다. 블로그의 해석으로는, 훈련 손실이 0에 닿았다고 곧바로 학습을 멈추면 뒤늦게 올 일반화를 놓칠 수 있고, 거꾸로 가중치 감쇠를 조금 키우는 것만으로 그 긴 기다림을 없앨 수도 있다.
핵심 아이디어
직관: 데이터가 닿지 않는 방향
학생 모델은 고정된 특징 사상(feature map) \(\phi(x)\in\mathbb{R}^m\) 위의 선형 모델 \(N(x;\theta)=\langle\theta,\phi(x)\rangle\)이고, 교사도 같은 꼴 \(N^*(x)=\langle\theta^*,\phi(x)\rangle\)이다(2장). 특징 차원 \(m\)이 표본 수 \(n\)보다 훨씬 크다고 하자.
그러면 \(n\)개의 학습 표본은 \(m\)차원 공간 가운데 기껏해야 \(n\)차원만 차지한다. 가중치를 이 데이터 부분공간에 놓인 성분 \(\theta_\parallel\)과 그에 수직인 성분 \(\theta_\perp\)으로 나누면, 학습 손실은 \(\theta_\parallel\)에만 달려 있다. 그래서 경사 하강법은 \(\theta_\parallel\)을 빠르게 맞춘다. 반면 \(\theta_\perp\)에는 데이터에서 오는 기울기가 전혀 없고, 가중치 감쇠만이 한 걸음마다 \((1-\eta\lambda)\)배씩 줄여 나간다(4.2절).
문제는 테스트 입력이 학습 표본과 다른 방향을 가리킨다는 데 있다. 무작위로 초기화된 \(\theta_\perp\)은 테스트 예측에 잡음처럼 섞여 들어가고, \(\lambda\)가 작으면 이 잡음이 아주 오래 남는다. 학습 오차는 벌써 0 근처인데 테스트 오차는 천천히만 떨어지는 구간이 이렇게 생긴다.
(가) 가중치 공간에서 본 학습
(나) 두 속도
방법: 가장 단순한 경우부터
저자들은 먼저 교사가 0 함수인 경우를 본다(정리 4.1). 이때 학습 오차의 위 한계와 테스트 오차의 아래 한계가 다음처럼 나온다. 테스트 쪽은 높은 확률로 성립한다.
\[ L_n(\theta^{(t)}) \le \frac{L}{2}\Big(1-\tfrac{\eta}{n}\lambda^{+}_{\min}(\Phi^\top\Phi)-\eta\lambda\Big)^{2t}\lVert\theta^{(0)}\rVert_2^2, \qquad L(\theta^{(t)}) \ge \lambda_{\min}(\Sigma)\,(1-\eta\lambda)^{2t}\,\frac{(m-n)\nu^2}{2} \]
\(\nu^2\)은 초기화 분산, \(\Phi\)는 학습 표본의 특징 행렬, \(\Sigma\)는 특징의 모집단 공분산이다. 학습 오차는 데이터 행렬의 가장 작은 양의 고윳값 \(\lambda^{+}_{\min}(\Phi^\top\Phi)/n\)이 정하는 빠른 속도로 줄지만, 테스트 오차는 \((1-\eta\lambda)^{2t}\)라는 훨씬 느린 속도로만 줄 수 있다. \(\lambda\)가 작을수록 두 속도의 차이가 벌어지고, 이 차이가 곧 그로킹이다.
수식: 두 시각과 그 간격
일반 교사로 넓힌 주정리(정리 4.2)는 두 시각을 정의한다. \(t_1\)은 학습 오차가 마지막으로 \(\epsilon\) 이상인 시각이고, \(t_2\)는 테스트 오차가 처음으로 \(c\) 이하가 되는 시각이다(\(c\ge\epsilon\)). 표본 수, 특징 차원, 가중치 감쇠가 적당한 조건을 만족하면 높은 확률로 다음이 성립한다. \(b\)는 특징 벡터 노름의 상한이다.
\[ t_1 \le \frac{n\,\ln\!\big(6b^2\lVert\theta^{(0)}\rVert_2^2/\epsilon\big)}{2\eta\,\lambda^{+}_{\min}(\Phi^\top\Phi)}, \qquad t_2 \ge \frac{\ln\!\Big(\frac{(m-n)\nu^2}{2}\big(\sqrt{c/\lambda_{\min}(\Sigma)}+\lVert\theta^*\rVert_2\big)^{-2}\Big)}{4\eta\lambda} \]
충분히 오래 학습하면 테스트 오차는 결국 \(\epsilon\) 아래로 내려간다. 논문이 그로킹 시간이라고 부르는 \(t_2-t_1\)을 하이퍼파라미터로 곧장 읽어 낼 수 있다는 점이 이 결과의 힘이다(4.2절).
- 가중치 감쇠 \(\lambda\): \(t_2\)는 \(1/\lambda\)에 비례해 늘고, \(t_1\)의 위 한계에는 \(\lambda\)가 들어 있지 않다. \(\lambda\)를 0에 가깝게 줄이면 그로킹 시간은 한없이 길어지고, 거꾸로 \(\lambda\)를 키우면 그로킹이 사라진다.
- 초기화 크기 \(\nu^2\): \(t_1\)과 \(t_2\)가 모두 \(\ln\nu^2\)에 비례해 늘지만 \(t_2\) 쪽 기울기가 더 가파르다. 초기화를 크게 할수록 간격이 벌어진다.
- 학습률 \(\eta\): 한계식에서 두 시각은 모두 \(1/\eta\)에 비례한다. 학습률만 바꾸면 걸음 수로 잰 지연은 늘거나 줄지만, \(\eta t\)로 잰 연속 시간에서는 모양이 거의 그대로다. 저자들은 심사 답변에서 학습률을 점점 줄이는 스케줄이 지연을 더 늘린다는 실험 결과도 내놓았다.
- 표본 수와 특징 차원: \(t_1\)은 \(\lambda^{+}_{\min}(\Phi^\top\Phi)\)에 달려 있는데, 이 값이 \(n\)과 \(m\)에 따라 어떻게 변하는지는 정량적인 한계가 알려져 있지 않다(비고 4.3). 실험에서는 표본이 적을수록 학습 오차가 빨리 떨어져 그로킹이 커졌고, 특징 차원은 거의 영향을 주지 않았다.
결과 해설
이론 곡선과 실험 곡선이 나란히 움직인다(5.1절, 논문 그림 2). 저자들은 특징을 \(\mathcal{N}(0, I_m/m)\)에서 뽑고 \(\eta=1\), \(n=100\), \(m=1000\), \(\nu^2=1\), \(\lambda=10^{-4}\)를 기본값으로 둔 뒤 하이퍼파라미터를 하나씩 바꿨다. 이 가정에서는 한계식이 더 구체적인 꼴로 정리되는데, 점선으로 그린 이론 한계와 실선으로 그린 실측 \(t_1\), \(t_2\)가 네 경우 모두 같은 방향, 같은 기울기로 움직였다. \(\lambda\)를 줄이면 \(t_2\)가 \(1/\lambda\)로 늘었고, 초기화 크기를 키우면 두 시각이 로그 속도로 함께 늘었다.
신경망에서는 방향만 맞는다(5.2절, 5.3절, 논문 그림 3, 4). 은닉층을 고정한 무작위 ReLU 특징 망(\(d=100\), \(m=10000\), \(\lambda=10^{-5}\))은 가중치 감쇠와 표본 수에 선형 모델처럼 반응했다. 다만 초기화 크기를 키워도 그로킹이 길어지지는 않았고, 과적합 구간에서 학습 오차와 테스트 오차의 차이만 벌어졌다. 두 층을 모두 학습하는 ReLU 망(\(d=50\), \(n=50\), \(m=1000\), \(\lambda=0.05\), \(\eta=10^{-4}\), 교사는 0 함수)에서도 \(t_1\)과 \(t_2\)가 하이퍼파라미터에 반응하는 방향은 선형 모델과 같았다. 정량식까지 맞는지는 다루지 않았다.
부록의 추가 실험. 제곱 오차가 \(\epsilon\) 이하인 테스트 입력의 비율을 정확도처럼 재면, 손실 곡선에서는 보이지 않던 긴 정체 구간이 나타났다. 표준편차 0.1의 레이블 잡음을 섞어도 그로킹이 나타났고, 잡음 크기는 그로킹 시간을 크게 바꾸지 않았다. 무작위 푸리에 특징에서도 그로킹이 나왔지만 하이퍼파라미터를 세심하게 골라야 했다.
의심해볼 점
- 그로킹을 넓게 정의했다. 이 논문의 그로킹은 학습 오차와 테스트 오차가 각자의 문턱을 넘는 시각의 차이다. 널리 알려진 그로킹처럼 테스트 성능이 오래 평평하다가 갑자기 뛰는 모습은 손실 곡선에는 없고, 정확도 비슷한 지표를 따로 만들어야 보인다.
- 가중치 감쇠가 있어야 한다. 이 이론이 설명하는 것은 가중치 감쇠가 만든 그로킹뿐이다. 가중치 감쇠 없이도 그로킹이 생긴다는 보고, 예컨대 수치 안정성의 경계에서 생기는 그로킹은 이 틀로 설명되지 않는다.
- 잡음 없는 실현 가능한 교사만 증명했다. 레이블 잡음과 실현 불가능한 교사는 실험으로만 확인했다. 저자들은 결론에서, 실현 불가능한(agnostic) 설정에서는 자신들의 기법대로 \(\lambda\)를 한없이 작게 잡으면 일반화 자체가 막힐 수 있다고 적었다.
- 선형 모델의 결론을 신경망에 옮기기는 이르다. 두 층 ReLU 망에서는 방향만 맞았다. 저자들도 두 층 망에서 나쁜 일반화가 오래 이어진다는 것조차 증명하기 어렵다고 밝혔다.
- 설명되지 않은 양이 남는다. \(t_1\)의 한계식에 들어가는 데이터 행렬의 가장 작은 양의 고윳값이 \(n\), \(m\)에 따라 어떻게 변하는지는 마르첸코 파스투르 법칙 같은 점근 결과 말고는 알려진 정량 한계가 없다.
리뷰어들이 짚은 점
ICML 2026 심사 기록은 OpenReview에 공개돼 있다. 처음에는 약한 거절(3점)을 준 리뷰어도 있었다. 저자들이 추가 실험으로 답한 뒤 메타리뷰가 정리한 최종 점수는 5, 6, 4, 6점이었고, 리뷰어 네 명 모두 우려가 해소됐다고 표시했다.
- 정체 구간이 없다. 한 리뷰어는 그로킹에서 가장 흥미로운 부분인 테스트 성능의 긴 정체를 이론이 다루지 않는다고 지적했다. 저자들은 정확도 비슷한 지표에서는 정체가 나타난다는 실험과, \(\lambda\)가 0에 가까워지면 테스트 손실이 문턱 위에 한없이 오래 머문다는 점으로 답했다. 이 리뷰어는 약한 수락(4점)에 머물며, 이 결과가 그로킹 전체를 담았다기보다 선형 모델의 시간 차를 보인 것에 가깝다는 의견을 남겼다.
- “결국 일반화한다”는 주장이 너무 강하다. 다른 리뷰어는 이 주장이 참이 되려면 교사가 특징의 선형 결합으로 정확히 표현되고, 가중치 감쇠가 끌어당기는 목표(0)와도 맞아떨어져야 한다고 봤다. 저자들은 무작위 푸리에 특징과 무작위 교사로 실험을 더해 그로킹을 확인했다.
- 사전 분포로 다시 읽기. 같은 리뷰어는 가우시안 과정(Gaussian process) 관점을 제안했다. 경사 하강법으로 학습한 선형 회귀는 초기값을 사전 평균으로 둔 가우시안 과정의 사후 평균으로 수렴하는데, 가중치 감쇠는 그 사전 평균을 초기값에서 0으로 옮긴다. 그렇게 보면 그로킹은 잘못 잡힌 사전 분포에서 알맞은 사전 분포로 넘어가는 과정이다. 저자들은 이 해석을 최종본 논의에 넣었다.
- 도구가 흔하고 잡음을 다루지 않는다. 가장 낮은 점수를 준 리뷰어는 쓰인 수학 도구가 새롭지 않고, 잡음이 있거나 비볼록한 실제 설정으로 넘어가기 어렵다고 봤다. 저자들은 레이블 잡음과 학습률 스케줄 실험을 더했고, 이 리뷰어도 수학적 엄밀함과 명료한 서술을 높이 사 점수를 올렸다.
계보
- Power 등 (2022, arXiv 2201.02177): 작은 알고리즘 데이터셋에서 그로킹이라는 이름을 처음 붙였다.
- Liu 등 (NeurIPS 2022), Omnigrok (ICLR 2023): 표현 학습 관점의 설명과, 초기화 크기와 가중치 노름으로 그로킹을 조절할 수 있다는 관찰을 내놓았다. 이 논문의 초기화 크기 결과와 맞닿아 있다.
- Nanda 등 (ICLR 2023): 기계적 해석(mechanistic interpretability)으로 그로킹이 진행되는 동안 만들어지는 회로를 추적했다.
- Lyu 등, Kumar 등 (ICLR 2024): 게으른 국면에서 풍부한 국면으로 넘어가는 전이로 그로킹을 설명했다. 이 논문은 Lyu 등의 분석이 KKT 점 수렴까지만 보장해 그로킹 자체를 증명하지는 못한다고 짚는다.
- Levi 등 (ICLR 2024): 선형 추정기의 그로킹을 랜덤 행렬 이론으로 분석했다. 엄밀한 증명은 아니었고, 가우시안 데이터에 가중치 감쇠가 없는 설정이었다.
- Xu 등 (ICLR 2024): 군집 XOR 데이터에서 과적합 뒤의 일반화를 보였다. 이 논문 이전에 증명에 가장 가까웠던 결과지만, 일반화가 두 번째 걸음부터 시작될 수도 있어 ’지연’까지는 보이지 못했다.
- Boursier 등 (NeurIPS 2025), Notsawo 등 (ICML 2025): 가중치 감쇠가 만드는 두 단계 궤적과 \(1/(\eta\lambda)\) 시간 척도를 다뤘다. 이 논문은 릿지 회귀에서 이를 끝까지 증명된 한계식으로 좁혔다.
- Prieto 등 (ICLR 2025): 가중치 감쇠 없이 생기는 그로킹을 수치 안정성 문제로 설명했다. 이 논문과는 다른 갈래다.
- 후속: “Structured Features Overfit Where Random Features Grok”(arXiv 2609.15047)은 이 논문을 직접 인용하며, 구조가 있는 푸리에 특징에서는 같은 지연이 나타나지 않고 과적합으로 끝난다고 보고했다. 같은 해 나온 “Grokking on the Weight-Decay Clock”(arXiv 2607.23967)은 모멘텀을 쓴 선형 모델에서 느린 이완을 정확히 풀었다. 그리고 모집단 오차에 영향을 주는 영공간 성분만이 그로킹 시간을 정한다고 보였다.
열린 질문
- 가중치 감쇠가 아닌 다른 원인. 가중치 감쇠 없이 생기는 그로킹이나, 신경망이 게으른 국면에서 풍부한 국면으로 넘어가며 생기는 그로킹도 ’데이터가 닿지 않는 방향이 늦게 풀린다’는 같은 그림으로 설명되는가.
- 어떤 특징이 그로킹을 만드는가. 무작위 특징에서는 그로킹이, 구조가 있는 특징에서는 과적합이 나타난다는 후속 보고를 보면, 특징 공분산의 어떤 성질이 둘을 가르는가.
- 학습률 스케줄이 바꾸는 시계. 학습률을 점점 줄여 가는 스케줄에서는 가중치 감쇠가 흘려보내는 시간이 어떻게 달라지는가.
이해 확인
1. 가중치 감쇠 λ를 줄이면 학습 오차가 줄어드는 속도는 거의 그대로인데 테스트 오차는 크게 느려진다. 까닭은?
- λ가 작으면 학습률도 함께 작아지기 때문이다
- 학습 오차는 데이터가 걸친 성분만 보는데, 테스트 오차를 붙잡는 θ⊥은 데이터 기울기를 받지 못하고 한 걸음에 (1−ηλ)배씩만 줄기 때문이다
- λ가 작으면 모델이 교사 함수를 표현하지 못하기 때문이다
- 테스트 데이터에 잡음이 더 많기 때문이다
θ∥은 데이터 항이 정하는 빠른 속도로 맞춰지므로 λ를 줄여도 거의 그대로다(정리 4.1). θ⊥에는 데이터에서 오는 기울기가 전혀 없어 가중치 감쇠만이 줄인다. 그래서 λ를 줄이면 테스트 쪽만 느려지고, t₂가 1/λ에 비례해 늘어난다.
2. 이 결과에 특징 차원 m이 표본 수 n보다 훨씬 커야 하는 까닭은?
- m이 커야 학습이 불안정해지기 때문이다
- 데이터가 닿지 않는 방향이 m − n개쯤 남아야, 그 방향의 초기 가중치가 테스트 예측을 오래 흐리기 때문이다
- m이 커야 학습 오차가 0에 닿지 못하기 때문이다
- m이 크면 가중치 감쇠가 더 세게 작동하기 때문이다
테스트 오차를 붙잡는 것은 초기값에서 남은 θ⊥이고 그 크기는 대략 (m − n)ν²이다. m이 n과 비슷하면 데이터가 거의 모든 방향을 덮어 θ⊥이 작아지고, 과적합 뒤 나쁜 일반화가 오래 이어질 근거가 사라진다. t₂의 아래 한계에서 로그 안의 (m − n)ν² 항이 이 역할을 한다.
3. 모든 가중치를 0으로 초기화하면 이 논문이 말하는 그로킹이 생길까?
- 생긴다. 초기값과 상관없이 t₂는 1/λ에 비례한다
- 생기지 않는다. θ⊥이 처음부터 0이라 테스트 예측을 흐리는 성분이 없다
- 더 심해진다. 0에서 출발하면 학습 오차가 늦게 줄기 때문이다
- 알 수 없다. 논문이 초기화를 다루지 않았다
두 시각은 모두 ln ν²에 비례해 늘고 t₂의 계수가 훨씬 커서, 초기화를 키울수록 간격이 벌어진다. 거꾸로 0에서 출발하면 θ⊥이 없다. 가중치 감쇠 없이 0에서 출발한 경사 하강법은 최소 노름 보간해로 가므로, 이 논문의 메커니즘으로는 그로킹이 생기지 않는다(6장).
논문 정보
- 제목: To Grok Grokking: Provable Grokking in Ridge Regression
- 저자: Mingyue Xu (Purdue University), Gal Vardi (Weizmann Institute of Science), Itay Safran (Ben-Gurion University of the Negev)
- 학회: ICML 2026 Spotlight, Outstanding Paper Honorable Mention
- 링크: arXiv 2601.19791, OpenReview