확산 모델의 잠재 공간에 시간 축을 더하면 생기는 기하
잡음 수준까지 좌표로 삼아 디노이징 분포 사이의 최단 경로를 구한 ICLR 2026 구두 발표 논문
The Spacetime of Diffusion Models: An Information Geometry PerspectiveICLR 2026 Oral
3줄 요약
- 확산 모델(diffusion model)의 잠재 공간에 기하를 입히는 익숙한 방법은 둘 다 막힌다. 확률 흐름 ODE를 디코더로 쓰는 풀백 계량(pullback metric)은 모든 최단 경로를 데이터 공간의 직선으로 만들고, 순수 잡음 \(x_T\)에 피셔-라오 계량(Fisher-Rao metric)을 얹으면 계량이 0으로 무너진다.
- 이 논문은 잡음 낀 샘플과 잡음 시각을 묶은 \((x_t, t)\)를 잠재 좌표로 삼는다. 이 \(D+1\)차원 시공간(spacetime)의 각 점은 디노이징 분포 \(p(x_0 \mid x_t)\) 하나를 가리키고, 이 분포들이 지수족(exponential family)을 이룬다는 사실 덕분에 곡선의 에너지를 디노이저 호출만으로 계산할 수 있다.
- 깨끗한 두 데이터를 잇는 최단 경로는 잡음을 더했다가 다시 걷어 내는 모양이 되고, 그 길이를 확산 편집 거리(Diffusion Edit Distance, DiffED)라고 부른다. 알라닌 다이펩타이드 전이 경로 실험에서는 경로 위 최대 에너지가 37.36으로, 수치 하한 36.42에 가장 가까웠다(표 1).
선정 이유
ICLR 2026 구두 발표(oral) 논문이다. 리뷰 점수는 8, 8, 6, 4로 갈렸고, 높은 점수를 준 리뷰어들은 잠재 표현을 다시 정의한 발상 자체를 높이 샀다.
블로그의 연구 여지 지도에서 이 논문이 속한 ’확산 모델 이론과 샘플링’은 LLM 중심 주제를 뺀 109개 주제 중 16위다. 10월 테마 ’샘플링과 생성 모델의 수학’에서 이 논문은 샘플링이 지나가는 공간이 어떻게 생겼는지를 묻는다.
- 전후로 아는 것이 달라졌나. 달라졌다. 생성 모델의 잠재 기하를 연구할 때 가장 먼저 꺼내는 풀백 계량이 확산 모델에서는 원리적으로 쓸모가 없다는 것을 짧은 증명으로 보였다. 잠재 공간과 데이터 공간의 차원이 같고 디코더가 일대일이면, 풀백 기하는 데이터 공간의 유클리드 기하와 똑같아진다.
- 새 질문을 여는가. 연다. 잡음 수준을 좌표로 삼는 순간, 샘플링 궤적, 이미지 사이 거리, 분자 전이 경로가 모두 같은 공간의 곡선 문제가 된다. 이 기하로 샘플러나 잡음 스케줄을 개선할 수 있는지는 저자들도 열린 문제로 남겼다.
- 일반화될 근거가 있나. 있다. 디노이징 분포가 지수족이라는 결과는 전방 과정이 가우시안이라는 것 말고는 데이터에 아무 가정도 하지 않는다. 이미지(EDM2, ImageNet 512)와 분자(알라닌 다이펩타이드)라는 전혀 다른 두 영역에 같은 계산이 그대로 들어갔다.
- 증거가 주장만큼 강한가. 틀은 단단하다. 핵심 명제는 짧고 검증하기 쉽다. 응용 쪽 증거는 얇은 편이다. 이미지 거리 평가는 200쌍에 대한 상관 계수 두 개가 전부이고, 전이 경로 실험은 2차원 이면각 공간 하나에서만 했다.
왜 중요한가
변분 오토인코더(VAE)처럼 저차원 잠재 공간을 가진 생성 모델에서는 디코더의 야코비안으로 데이터 공간의 거리를 잠재 공간으로 끌어오는 풀백 계량이 잘 알려져 있다. 이 리만 계량(Riemannian metric) 아래 최단 경로, 곧 측지선(geodesic)은 데이터가 놓인 곡면을 따라 휘어진다.
확산 모델에서 이 방법을 그대로 쓰면 무슨 일이 생길까. 확률 흐름 ODE(probability flow ODE)는 잡음 \(x_T\)를 데이터 \(x_0\)로 보내는 결정론적 디코더다. 이 디코더로 풀백 계량을 만들면, 잡음 공간 곡선의 에너지는 디코딩된 곡선의 유클리드 에너지 \(\tfrac12\int_0^1 \|\tfrac{d}{ds}x_0(\gamma_s)\|^2 ds\)와 같아진다(4장). 이 값을 최소로 만드는 곡선은 두 끝점을 잇는 직선뿐이고, ODE가 일대일이니 그 직선을 잡음 공간으로 되돌린 곡선이 곧 측지선이다. 결국 어떤 측지선이든 데이터 공간에서는 직선으로 풀린다(부록 B). 데이터가 곡면 위에 놓여 있어도 경로는 그 곡면을 무시하고 빈 공간을 가로지른다. 논문은 원인을 차원에서 찾는다. VAE와 달리 확산 모델은 잠재 공간과 데이터 공간의 차원이 같아서, 차원을 줄이는 과정에서 생기는 굴곡이 없다.
그러면 확률적 디코더는 어떨까. 역방향 SDE는 잡음 \(x_T\)마다 데이터 분포 \(p(x_0 \mid x_T)\)를 하나씩 정한다. 분포 사이 거리를 재는 정보 기하(information geometry)의 표준 도구가 피셔-라오 계량이고, 이 계량으로 재면 잠재 좌표를 조금 움직였을 때 디노이징 분포 전체가 얼마나 바뀌는지를 KL 발산으로 잴 수 있다(식 7, 8). 그런데 확산 모델은 끝 시각에서 기억을 잃도록 설계돼 있다. \(p(x_T \mid x_0) \approx p_T(x_T)\)이므로 \(p(x_0 \mid x_T) \approx q(x_0)\)이고, 어떤 \(x_T\)에서 출발해도 디노이징 분포가 데이터 분포와 같아진다(식 11). 좌표를 움직여도 분포가 변하지 않으니 계량은 0으로 무너진다.
(가) 풀백 기하
(나) 끝 시각에서 무너지는 정보 기하
핵심 아이디어
직관: 잡음 수준도 좌표다
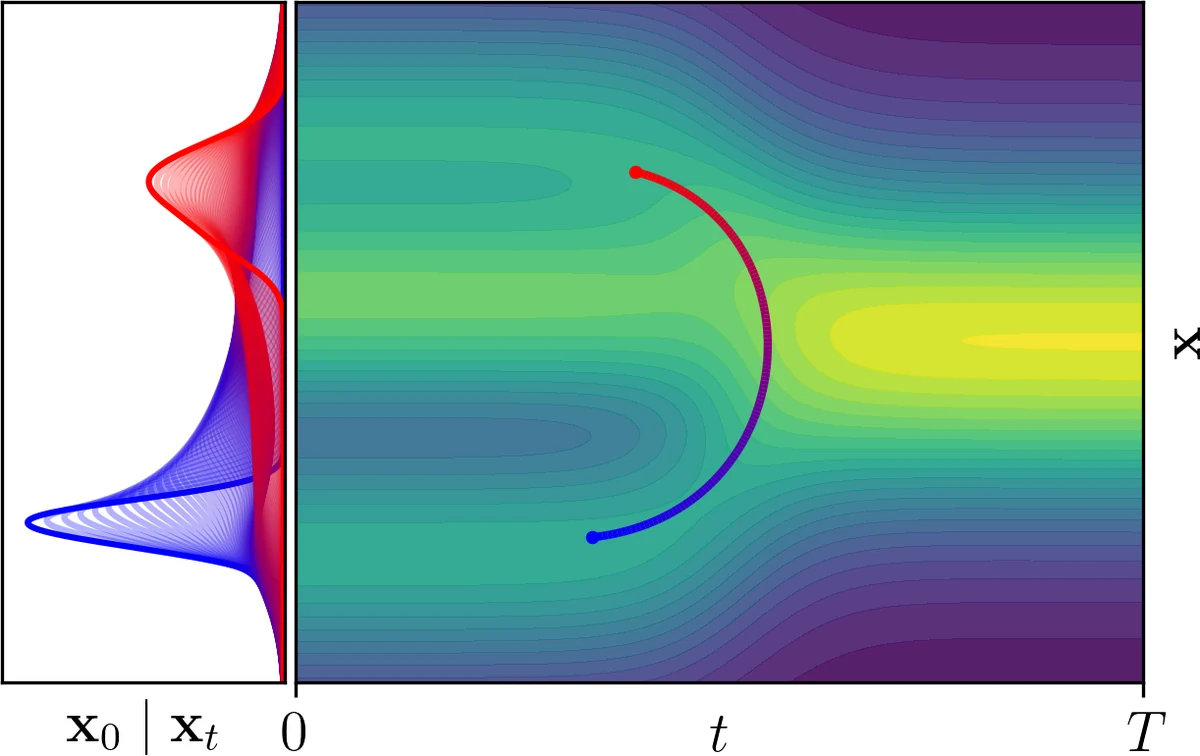
끝 시각 \(T\) 대신 어떤 중간 시각 \(t\)를 골라 \(x_t\)를 잠재 좌표로 삼으면 계량은 살아난다. 하지만 어느 \(t\)를 골라야 할지 정할 근거가 없다. 논문은 고르지 않고 모든 잡음 수준을 한꺼번에 쓴다. 잠재 좌표를 \(z = (x_t, t) \in \mathbb{R}^D \times (0, T]\)로 두면(식 12), 이 \(D+1\)차원 공간의 점마다 디노이징 분포 \(p(x_0 \mid x_t)\)가 하나씩 대응한다. 시각이 0에 가까운 점은 깨끗한 데이터 \(x\) 하나에 몰린 분포를, 시각이 큰 점은 넓게 퍼진 분포를 가리킨다.
이렇게 두면 깨끗한 두 데이터 사이의 최단 경로가 새로운 모양을 띤다. 두 끝점 \((x^a, 0)\)과 \((x^b, 0)\)을 잇는 측지선은 잡음 쪽으로 올라갔다가 내려온다. 논문은 이것을 편집의 연쇄로 읽는다. \(x^a\)에만 있는 정보를 잊을 만큼만 잡음을 더하고, 다시 잡음을 걷어 내면서 \(x^b\)에만 있는 정보를 채워 넣는다. 두 데이터가 비슷할수록 조금만 올라가면 되고, 다를수록 더 높은 잡음까지 올라가야 한다(6.2절, 그림 4). 이 측지선의 길이가 확산 편집 거리 \(\mathrm{DiffED}(x^a, x^b)\)다(식 17).
방법: 디노이징 분포는 지수족이다
정보 기하에서 측지선은 보통 곡선 위 이웃한 분포 사이의 KL을 더해 구하는데(식 13), 분포가 가우시안처럼 식으로 쓰이지 않으면 KL을 계산할 수 없다. 디노이징 분포는 봉우리가 여럿인 복잡한 분포다.
논문의 핵심 관찰은 베이즈 규칙 한 줄에서 나온다. 전방 과정이 \(p(x_t \mid x_0) = \mathcal N(\alpha_t x_0, \sigma_t^2 I)\)이면
\[ p(x_0 \mid x_t) \;\propto\; q(x_0)\,\exp\!\Big(\frac{\alpha_t}{\sigma_t^2}\, x_t^\top x_0 \;-\; \frac{\alpha_t^2}{2\sigma_t^2}\,\|x_0\|^2\Big) \]
이고, 이것은 기저 측도가 데이터 분포 \(q\)이고 충분 통계량이 \(T(x_0) = (x_0, \|x_0\|^2)\)인 지수족이다(부록 C.2). 자연 모수(natural parameter)는 \(\eta(x_t, t) = \big(\tfrac{\alpha_t}{\sigma_t^2}x_t,\; -\tfrac{\alpha_t^2}{2\sigma_t^2}\big)\)로 좌표에서 바로 계산되고, 기댓값 모수(expectation parameter)는 \(\mu(x_t, t) = \big(\mathbb E[x_0 \mid x_t],\; \mathbb E[\|x_0\|^2 \mid x_t]\big)\)다(식 15). 데이터 분포가 아무리 복잡해도 복잡함은 기저 측도에만 들어가고, 좌표가 분포를 바꾸는 방식은 단순하다.
지수족에서는 피셔-라오 계량이 \(G(z) = (\partial\eta/\partial z)^\top(\partial\mu/\partial z)\)로 쓰이고, 곡선의 에너지는 두 모수의 변화량의 내적으로 줄어든다(부록 C.1). 두 모멘트는 학습된 디노이저 \(\hat x_0\)에서 얻는다. 1차 모멘트는 트위디 공식(Tweedie’s formula)에 따라 디노이저 출력 그 자체이고, 2차 모멘트는 디노이징 공분산 공식에서 \(\|\hat x_0\|^2 + \tfrac{\sigma_t^2}{\alpha_t}\,\mathrm{div}_{x_t}\hat x_0\)가 된다(식 16). 발산은 허친슨 추정(Hutchinson’s trick)으로 야코비안 벡터곱(JVP) 한 번에 구한다.
수식: 무엇을 계산하나
명제 5.1은 \(N\)개의 점으로 나눈 시공간 곡선의 에너지를 이렇게 근사한다.
\[ \mathcal E(\gamma) \;\approx\; \frac{N-1}{2}\sum_{n=0}^{N-2}\big(\eta(z_{n+1}) - \eta(z_n)\big)^\top\big(\mu(z_{n+1}) - \mu(z_n)\big) \]
각 항은 이웃한 두 디노이징 분포 사이 대칭 KL의 두 배와 정확히 같다(부록 D). 측지선은 이 에너지를 곡선의 모수(3차 스플라인의 마디)에 대해 경사 하강으로 줄여서 구하고, 길이 \(\sum_n \sqrt{\Delta\eta_n^\top \Delta\mu_n}\)가 DiffED가 된다(부록 E의 알고리즘 3, 4). 에너지를 한 번 계산하는 데 드는 것은 점마다 JVP 한 번, 모두 \(N\)번이다. 역방향 SDE는 한 번도 돌리지 않는다.
에너지에 벌점 항 \(\lambda\int_0^1 h(\gamma_s)\,ds\)를 더하면 경로에 조건을 붙일 수도 있다(식 21, 6.4절).
논문의 1차원 예(성분 세 개인 가우시안 혼합, 부록 G.1)에서는 사후 모멘트를 정확히 계산할 수 있어서, 디노이저 없이 측지선을 직접 구해 볼 수 있다.
(가) 측지선과 잡음을 지키는 경로
(나) 끝점이 멀수록 높이 오른다
두 데이터가 멀수록 잡음을 더 넣어 올라갔다 내려오는 편이 옆으로 곧장 가는 것보다 싸다(블로그의 해석).
결과 해설
샘플링 궤적과 측지선. 잡음 \(x_T\)에서 확률 흐름 ODE로 푼 궤적과, 같은 두 끝점을 잇는 시공간 측지선을 비교했다(6.1절, 그림 3). 1차원 혼합 분포에서는 측지선이 잡음이 많은 초반에 덜 휘고, 잡음이 적은 후반에는 두 곡선이 겹친다. ImageNet 512 해상도로 학습된 EDM2 모델에서는 눈에 띄는 차이가 거의 없었고, 측지선이 정보를 조금 일찍 만들어 내는 정도였다. 리뷰어의 요청으로 저자들이 답변에서 잰 두 궤적 사이의 LPIPS는 최대 약 0.045였다. 다만 측지선은 끝점을 알아야 구할 수 있어서 샘플링 방법이 아니고, 궤적 하나를 구하는 데 A100 GPU로 약 2시간이 걸렸다(부록 G.2).
확산 편집 거리. 이미지 사이의 측지선은 흐린 잡음 단계를 지나 반대편 이미지로 내려간다(그림 4). 비슷한 두 이미지는 옅은 잡음만 거치고, 생김새가 많이 다른 쌍일수록 더 짙은 잡음을 지난다. ImageNet에서 무작위로 고른 10개 클래스에서 클래스마다 20쌍을 뽑아 비교하니, DiffED와 LPIPS의 상관은 약 −7%로 거의 없었고 SSIM과의 상관은 53%였다(6.2절). 저자들은 답변에서 적은 잡음이 주로 세부 질감(고주파)을 지우고 큰 구조(저주파)는 남기기 때문에 구조 지표인 SSIM과 더 닮았다고 설명했다. 이미지 한 쌍의 측지선을 구하는 데 가장 큰 EDM2 모델로 A100에서 약 6분, 가장 작은 모델로 약 1분이 든다(부록 G.2).
분자 전이 경로. 볼츠만 분포 \(q(x) \propto e^{-U(x)}\)에서는 디노이징 분포의 에너지도 \(U(x_0) + \tfrac12 \mathrm{SNR}(t)\|x_0 - x_t/\alpha_t\|^2\)로 식이 나온다(식 19). 두 안정 상태를 잇는 시공간 측지선을 구한 뒤, 측지선 위의 점을 차례로 옮겨 가며 그 점의 디노이징 분포에서 랑주뱅 동역학을 몇 걸음씩 돌리면(알고리즘 1) 한쪽 상태에서 다른 쪽으로 넘어가는 전이 경로가 나온다.
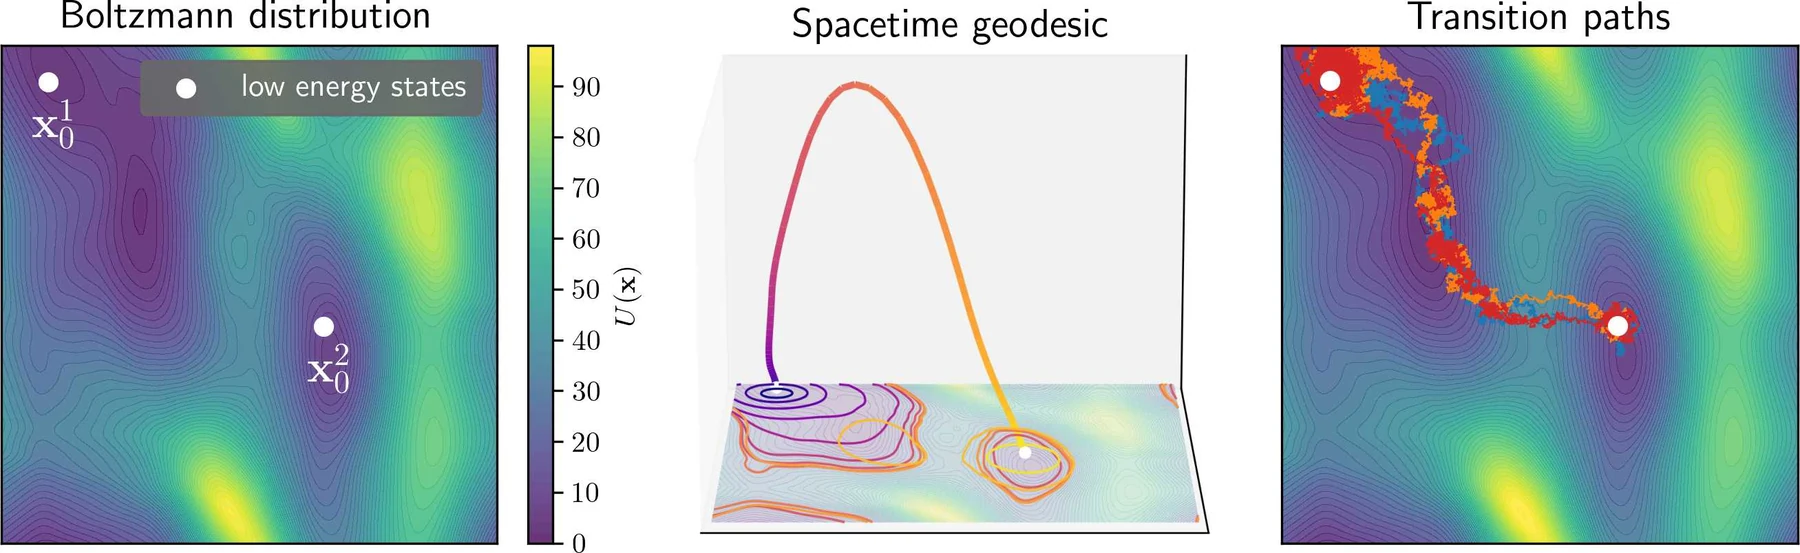
경로 1,000개를 만들어 경로 위 최대 에너지(MaxEnergy)의 평균과 에너지 평가 횟수를 비교했다(표 1).
| 방법 | MaxEnergy (낮을수록 좋음) | 에너지 평가 횟수 |
|---|---|---|
| 수치 하한 | 36.42 | 없음 |
| MCMC, 경로 길이 고정 | 42.54 ± 7.42 | 12.9억 |
| MCMC, 경로 길이 가변 | 58.11 ± 18.51 | 2,102만 |
| Doob’s Lagrangian | 66.24 ± 1.01 | 3,840만 |
| 시공간 측지선 | 37.36 ± 0.60 | 1,600만 (+1,600만) |
괄호 안의 1,600만 번은 기반 확산 모델을 학습할 데이터를 랑주뱅 동역학으로 만드는 데 한 번 드는 비용이다. 저자들이 답변에서 밝힌 M1 CPU 기준 시간은 이 방법이 약 10분, 경로 길이를 고정한 MCMC가 약 72시간이었다. 분산을 줄이는 벌점을 주면 경로가 좁은 띠로 모이고, 지정한 영역과의 KL을 벌점으로 주면 경로가 그 영역을 돌아간다(그림 7).
의심해볼 점
- 깨끗한 끝점을 다루지 못한다. 시각이 0에 가까워지면 디노이징 분포가 한 점에 몰려 이웃한 분포 사이 KL이 발산한다. 그래서 실험의 끝점은 모두 잡음이 조금 남은 \(t_{\min}\)에 두었다. 이미지는 log SNR = 2, 분자는 log SNR = 4다(8장, 부록 G). DiffED의 값이 이 선택에 얼마나 민감한지는 보고되지 않았다.
- 측지선이 최단 경로라는 보장은 없다. 경사 하강이 수렴하면 에너지의 임계 곡선, 곧 측지선을 얻지만 가장 짧은 곡선이라는 보장은 없다. 저자들은 답변에서 데이터가 가우시안일 때와 유한 개의 점일 때는 측지선이 유일하다는 증명 스케치를 냈다. arXiv 4판에는 이 증명이 실려 있지 않다.
- DiffED 평가가 얇다. LPIPS, SSIM과의 상관 두 개와 정성 비교가 전부다. 무엇을 잴 때 DiffED가 기존 지표보다 나은지를 보여 주는 과제는 없다. 계산도 이미지 한 쌍에 수 분이라, SSIM(약 0.4ms)과 비교하면 수십만 배 느리다(답변).
- 전이 경로 실험의 범위. 2차원 이면각 공간 하나에서만 했고, 에너지 함수도 신경망으로 근사한 것이다(부록 G.3). 비교 대상 셋 중 둘은 재현이 되지 않아 빠졌고, Doob’s Lagrangian은 원 논문보다 훨씬 나쁜 결과가 나왔다고 저자들이 직접 밝혔다(부록 H). 기준선이 약했을 가능성을 배제하기 어렵다.
- 디노이저 오차. 디노이저 오차와 발산 추정의 분산이 측지선에 주는 영향은 분석하지 않았다.
리뷰어들이 짚은 점
OpenReview에 심사 기록이 공개돼 있다. 네 리뷰어가 8, 8, 6, 4점을 줬고 구두 발표로 채택됐다.
- 기억 상실의 근거. 한 리뷰어가 \(p(x_0 \mid x_T) \approx q(x_0)\)의 근거를 묻자, 저자들은 베이즈 규칙에서 \(p(x_T \mid x_0)/p(x_T)\)가 1에 가까우니 두 변수가 사실상 독립이라고 답했다.
- 왜 시간까지 넣나. 같은 리뷰어가 시각을 하나로 고정하면 무엇이 달라지느냐고 물었다. 저자들은 시각을 고정하면 경로의 자유도가 줄어 에너지가 커지고, 깨끗한 데이터를 나타내려고 아주 작은 \(t\)로 고정하면 기하가 유클리드로 무너져 측지선이 다시 직선이 된다고 답했다.
- 계산 비용. 네 리뷰어가 모두 비용을 물었다. 저자들은 Azeglio, Di Bernardo(arXiv 2505.11128)보다 대략 5배 빠르다고 추정했지만, 같은 조건에서 잰 값은 아니라고 덧붙였다.
- SSIM과 LPIPS. 가장 낮은 점수를 준 리뷰어가 LPIPS와 상관이 없는 이유를 물었고, 메타 리뷰는 이를 해결된 결함이 아니라 지표의 성격으로 정리했다.
- 활용처. SDEdit에 쓸 수 있느냐는 질문에 저자들은 측지선이 필요한 잡음 수준을 알려 줄 수 있다는 가설만 내놓았다.
계보
- 생성 모델의 잠재 기하. Arvanitidis 외(ICLR 2018)가 VAE 디코더의 풀백 계량으로 잠재 공간의 곡률을 드러냈고, Arvanitidis 외(AISTATS 2022)가 확률적 디코더에 피셔-라오 계량을 쓰는 틀과 국소 KL 근사를 정리했다. 이 논문의 에너지 근사가 그 틀 위에 있다. Park 외(NeurIPS 2023)는 확산 모델의 저차원 잠재 코드에 리만 기하를 적용했다.
- 확산 모델의 기하. Yu 외(2025)는 밀도의 역수로 계량을 만들었고, Azeglio, Di Bernardo(arXiv 2505.11128)는 점수 함수에서 고정된 잡음 수준의 계량을 만들었다. 이 논문은 피셔-라오 계량을 쓰고, 차원을 줄이지 않으며, 모든 잡음 수준을 함께 다룬다는 점에서 다르다(7장).
- 정보 기하와 확산 과정. Das 외(2023)는 전방 과정 자체를 피셔 계량의 최단 경로로 설계했고, Ghimire 외(2023)는 두 과정을 바서슈타인 기울기 흐름으로 봤다. 이 논문은 역방향의 디노이징 분포에 기하를 얹는다.
- 이 블로그의 이전 글. 기울기만으로 거부 샘플링을 하는 논문은 역방향 한 걸음의 분포 \(p(x \mid x') \propto p_k(x)\exp(-\|x - x'/\alpha\|^2/2\eta)\)가 가우시안 틸트라는 데서 출발했다. 이 논문의 디노이징 분포도 같은 베이즈 규칙에서 나온 틸트이고, 그 틸트가 지수족이라는 점을 기하로 끌어냈다(블로그의 해석).
- 후속 연구. arXiv 2608.23916(2026년 8월)은 디노이징 점수 매칭 손실에서 줄일 수 없는 부분이 조건부 끝점 분포족의 피셔-라오 계량의 대각합을 확산 경로를 따라 적분한 값과 같다고 보였다. 확산 잠재 공간에서 관찰된 정보 기하가 학습 손실 안에 이미 들어 있다는 주장이다.
열린 질문
- 샘플링에 쓸 수 있을까. 시공간 계량은 샘플링 궤적을 따라 디노이징 분포가 얼마나 빨리 변하는지를 잰다. 이 속도를 스케줄이나 샘플러 설계에 쓸 수 있을지, 저자들도 다음 과제로 남겼다.
- DiffED는 무엇을 재는가. 구조와 의미 가운데 무엇에 민감한지, 기억된 샘플이나 분포 밖 샘플을 가려내는 데 쓸 수 있는지, 빠르게 근사할 방법이 있는지가 모두 열려 있다.
- 깨끗한 데이터 사이의 거리. 시각이 0으로 갈 때 길이가 발산하는 문제를 끝점의 잡음 수준을 고르는 방식이 아니라 원리적으로 다룰 수 있을까.
이해 확인
1. 확률 흐름 ODE로 만든 풀백 계량의 측지선이 늘 데이터 공간의 직선으로 풀리는 이유는?
- ODE를 푸는 비용이 너무 커서 측지선을 끝까지 최적화하지 못하기 때문이다
- 끝 시각에서 디노이징 분포가 데이터 분포와 같아져 계량이 0이 되기 때문이다
- 디코더가 같은 차원 사이의 일대일 사상이라, 곡선의 에너지가 디코딩한 경로의 유클리드 에너지와 같아지기 때문이다
- 학습된 점수 함수의 오차가 경로를 곧게 펴기 때문이다
풀백 에너지는 디코딩한 곡선만의 함수 ½∫|dx₀/ds|²ds이고, 이 값은 직선에서 가장 작다. ODE가 일대일이라 그 직선을 되돌린 곡선이 곧 측지선이다(4장, 부록 B). 2번은 확률적 디코더에 피셔-라오 계량을 쓸 때 생기는 다른 문제다.
2. 잠재 좌표에 잡음 시각 t까지 넣어 (xₜ, t)로 삼은 결과로 맞는 것은?
- 모든 잡음 수준의 디노이징 분포가 같아져 계산이 단순해진다
- 깨끗한 두 데이터를 잡음 낀 중간 상태를 거쳐 잇는 측지선을 정의할 수 있다
- 측지선이 확률 흐름 ODE 궤적과 정확히 같아진다
- 역방향 SDE를 시뮬레이션해야 에너지를 계산할 수 있게 된다
시각이 0에 가까운 점은 깨끗한 데이터에 몰린 분포를 가리키므로, 두 데이터를 시공간의 점으로 놓고 잡음 쪽으로 올라갔다 내려오는 측지선으로 이을 수 있다. 그 길이가 DiffED다(5장, 6.2절). ODE 궤적과는 비슷할 뿐 같지 않고(6.1절), 에너지 계산에 SDE는 필요 없다.
3. 복잡한 디노이징 분포 사이의 에너지를 SDE 시뮬레이션 없이 계산할 수 있는 이유는?
- 디노이징 분포가 지수족이어서, 식으로 나오는 자연 모수 η와 디노이저에서 얻는 기댓값 모수 μ의 변화량 내적으로 에너지가 쓰이기 때문이다
- 디노이징 분포를 가우시안 하나로 근사하기 때문이다
- 측지선을 데이터 공간의 직선으로 제한하기 때문이다
- 끝 시각의 분포가 데이터 분포와 같다는 성질을 쓰기 때문이다
p(x₀ | xₜ)는 q(x₀)를 기저 측도로 하는 지수족이고, η는 (xₜ, t)에서 바로, μ는 디노이저 출력과 발산(JVP 한 번)으로 구한다. 이웃한 두 점의 Δη와 Δμ의 내적이 대칭 KL의 두 배라서 에너지를 점마다 JVP 한 번으로 계산한다(명제 5.1, 부록 C, D). 분포를 가우시안으로 근사하지 않는다.
논문 정보
- 제목: The Spacetime of Diffusion Models: An Information Geometry Perspective
- 저자: Rafał Karczewski, Markus Heinonen, Alison Pouplin (Aalto University), Søren Hauberg (Technical University of Denmark), Vikas Garg (Aalto University, YaiYai Ltd)
- 학회: ICLR 2026 Oral
- 링크: arXiv 2505.17517, OpenReview, 코드