결과를 다 담지 않아도 결정은 안전할 수 있다
ICLR 2026 구두 발표 ‘Conformal Robustness Control’ 짧게 읽기
Conformal Robustness Control: A New Strategy for Robust DecisionICLR 2026 Oral
한 줄 요약
예측 집합으로 결정을 내릴 때 지켜야 할 것은 “집합이 결과를 담을 확률”이 아니라 “결정의 손실이 약속한 한도를 넘지 않을 확률”이다. 이 논문은 뒤의 조건을 직접 걸고 집합을 학습해, 같은 안전 수준에서 훨씬 낮은 위험 한도를 얻는다.
무엇이 달라졌나
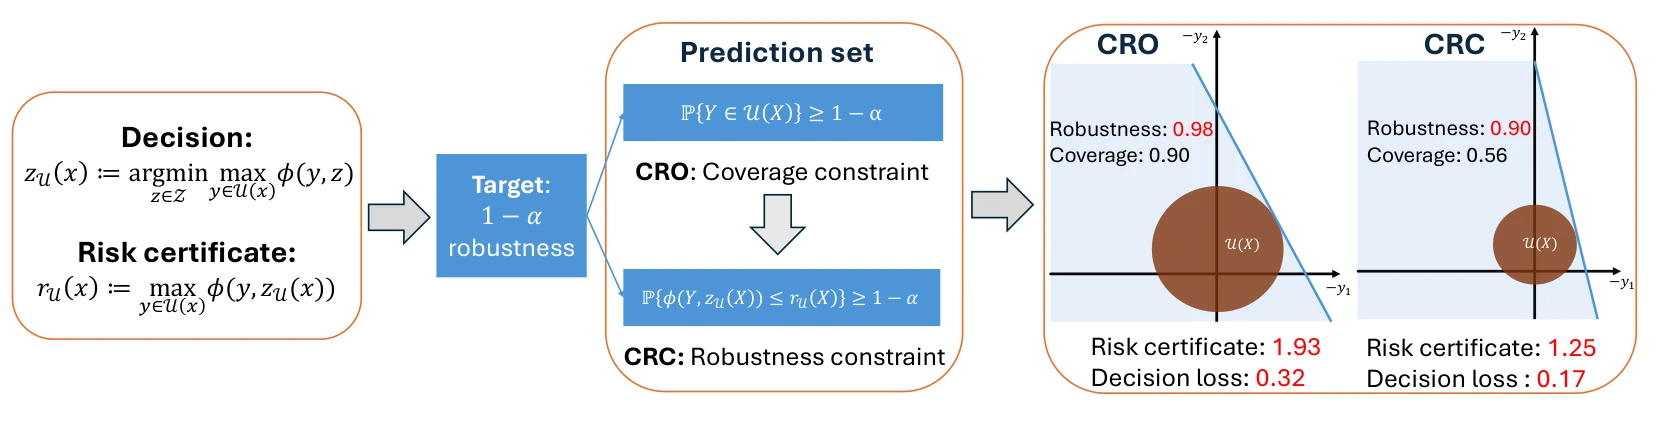
상황은 이렇다. 입력 \(X\)를 보고 결정 \(z\)를 고르면, 아직 모르는 결과 \(Y\)에 따라 손실 \(\phi(Y, z)\)가 생긴다. 의사결정자는 손실이 넘지 않을 한도, 곧 위험 한도(risk certificate) \(r(X)\)를 함께 내놓고, 그 약속이 90% 이상 지켜지기를 바란다. 이 확률을 논문은 강건성(robustness)이라 부른다(1절, 식 1).
지금까지의 표준은 조건부 강건 최적화(conditional robust optimization, CRO)였다. 컨포멀 예측(conformal prediction)으로 결과를 90% 담는 예측 집합을 만들고, 그 집합 안의 최악을 대비해 결정한다. 집합이 결과를 담으면 손실은 한도를 넘지 않으니 강건성 90%는 따라온다. 문제는 이것이 충분조건일 뿐 필요조건이 아니라는 점이다. 필요 이상으로 넓은 집합을 쓰게 되고, 결정은 지나치게 조심스러워진다.
논문 그림 1이 이 차이를 보여 준다. 두 자산에 나눠 투자하는 예에서 적중률(coverage) 90%짜리 원을 쓰면 실제 강건성은 98%로 목표를 한참 넘고 위험 한도는 1.93이다. 강건성을 딱 90%로 맞춘 원은 결과를 56%밖에 담지 않는데도 위험 한도가 1.25로 내려간다.
실제 데이터에서도 차이가 컸다. 미국 주식 15종목으로 포트폴리오를 짜는 실험에서 α = 0.1일 때 타원 집합 기준 위험 한도는 CRC가 1.028, CRO가 6.345, 종단 학습(E2E)이 4.995였다. 강건성은 각각 90.8%, 99.9%, 98.6%로, 기존 방법들은 목표보다 훨씬 조심스러웠다(5.2절, 표 1).
어떻게 보였나
방법의 뼈대는 단순하다. 예측 집합을 신경망으로 매개화하고(상자나 타원), 학습 데이터에서 위험 한도의 평균을 줄이되 “손실이 한도 이하인 비율이 90% 이상”이라는 제약을 건다(3.2절, 식 6). 이 비율은 지시함수라 미분이 안 되므로 오차함수로 매끄럽게 바꾸고, 라그랑주 승수와 번갈아 경사 하강을 한다(알고리즘 1). 집합에서 결정과 한도를 구하는 내부 문제는 볼록 최적화라서 cvxpylayers로 미분한다(부록 E.1).
왜 이득이 생기는지는 부록 B.3의 가우시안 예가 잘 보여 준다. 손실이 \(-y^\top z\)처럼 선형이면 손실은 결과를 결정 방향 한 축으로만 본다. 그러니 강건성에는 그 한 축의 90% 분위수만 있으면 되고, 적중률은 모든 방향을 다 담아야 한다. 결과의 차원이 커질수록 두 조건이 요구하는 크기는 벌어진다.
(가) 필요한 타원 크기
(나) 강건성을 맞춘 타원의 적중률
이론으로는 학습된 집합의 강건성이 목표에서 \(O(\sqrt{d \log n / n})\) 이상 모자라지 않고 위험 한도도 최적에 가깝다는 것을 보였다(정리 3.2, 3.3). 유한 표본에서 정확히 90%를 보장하려면 데이터를 나눠 한쪽으로 집합을 학습하고, 다른 쪽으로 집합의 크기를 컨포멀 방식으로 다시 맞추는 Cal-CRC를 쓴다(4절, 정리 4.1).
눈여겨볼 점
첫째, 유한 표본 보장을 얻는 데 드는 값이 작지 않다. 합성 데이터 비교에서 CRC만 쓰면 위험 한도가 8.660이지만 강건성이 89.5%로 목표에 조금 못 미친다. 보정을 거친 Cal-CRC는 강건성 90.9%를 지키는 대신 한도가 9.413으로 오르고, CRC 최적화 없이 사전 학습 모델만 보정한 경우의 9.581과 거리가 좁아진다(부록 E.7, 표 6). 보정을 거치면서 이득이 상당 부분 사라지는 셈이다.
둘째, 보장은 입력 전체에 대한 평균이다. 어떤 입력 구간에서는 90%를 크게 밑돌 수 있다. 리뷰에서도 조건부 보장으로 넓힐 수 있느냐는 질문이 나왔다. 정리 3.2의 오차항도 덮개 수와 립시츠 상수를 담고 있어서, 실제 크기의 신경망이라면 숫자로는 거의 쓸모없는 한계일 수 있다. 블로그의 해석으로는 이론은 방향을 보여 주는 정도이고, 설득력은 실험에서 나온다.
열린 질문
- 강건성을 평균이 아니라 입력마다, 또는 분포가 조금 바뀐 뒤에도 지키게 하면 적중률 대신 강건성을 거는 이득이 얼마나 남을까.
이해 확인
결과가 q차원 정규분포이고 손실이 선형일 때, 강건성 90%를 맞추는 타원이 적중률 90%를 맞추는 타원보다 작아도 되는 까닭은?
- 강건성은 학습 데이터에서만 재기 때문이다
- 타원 대신 상자를 쓰기 때문이다
- 손실이 결과를 결정 방향 한 축으로만 보므로, 그 축의 분위수만 맞추면 되기 때문이다
- 강건성 목표를 90%보다 낮게 잡았기 때문이다
선형 손실 \(-y^\top z\)에서 한도를 넘는지는 \(z\) 방향으로 투영한 한 값에만 달려 있다. 그래서 강건성 90%에는 표준정규분포의 90% 분위수 1.28배 타원이면 충분하다. 적중률 90%는 모든 방향을 담아야 해서 카이제곱 분위수가 필요하고, 차원이 커질수록 더 큰 타원이 든다(부록 B.3).
논문 정보
- 제목: Conformal Robustness Control: A New Strategy for Robust Decision
- 저자: Yang Hu, Haojie Ren (Shanghai Jiao Tong University), Jieren Tan, Changliang Zou, Yajie Bao (Nankai University)
- 학회: ICLR 2026 구두 발표(Oral)
- 링크: OpenReview