지나온 길을 점수 평균 하나로 기억하는 MCMC
방문 횟수 대신 d개 숫자로 반발을 거는 ICML 2026 스포트라이트 논문
Score-Repellent Monte Carlo: Toward Efficient Non-Markovian Sampler with Constant Memory in General State SpacesICML 2026 Spotlight
3줄 요약
- MCMC 사슬은 한 곳을 맴돌기 쉽다. 지나온 곳을 기억해 덜 간 곳으로 밀어 주는 비마르코프(non-Markovian) 샘플러는 분산을 크게 줄였지만, 상태마다 방문 횟수를 세야 해서 작은 그래프 같은 유한 공간에서만 쓸 수 있었다.
- 이 논문은 이력을 점수(score), 곧 로그 밀도의 기울기의 이동 평균 \(\theta\) 하나로 줄이고, 목표 분포를 \(e^{-\alpha\theta^\top s(x)}\)만큼 기울인다. 기억은 차원 수 \(d\)만큼의 숫자면 되고 정규화 상수가 필요 없어서, MH, MALA, HMC, 이산 샘플러 어디에나 씌울 수 있다.
- 확률 근사(stochastic approximation) 이론으로 추정량의 거의 확실한 수렴과 중심극한정리를 보였고, \(\theta\)의 극한 공분산이 \(O(1/\alpha)\)로 준다는 것도 증명했다. 다만 추정량 자체의 분산이 준다는 식은 가우시안 평균 추정 같은 특수한 경우에만 있다.
선정 이유
ICML 2026 스포트라이트 논문이고, 리뷰어 네 명이 모두 최종 5점을 줬다. 블로그의 연구 여지 지도에서 ’MCMC와 신경 샘플러’는 LLM 중심 주제를 뺀 109개 주제 가운데 1위이고, 10월 테마 ’샘플링과 생성 모델의 수학’의 중심에 있다.
- 전후로 아는 것이 달라졌나. 달라졌다. 이력을 쓰는 샘플러가 분산을 거의 0까지 줄일 수 있다는 결과는 유한 그래프에서만 성립했다. 이 논문은 같은 효과를 연속 공간과 거대한 이산 공간에서, 상태 수와 무관한 기억으로 얻을 수 있음을 보였다.
- 새 질문을 여는가. 연다. 이력을 무엇으로 요약해야 하는지가 곧바로 설계 문제가 된다. 점수 평균은 가장 단순한 선택일 뿐이다.
- 일반화될 근거가 있나. 있다. 목표를 바꾸는 방식이라 기본 샘플러를 가리지 않고, 실제로 MH, MALA, HMC, ULA, Gibbs-with-Gradients에 붙여 봤다.
- 증거가 주장만큼 강한가. 점근 이론은 탄탄하다. 실험은 10차원 벤치마크 두 개와 이미지 에너지 모델 정도라 규모가 작고, 반발 세기 \(\alpha\)를 잘못 고르면 오히려 나빠지는 경우도 논문 스스로 보여 준다.
왜 중요한가
MCMC 추정량의 분산은 표본끼리의 상관에서 온다. 사슬이 같은 영역을 맴돌면 표본이 많아도 정보는 적다. 그동안 이 문제는 주로 전이 규칙을 다듬어 풀었다. 이산 공간에서는 국소 정보를 쓰는 제안 분포, 연속 공간에서는 랑주뱅(Langevin) 계열의 기울기 정보와 비가역(nonreversible) 샘플러가 그 예다. 그러나 이 방법들에는 기억이 없어서, 이미 여러 번 다녀간 곳인지 사슬은 모른다(1장).
기억을 쓰는 쪽에서는 같은 연구진의 앞선 두 논문이 뚜렷한 결과를 냈다. 자기 반발 랜덤 워크(self-repellent random walk, SRRW, ICML 2023 최우수 논문)는 그래프에서 자주 들른 노드로는 덜 가도록 전이 확률을 바꿨고, 반발 세기 \(\alpha\)를 키우면 극한 분산이 \(O(1/\alpha)\)로 준다는 것을 보였다. 이력 기반 목표(history-driven target, HDT, ICML 2025)는 전이 규칙 대신 목표 분포를 바꿔 같은 효과를 냈다. 두 방법 모두 방문 비율, 곧 경험 측도 \(\hat\delta_n\)을 기억에 쓴다. 상태가 \(N\)개면 기억도 \(N\)칸이 필요하다. 784픽셀 이진 이미지라면 \(2^{784}\)칸이고, 연속 공간에서는 아예 정의가 되지 않는다(1장).
연속 공간에도 이력을 쓰는 방법은 있었다. 스타인 자기 반발 동역학(Stein self-repulsive dynamics)은 과거 표본 버퍼로부터 밀어내지만, 비용이 버퍼 크기에 비례하고 버퍼가 무한해야 치우침이 사라진다. 분자 시뮬레이션의 메타다이내믹스(metadynamics)나 적응 편향 힘(adaptive biasing force)은 반응 좌표를 골라 이산화하고 나중에 다시 가중치를 매겨야 한다. 기울기의 이동 평균으로 랑주뱅에 드리프트를 더하는 방법은 랑주뱅에만 쓸 수 있고 극한 분산 분석이 없다(1장). 그래서 이 논문은 묻는다. 상태 수와 무관한 작은 기억으로, 어느 샘플러에나 붙고 정규화 상수도 필요 없는 이력 기반 샘플러를 만들 수 있을까.
핵심 아이디어
직관: 잘 섞인 사슬의 점수 평균은 0이다
출발점은 스타인 항등식(Stein’s identity)의 가장 간단한 꼴이다. 목표 \(\pi\)의 점수를 \(s(x)=\nabla_x\log\pi(x)\)라고 하면, 부분적분으로 \(\mathbb{E}_{X\sim\pi}[s(X)]=0\)이 된다(2장). 사슬이 \(\pi\)를 고르게 돌았다면 지나온 점들의 점수 평균도 0 근처여야 한다. 평균이 0에서 벗어나 있다면 어딘가를 지나치게 오래 돌았다는 신호다.
그래서 이 논문은 점수의 이동 평균을 기억으로 쓴다(식 1).
\[ \theta_{n+1} = \theta_n + \gamma_{n+1}\big(s(X_{n+1}) - \theta_n\big),\qquad \gamma_n = (n+1)^{-\rho},\ \rho\in(\tfrac12, 1] \]
\(\rho=1\)이면 단순한 시간 평균이고, \(\rho<1\)이면 최근 표본에 무게를 더 준다. 어느 쪽이든 \(\theta\)는 \(d\)차원 벡터 하나다. 그리고 이 \(\theta\)로 목표를 기울인다(식 2).
\[ \pi_\theta(x) \;\propto\; \pi(x)\,\exp\{-\alpha\,\theta^\top s(x)\} \]
지나온 점수 방향과 같은 쪽을 가리키는 점, 곧 \(\theta^\top s(x)>0\)인 점은 가중치가 줄어든다. 가우시안 \(\pi=\mathcal N(\mu, V)\)에서는 이 기울임이 아주 선명하다. 점수가 \(-V^{-1}(x-\mu)\)라 지수 안이 \(x\)의 1차식이 되고, 제곱을 완성하면 \(\pi_\theta=\mathcal N(\mu+\alpha\theta, V)\)다(블로그의 해석, 부록 C.10의 점수 식에서 바로 나온다). 오른쪽을 오래 돈 사슬은 점수가 왼쪽을 가리키니 \(\theta\)가 음수가 되고, 목표는 그만큼 왼쪽으로 옮겨 간다.
(가) 점수 평균으로 남기는 기억
(나) 기억만큼 기울인 목표
방법: 어떤 샘플러에든 씌우는 껍데기
알고리즘 1은 단순하다. \(n\)번째 걸음에서 기본 커널이 \(\pi\) 대신 \(\pi_{\theta_n}\)을 목표로 한 걸음 가고, 그다음 \(\theta\)를 갱신한다. 핵심은 정규화 상수 \(Z_\theta\)가 필요 없다는 점이다. MH에서는 받아들일 확률에 인수 하나가 곱해질 뿐이다(식 4).
\[ a_\theta(x,y) = \min\Big\{1,\ \frac{\pi(y)\,q(y,x)}{\pi(x)\,q(x,y)}\, e^{-\alpha\theta^\top[s(y)-s(x)]}\Big\} \]
기울기를 쓰는 샘플러에서는 점수를 \(s_\theta(x) = s(x) + \alpha\nabla_x^2U(x)\,\theta\)로 바꿔 쓴다(식 5, \(U=-\log\pi\)). 헤세 행렬과 벡터의 곱이 필요한데, 자동 미분으로 계산하거나 \(\big(\nabla U(x+\epsilon\theta)-\nabla U(x)\big)/\epsilon\)처럼 기울기 두 번으로 근사한다(식 6). 이 곱이 SRMC가 연속 공간에서 치르는 추가 비용이다.
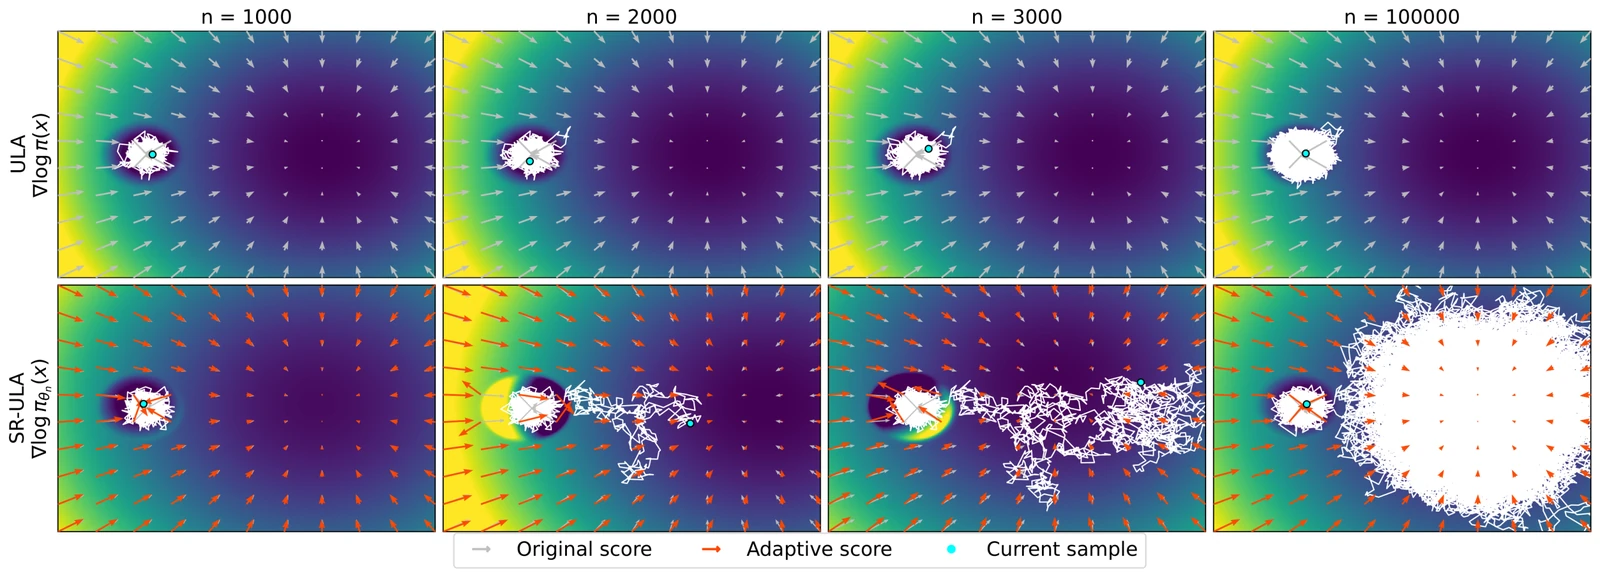
논문 그림 1은 이 장치가 사슬을 함정에서 꺼내는 모습이다.
수식: 무엇을 보장하나
SRMC는 기억 \(\theta_n\)과 추정량 \(\mu_n\)(시험 함수 \(f\)의 이동 평균)을 함께 갱신하는 확률 근사로 볼 수 있다(식 7). 평균장이 0이 되는 점은 \((\theta,\mu)=(0, \mathbb{E}_\pi f)\)이고, 거기서 야코비 행렬은 다음과 같다(식 11).
\[ A^\star = \begin{bmatrix} -I_d-\alpha\,\mathrm{Cov}_\pi(s,s) & 0\\ -\alpha\,\mathrm{Cov}_\pi(f,s) & -I_m\end{bmatrix} \]
정리 3.3은 점수가 립시츠이고 꼬리가 적당히 빨리 줄어든다는 가정(가정 1), 그리고 모든 \(\theta\)에서 기본 커널이 고르게 기하 에르고딕하고 \(\theta\)에 대해 립시츠라는 가정(가정 2) 아래, \((\theta_n,\mu_n)\)이 거의 확실히 \((0,\mathbb{E}_\pi f)\)로 수렴하고 중심극한정리를 따른다고 말한다. 기억이 0으로 가니 기울인 목표도 원래 \(\pi\)로 돌아가고, 추정량은 점근적으로 치우침이 없다. 극한 공분산은 리아푸노프 방정식(식 13)의 해다.
여기서 눈여겨볼 구조가 있다. 잡음 공분산 \(\Sigma_\Delta\)는 기본 사슬에서 정해지므로 \(\alpha\)와 무관하고, \(\alpha\)는 오직 \(A^\star\)를 거쳐 들어온다. \(\alpha\)를 키우면 \(\theta\) 쪽의 복원력 \(-I-\alpha\,\mathrm{Cov}_\pi(s,s)\)가 세진다. 명제 3.4는 이 효과를 정리해, \(\theta\)의 극한 공분산 \(\Sigma_{\theta\theta}(\alpha)\)가 \(\alpha\)에 대해 단조 감소하고 \(O(1/\alpha)\)로 준다고 말한다(증명은 부록 C.9).
추정량의 분산은 일반적으로 닫힌 꼴이 없다. 논문은 두 특수한 경우를 풀었다(3장). 매 걸음 \(\pi_\theta\)에서 독립으로 뽑으면 \(\Sigma_{\mu\mu}(\alpha)\)가 기본 샘플러보다 결코 크지 않고 \(O(1/\alpha)\)로 어떤 잔여 항에 다가간다. 목표가 가우시안이고 평균을 추정하면 \(X-\mu=-V s(X)\)라서 표본 평균이 \(\theta_n\)의 선형 변환이 되고, \(\Sigma_X(\alpha)=V\Sigma_{\theta\theta}(\alpha)V^\top=O(1/\alpha)\)가 된다. 1차원 표준 정규 분포에 \(\rho=1\)을 넣으면 이 식은 \(\tau/(1+2\alpha)\)가 된다. \(\tau\)는 기본 샘플러의 극한 분산이다. 실제로 돌려 보면 식과 거의 겹친다.
이산 공간에서는 연속 완화한 기울기의 평균이 0이 아닐 수 있어서, 이론대로라면 이산 스타인 점수 \(s_i(x)=\pi(x^{(i,K-x_i)})/\pi(x)-1\)(식 17)처럼 평균이 0인 특징을 써야 한다. 명제 3.6은 그런 점수를 쓰면 정리 3.3이 그대로 성립한다고 말한다.
결과 해설
연속 벤치마크. 상관계수 0.9의 10차원 상관 가우시안과, 관측 100개의 10차원 베이즈 로지스틱 회귀 사후 분포에서 평균 추정 오차를 쟀다(4.2절, 그림 2, 실행 100번). 기울기 평가 수와 CPU 시간 두 기준으로 비교했다. 가우시안에서는 MALA의 개선이 작고 HMC에서 \(\alpha=2, 5\)가 가장 좋았다. 로지스틱에서는 효과가 더 컸지만 \(\alpha\)에 민감해서, \(\alpha=1\sim2\)가 가장 좋고 \(\alpha=5\)는 MALA에서 거절률이 높아 갇히고 HMC에서도 내내 나빴다. 1장의 ’MSE 최대 5배 감소’는 이 가운데 잘 맞춘 경우의 수치다.
\(\alpha\)를 워밍업 동안만 키우다 고정하는 적응 규칙도 부록에서 시험했다(부록 D.1.4). HMC와 로지스틱 조합에서 10만 걸음 뒤 MSE가 고정 \(\alpha=2\)일 때 \(1.55\times10^{-3}\), \(\alpha=5\)일 때 \(1.94\times10^{-2}\)였는데, 적응 규칙을 쓰면 각각 \(1.12\times10^{-5}\), \(2.53\times10^{-3}\)으로 내려갔다. 저자들은 이것을 가장 좋은 고정값을 이기는 방법이 아니라 잘못 고른 \(\alpha\)로부터 지켜 주는 장치로 해석한다.
모드 탐색. CIFAR-10 학습 이미지 1,000장을 중심으로 둔 3,072차원 가우시안 혼합에서, 사슬 50개를 모두 같은 이미지에서 출발시키면 ULA는 5,000걸음 뒤에도 28개 모드(2.8%)만 찾았고 SR-ULA는 약 1,035걸음 만에 1,000개를 모두 찾았다(부록 D.2.1, 표). 사전 학습한 CIFAR-10 에너지 모델에서 사슬을 10개만 쓰면 마지막 표본이 덮은 클래스가 ULA 5개, SR-ULA 7개였다(부록 D.2.3).
이산 에너지 모델. 이진화한 MNIST(\(\{0,1\}^{784}\)) 에너지 모델에서 사슬 100개를 모두 같은 숫자 ‘7’ 이미지에서 출발시키고 1만 걸음을 돌렸다(4.3절, 그림 3). \(\alpha=10^{-4}\)의 SR-GWG는 2,500걸음 안에 첫 모드를 벗어났고, 1만 걸음 시점의 누적 KL은 0.68로 기본 GWG의 4.16보다 84% 낮았다. 한 시점의 사슬 100개가 얼마나 다양한지 재는 벤디 점수(Vendi score)는 2.6에서 6.4로 올랐다.
같은 함정을 MALA로 다시 돌려 보면. 논문 그림 1의 목표를 그대로 두고 기본 샘플러만 MALA로 바꿔 돌린 결과가 아래 그림이다. MALA는 각 \(\pi_\theta\)를 정확히 불변 분포로 두므로 이론의 가정에 맞는다. 반발이 셀수록 좁은 봉우리를 빨리 벗어난다. 사슬 절반이 벗어나는 데 \(\alpha=0\)은 약 17.7만 걸음, \(\alpha=3\)은 약 8만 걸음이 걸렸다. 그런데 \(\alpha=3\)은 벗어난 뒤 넓은 봉우리에 지나치게 오래 머물러서, 뒤쪽 25만 걸음 동안 오른쪽에서 보낸 시간이 참값 19.5%보다 높은 28.8%였다. 빨리 벗어나는 것과 올바른 비율로 머무는 것은 다른 문제이고, 논문의 불편성은 걸음이 무한할 때의 이야기다(블로그의 해석).
(가) 좁은 봉우리를 벗어난 사슬
(나) 오른쪽 봉우리에 머문 시간
의심해볼 점
- 점수 평균은 봉우리를 기억하지 못한다. 봉우리가 잘 떨어져 있으면 한 봉우리 안에서의 점수 평균도 거의 0이라, 어느 봉우리에 오래 있었는지는 \(\theta\)에 남지 않는다. 위 MALA 실험에서도 사슬이 좁은 봉우리에 갇혀 있는 동안 \(|\theta|\)는 0.02 안팎이었고 오른쪽을 가리키는 치우침도 없었다(블로그의 해석). 저자들도 반박문에서 단일 평균은 1차 방향의 불균형만 잡고, 봉우리별 점유 구조는 놓칠 수 있다고 인정했다.
- 보장은 점근적이다. 정리 3.3과 명제 3.4는 걸음 수가 무한할 때의 이야기다. 저자들도 결론에서 큰 \(\alpha\)가 보정 구간을 늘려 유한 시간 성능을 해칠 수 있다고 적었다. 로지스틱 실험의 \(\alpha=5\)와 위의 MALA 실험이 그 예다.
- 추정량 분산에 대한 일반 결과가 없다. \(O(1/\alpha)\)가 증명된 것은 기억 \(\theta\)의 공분산이다. 추정량으로 옮겨지는 것은 독립 표본과 가우시안 평균 추정 두 경우뿐이다.
- ULA 실험은 이론 밖이다. 가정 2는 커널 \(P_\theta\)가 \(\pi_\theta\)를 불변 분포로 둔다고 요구한다. 그림 1과 CIFAR-10 실험에 쓴 ULA는 이산화 오차 때문에 이 조건을 만족하지 않는다. 모드를 몇 개 찾았는지는 보여 줘도, 각 모드에 올바른 비율로 머무는지는 따로 확인해야 한다.
- 이산 실험은 근사다. MNIST 실험은 계산 비용 때문에 평균이 0이 아닐 수 있는 완화 기울기를 그대로 썼다. 저자들도 이것을 명제 3.6의 구현이 아니라 실용적 근사로 읽어야 한다고 적었다(4.3절).
- 비용. 유한 차분으로 헤세 곱을 근사하면 한 걸음 비용이 기본 샘플러의 약 3배다(부록 C.11). 차분 간격 \(\epsilon\)도 민감해서, 로지스틱 MALA의 MSE가 \(\epsilon=0.1\)일 때 \(2.46\times10^{-6}\)에서 \(\epsilon=10^{-5}\)일 때 \(1.15\times10^{-3}\)으로 나빠졌다(부록 D.1.4).
- 숫자 두 곳이 어긋난다. 부록 D.3.1은 누적 KL을 10개 클래스의 균등 분포 \(u\)에 대한 \(\mathrm{KL}(p_n\,\|\,u)\)로 정의하는데, 이 값은 \(\log 10\approx2.30\)을 넘을 수 없다. 그런데 본문의 기본 GWG 값은 4.16이고 그림 3의 시작값은 18 근처다. 다른 방향의 KL이나 다른 정규화를 쓴 것으로 보인다(블로그의 해석). 또 부록 D.1.1은 상관 가우시안 공분산의 조건수를 약 19라고 적었지만, \(\Sigma_{ij}=0.9^{|i-j|}\)인 10차원 행렬의 고유값은 약 7.31과 0.054라 조건수는 약 135다.
- 비교 대상이 기본 샘플러뿐이다. 병렬 템퍼링처럼 모드 탐색을 겨냥한 다른 방법과는 비교하지 않았다.
리뷰어들이 짚은 점
네 리뷰어 모두 5점을 줬고, 반박 뒤에는 모두 우려가 풀렸다고 답했다.
- 추정량 분산. 한 리뷰어는 \(O(1/\alpha)\)가 기억 쪽 결과일 뿐, 일반적인 추정량 분산이 어떻게 되는지는 불분명하다고 지적했다. 저자들은 \(\Sigma_{\mu\mu}\)가 추정량과 기억의 결합 항 \(C\Sigma_{\theta\mu}\)를 거쳐서만 \(\alpha\)에 반응한다는 식을 보이며 줄어드는 방향이라고 설명했지만, 일반 단조성 정리는 주장하지 않는다고 밝혔다.
- 연속 샘플러의 비용. ’추가 비용이 작다’는 주장이 연속 버전에는 과하다는 지적에, 저자들은 비용을 반영한 중심극한정리(부록 C.11)와 CPU 시간 그래프를 추가했다.
- 벤치마크 규모와 \(\alpha\) 조정. 10차원 벤치마크가 작고 \(\alpha\)를 세심하게 골라야 하는 것 아니냐는 질문에, 저자들은 CIFAR-10 실험을 근거로 들고 조정 지침(4.1절)과 적응 \(\alpha\)(부록 D.1.4)를 새로 넣었다.
- 이산 이론의 범위. 이론은 연속 공간에서 세웠는데 이산 실험은 완화 기울기를 쓴다는 지적에, 명제 3.6을 추가하고 MNIST 실험이 근사임을 명시했다.
계보
- 기억을 쓰는 샘플러. SRRW(Doshi, Hu, Eun, ICML 2023)가 그래프에서 방문 비율로 반발을 걸어 분산을 \(O(1/\alpha)\)로 줄였고, 분산 최적화로 넓힌 연구(Hu 외, ICLR 2024)를 거쳐, HDT(Hu 외, ICML 2025)가 전이 규칙 대신 목표를 바꾸는 방식을 만들었다. SRMC는 HDT의 목표 수정 원리를 이어받되 경험 측도 대신 점수 평균을 쓴다.
- 연속 공간의 이력 방법. 스타인 자기 반발 동역학(Ye 외, NeurIPS 2020), 메타다이내믹스와 적응 편향 힘, 왕-란다우(Wang-Landau)와 그 확률 근사판, 윤곽 확률 기울기 랑주뱅(Deng 외, NeurIPS 2020), 기울기 이동 평균으로 드리프트를 더하는 SGLD(Kim 외, 2022)가 가까운 선행 연구다.
- 도구. 제어된 마르코프 잡음을 갖는 확률 근사의 ODE 방법(Borkar 외, Annals of Applied Probability 2025)이 증명의 뼈대다. 이산 쪽은 이산 스타인 연산자(Shi 외, NeurIPS 2022)와 Gibbs-with-Gradients(Grathwohl 외, ICML 2021) 위에 서 있다.
- 같은 테마의 이전 글. 기울기만으로 거부 샘플링을 하는 논문은 기울기만으로 얼마나 정확하게 뽑을 수 있는지를 물었다. 이 논문은 같은 기울기를 기억으로도 쓸 수 있음을 보인다.
열린 질문
- 더 나은 기억. 점수 평균은 봉우리 안에서 거의 0이 된다. 여전히 크기가 작고 평균이 0인 다른 특징을 쓰면 어느 봉우리에 오래 머물렀는지까지 기억할 수 있을까.
- 유한 시간의 치우침. 반발이 빠른 탈출과 과잉 체류를 함께 부른다면, 주어진 걸음 수에서 둘의 균형을 재고 \(\alpha\)와 \(\rho\)를 정하는 원리적인 방법은 무엇일까. 유한 시간 이론이 가능할까.
- 생성 모델의 샘플링. 학습된 점수로 도는 확산 모델이나 에너지 모델의 샘플링에 붙이면 표본 다양성이 실제로 늘어날까. 신경망 점수의 헤세 곱 비용을 감안해도 이득이 남을까.
이해 확인
1. SRMC에서 기억 θ가 0으로 가야 옳은 목표로 돌아온다. θ의 올바른 평형점이 0인 까닭은?
- 이력 보폭 γ_n이 0으로 줄어들기 때문이다
- 반발 세기 α를 점점 줄여 0으로 보내기 때문이다
- 목표 π 아래에서 점수의 기댓값이 0이기 때문이다(스타인 항등식)
- 사슬이 결국 가장 높은 봉우리의 꼭대기에 머물기 때문이다
θ는 지나온 점수의 이동 평균이고, 사슬이 π를 고르게 돌면 그 평균은 E_π[s(X)] = 0으로 간다(2장). 평균장이 (0, E_π f)에서 0이 되는 것도 이 항등식 덕분이다(3장). γ_n이 줄어드는 것은 수렴 조건이지 평형점을 정하지 않고, α는 고정된 상수다.
2. 목표가 가우시안 N(μ, V)일 때, 점수로 기울인 목표 π_θ ∝ π exp(−α θᵀs)는 어떤 분포인가?
- 평균은 μ 그대로이고 분산이 1/(1+α)배로 줄어든 가우시안
- 공분산은 V 그대로이고 평균이 μ + αθ로 옮겨 간 가우시안
- 원래 봉우리와 옮겨 간 봉우리가 섞인 두 봉우리 분포
- 정규화 상수를 모르면 알 수 없는 분포
가우시안의 점수는 −V⁻¹(x − μ)라 지수 안의 −α θᵀs가 x의 1차식이 된다. 제곱을 완성하면 공분산은 그대로이고 평균만 αθ만큼 옮겨 간다. 오른쪽을 오래 돈 사슬은 θ가 왼쪽을 가리키므로 목표가 덜 가 본 왼쪽으로 옮겨 간다.
3. 이 논문이 일반적인 목표와 기본 샘플러에 대해 증명한 것은?
- 기억 θ의 극한 공분산이 α에 대해 단조 감소하고 O(1/α)로 준다
- 어떤 시험 함수의 추정량이든 극한 분산이 O(1/α)로 준다
- 주어진 걸음 수에서 MSE가 α에 대해 단조 감소한다
- 완화 기울기를 쓴 이산 샘플러도 점근적으로 치우침이 없다
명제 3.4가 보장하는 것은 θ 블록 Σ_θθ(α)다. 추정량 분산의 O(1/α)는 독립 표본과 가우시안 평균 추정에서만 나온다(3장). 유한 시간 성능은 로지스틱 실험의 α = 5처럼 오히려 나빠질 수 있고, 이산 이론은 평균이 0인 이산 점수를 쓸 때만 성립한다(명제 3.6).
논문 정보
- 제목: Score-Repellent Monte Carlo: Toward Efficient Non-Markovian Sampler with Constant Memory in General State Spaces
- 저자: Jie Hu (Oakland University), Lingyun Chen, Do Young Eun (North Carolina State University), Geeho Kim, Bohyung Han (서울대학교), Jinyoung Choi (UNIST)
- 학회: ICML 2026 Spotlight
- 링크: arXiv 2604.22948, OpenReview, 코드