ReLU 신경망이 나눈 조각은 이웃을 몇 개나 둘까
ICLR 2026 구두 발표 ‘Characterizing the Discrete Geometry of ReLU Networks’ 짧게 읽기
Characterizing the Discrete Geometry of ReLU NetworksICLR 2026 Oral
한 줄 요약
ReLU 신경망이 입력 공간을 나눈 선형 조각은 너비와 깊이가 아무리 커져도 평균 이웃 수가 입력 차원 \(d\)의 두 배를 넘지 않고, 한 조각에서 다른 조각까지 건너야 하는 면의 수에는 \(d\)와 상관없는 상한이 있다.
무엇이 달라졌나
ReLU 신경망은 구간마다 선형인 함수다. 입력 공간이 다면체(polyhedron) 조각으로 나뉘고, 조각 하나 안에서 신경망은 1차 함수처럼 움직인다. 지난 10여 년의 연구는 주로 이 조각이 최대 몇 개까지 생기는지를 셌다. 조각끼리 어떻게 맞붙어 있는지는 거의 알려지지 않았다.
이 논문은 조각을 점으로 두고, 면을 맞댄 두 조각을 선으로 이은 연결 그래프(connectivity graph)를 들여다본다. 완전 연결 ReLU 신경망이라면 너비와 깊이에 상관없이 조각들의 평균 이웃 수가 \(2d\) 이하다(정리 3.4). 첫 은닉층 뉴런이 \(d\)개 이상이면 모든 조각은 이웃이 적어도 \(d\)개다(정리 3.5). 그래프의 지름, 곧 가장 먼 두 조각 사이에 건너야 하는 면의 수는 층 너비의 최댓값 \(m\)과 은닉층 수 \(\ell\)에 대해 \((m+1)^\ell\) 이하다(정리 3.8, 부록 B). 조각 수는 \(d\)에 따라 지수적으로 늘어나지만 이 상한에는 \(d\)가 없다.
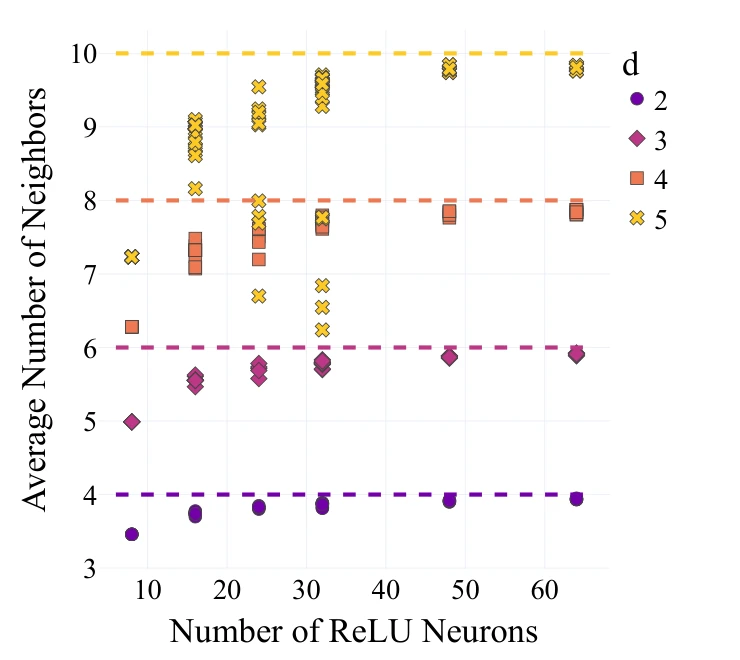
실험도 같은 쪽을 가리킨다. 합성 데이터로 학습한 은닉층 4개, 너비 16의 신경망에서 조각 수는 입력이 2차원일 때 평균 2,128개, 5차원일 때 약 503만 개다. 그런데 추정한 지름은 80.9와 70.9로 비슷하다(부록 표 3). 평균 이웃 수는 뉴런이 늘수록 \(2d\)로 빠르게 다가가서, 5차원 입력에 뉴런 64개면 9.80으로 상한 10 바로 밑이다(표 1).
어떻게 보였나
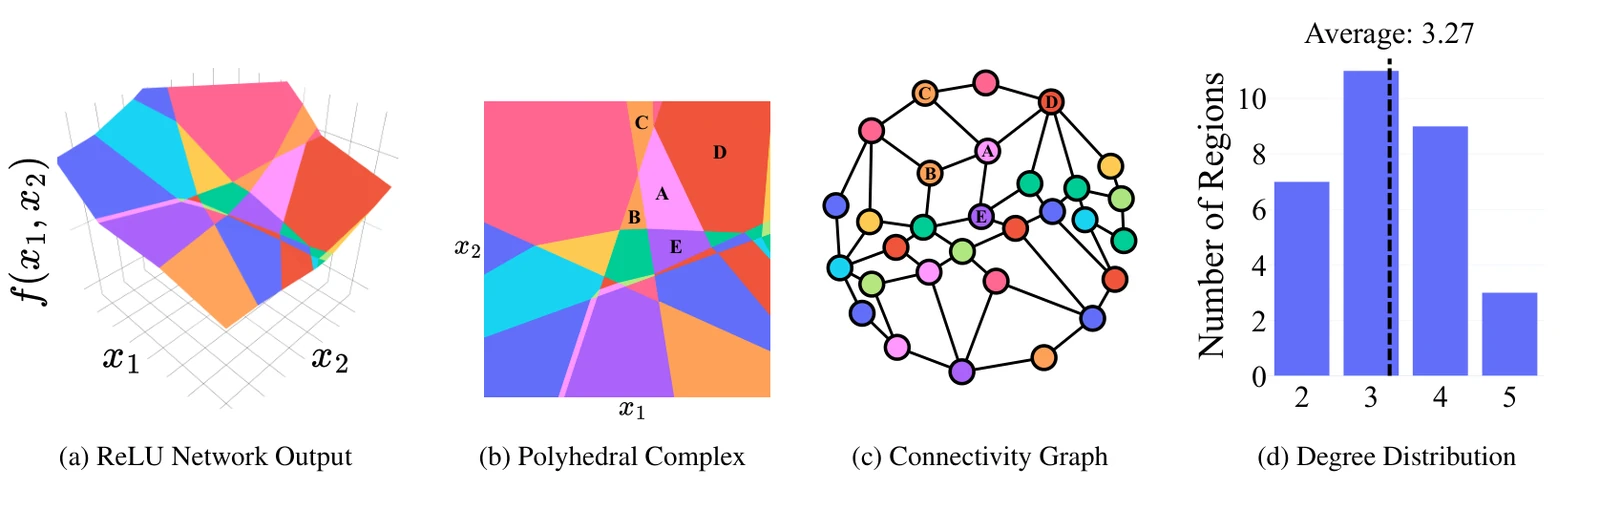
열쇠는 부호열(sign sequence)이다. 입력을 하나 넣으면 뉴런마다 활성화 전 값이 양수, 0, 음수 가운데 하나로 정해진다. 가중치가 특이한 값만 아니면 조각마다 서로 다른 부호열이 붙는다(2장). 어떤 뉴런의 경계, 논문 표현으로 굽은 초평면(bent hyperplane)을 넘으면 부호열에서 그 자리 하나만 뒤집힌다. 그러니 두 조각 사이의 면은 0이 딱 하나인 부호열과 같고, 면 하나를 두 조각이 나눠 쓰므로 평균 이웃 수는 \(2N_{d-1}/N_d\)가 된다. \(N_k\)는 \(k\)차원 조각의 수다.
증명은 마지막 층의 뉴런을 하나씩 지우는 귀납법이다. 뉴런 \(i\)의 경계 \(h_i\)를 지우면 그 경계로 갈라졌던 조각 두 개가 하나로 합쳐진다. 그래서 조각 수가 \(N_k(\mathcal C)=N_k(h_i)+N_k(\mathcal C-h_i)+N_{k-1}(h_i)\)로 나뉜다(보조정리 3.3). 경계 \(h_i\)는 그 자체로 한 차원 낮은 ReLU 복합체이므로, 뉴런이 하나 적은 \(d\)차원과 \(d-1\)차원의 경우만 가정하면 \(N_{d-1}\le d\,N_d\)가 따라 나온다. 층이 하나뿐인 신경망에서는 1991년에 알려진 결과였지만, 경계가 굽는 깊은 신경망에는 그 증명이 통하지 않았다.
지름 상한은 층을 차례로 따라간다. 첫 층의 경계는 평평한 초평면이라서 두 조각을 직선으로 이으면 경계마다 많아야 한 번 건넌다. 그 직선이 지나는 첫 층 조각은 많아야 \(m_1+1\)개이고, 각 조각 안에서는 둘째 층 경계도 평평하니 같은 논리가 되풀이된다. 이렇게 곱해 나가면 건너는 면의 수가 \(\prod_j (m_j+1)\)을 넘지 않는다.
눈여겨볼 점
첫째, 실험 규모가 작다. 합성 데이터 실험은 입력 2~5차원, 너비 16 이하, 은닉층 4개 이하다(5.1절, 부록 G). MNIST와 CIFAR10은 신경망 뒷부분만 떼어 5차원, 10차원 은닉 표현 위에서 조각을 셌고, CIFAR10과 캘리포니아 주택 데이터는 조각 800만 개에서 탐색을 멈췄다(5.2절). 지름도 정확히 잰 값이 아니라 위아래 추정치의 중간값이다(5.1절).
둘째, 지름 상한은 느슨하다. 너비 16, 은닉층 4개면 상한이 \(17^4=83{,}521\)인데 추정 지름은 입력 차원에 따라 71에서 82 사이다(부록 표 3). 저자들도 상한에는 거의 닿지 않고, 너비를 고정하면 지름이 상한의 로그에 가깝게 자란다고 적었다(5.1절). 이 결과에서 건질 것은 상한의 크기보다 \(d\)가 빠진다는 사실이다.
셋째, 가장 흥미로운 관찰은 정리 바깥에 있다. 학습 데이터가 들어 있는 조각은 이웃 수가 전체 평균의 상한 \(2d\)보다 많은 쪽에 몰린다(그림 6). MNIST에서는 학습이 진행될수록 이 쏠림이 짙어진다(부록 그림 14). 저자들은 이유를 아직 설명하지 못한다고 밝혔다(6장).
열린 질문
- 학습은 왜 데이터를 이웃이 많은 조각에 놓을까. 이웃 수가 일반화나 적대적 취약성과 이어지는지, 그리고 이 쏠림이 합성곱이나 잔차 연결을 쓰는 더 큰 신경망에서도 나타나는지가 다음 질문이다.
이해 확인
입력이 3차원인 완전 연결 ReLU 신경망의 너비와 깊이를 계속 키우면, 조각들의 평균 이웃 수는 어떻게 될까?
- 뉴런 수에 비례해 끝없이 늘어난다
- 6을 넘지 않고, 뉴런이 늘수록 6에 가까워진다
- 늘 3으로 같다
- 은닉층 수에 따라 지수적으로 늘어난다
정리 3.4에 따라 평균 이웃 수는 신경망 크기와 상관없이 2d = 6 이하다. 마지막 층에 뉴런을 더하면 평균이 커지기만 하고(정리 3.6), 은닉층이 하나인 신경망에서는 뉴런 수가 무한히 커질 때 정확히 2d로 수렴한다(정리 3.7). 깊은 신경망에서도 2d에 빠르게 다가가는 모습이 실험에서 보인다(그림 4). 3은 첫 은닉층 뉴런이 d개 이상일 때 어느 조각에서나 성립하는 이웃 수의 하한이다(정리 3.5).
논문 정보
- 제목: Characterizing the Discrete Geometry of ReLU Networks
- 저자: Blake B. Gaines, Jinbo Bi (University of Connecticut)
- 학회: ICLR 2026 구두 발표(Oral)
- 링크: arXiv 2606.07728, OpenReview, 코드