생성 궤적이 쓴 에너지는 표본에 대해 무엇을 알려 줄까
흐름 매칭의 궤적마다 운동 에너지를 재어 의미의 선명도와 학습 데이터 복사를 함께 설명하려 한 ICML 2026 스포트라이트 논문
A Kinetic Energy Perspective of Flow MatchingICML 2026 Spotlight
3줄 요약
- 흐름 매칭(flow matching) 모델은 잡음에서 출발한 점을 학습한 속도장을 따라 데이터까지 옮긴다. 이 논문은 궤적마다 속도의 제곱을 시간에 따라 더한 운동 경로 에너지(Kinetic Path Energy, KPE)를 재고, 에너지가 높은 표본일수록 클래스의 특징이 뚜렷하고 학습 데이터가 성긴 곳에 떨어진다고 보고한다.
- 그런데 에너지를 끝까지 올리면 오히려 학습 이미지를 베낀다. 학습 데이터에 딱 맞춘 닫힌 꼴 해는 속도에 \(1/(1-t)\) 인자가 있어 끝 무렵 에너지가 치솟고, 궤적이 학습 점으로 빨려 든다. 저자들은 이를 에너지가 모자라도 지나쳐도 안 된다는 골디락스 원리로 정리한다.
- 여기서 나온 운동 궤적 조형(Kinetic Trajectory Shaping, KTS)은 재학습 없이 초반 속도를 1% 올리고 후반 속도를 최대 2% 남짓 늦춘다. CelebA 소규모 실험에서 복사 비율을 37.34%에서 31.22%로, FID를 16.68에서 14.35로 낮췄다(표 4).
선정 이유
ICML 2026 스포트라이트 논문이다. 공개된 심사 기록에서 리뷰어 네 명의 최종 추천 점수는 5, 5, 5, 4였고, 프로그램 위원회는 물리적 관점이 분명하고 저자들이 반박 기간에 풀이기와 밀도 대리 지표에 대한 우려를 풀었다고 평했다.
블로그의 연구 여지 지도에서 ’플로우 매칭과 정규화 플로우’는 LLM 중심 주제를 뺀 109개 주제 가운데 3위로, 10월 테마 ’샘플링과 생성 모델의 수학’의 한 축이다.
- 전후로 아는 것이 달라졌나. 조금 달라졌다. 분포 전체를 보던 평가와 달리, 이 논문은 표본마다 궤적에서 덤으로 얻는 수치가 의미의 선명도, 주변 데이터의 밀도, 암기와 함께 움직인다는 경험적 증거를 모았다.
- 새 질문을 여는가. 연다. 에너지를 어느 시점에 쓰는지가 품질과 암기를 가른다는 주장은, 샘플러의 시간표를 표본 품질의 조절 장치로 보자는 제안이기도 하다.
- 일반화될 근거가 있나. 절반쯤 있다. ImageNet-256의 SiT-XL/2, CIFAR-10, CelebA에서 같은 방향의 상관이 나왔지만, 모두 결정론적 ODE 샘플러이고 이론은 학습 점의 혼합으로 본 닫힌 꼴 해에서만 성립한다.
- 증거가 주장만큼 강한가. 아직 아니다. 상관은 뚜렷하지만 인과는 보이지 않았고, 밀도는 손으로 고른 특징 공간에서 잰 대리 지표다. KTS의 효과도 1,024장짜리 CelebA에서 가장 크고 ImageNet에서는 작다.
왜 중요한가
흐름 매칭은 잡음 \(\epsilon\)과 데이터 \(z\)를 직선으로 잇는 \(x(t)=(1-t)\epsilon + tz\)를 따라가는 속도 \(z-\epsilon\)을 신경망 \(v_\theta\)에게 회귀로 배우게 한다(식 1, 2). 표본을 만들 때는 \(x(0)\)를 가우스 잡음에서 뽑아 \(dx/dt = v_\theta(x,t)\)를 \(t=1\)까지 적분한다.
같은 모델에서도 어떤 표본은 선명하고 어떤 표본은 흐릿하며, 어떤 표본은 학습 이미지를 거의 그대로 옮긴다. FID 같은 지표는 표본 수천 개를 한꺼번에 보기 때문에 이 차이를 설명하지 못한다. 저자들은 샘플링하는 동안 표본마다 덤으로 얻는 수치에서 실마리를 찾았다(1장).
핵심 아이디어
직관: 궤적마다 연료 계량기를 단다
고전역학에서 퍼텐셜이 없는 자유 입자의 작용(action)은 운동 에너지를 시간에 따라 적분한 값이다. 저자들은 샘플링 궤적을 속도장 위를 움직이는 입자로 보고 같은 양을 정의한다(3장, 식 5).
\[ E = \frac{1}{2}\int_0^1 \big\|v_\theta(x(t),t)\big\|^2\,dt \]
오일러 방법으로 적분하면 걸음마다 이미 계산한 \(\|v_\theta\|^2\)에 \(\Delta t\)를 곱해 더하기만 하면 되니 추가 비용이 거의 없다(부록 E). 표본 전체로 평균을 내면, 학습한 흐름이 최적 수송을 이룰 때 벤아무 브르니에(Benamou, Brenier)의 동적 공식에 따라 2-바서슈타인 거리와 이어진다(3.3절).
(가) 궤적 하나의 운동 경로 에너지
(나) 운동 궤적 조형의 속도 배율
그림 (가)가 보여 주듯 같은 두 끝점을 잇는 경로 중 직선을 같은 속도로 가는 경로가 에너지가 가장 작다. 코시 슈바르츠 부등식에서 바로 나오는 \(E \ge \tfrac12\|x(1)-x(0)\|^2\)이고, 논문의 명제 5.2(b)도 같은 부등식이다. KPE가 높다는 말은 멀리 갔거나, 돌아갔거나, 속도를 들쭉날쭉하게 썼다는 뜻이다.
방법: 두 가지 발견과 한 가지 역설
발견 1: 에너지가 높을수록 의미가 선명하다(4.1절). ImageNet-256에서 학습된 SiT-XL/2로 분류기 없는 안내(CFG) 세기 1.0, 1.5, 4.0마다 표본을 만들고 KPE 순서로 세 무리로 나눴다. CLIP 점수(이미지와 클래스 이름의 유사도)와 CLIP 여유(정답 클래스와 가장 가까운 오답 클래스의 유사도 차이)가 모두 에너지를 따라 올랐다. CFG 1.5에서 CLIP 점수의 중앙값은 23.52에서 25.12로, CLIP 여유는 7.05에서 10.02로 올랐다(4.1절). 하위 3분의 1과 상위 3분의 1의 차이는 여섯 비교 모두 본페로니 보정 뒤에도 유의했고 효과 크기(Cohen’s \(d\))는 0.45에서 0.65였다(표 1).
발견 2: 에너지가 높은 궤적은 성긴 곳에 떨어진다(4.2절). 끝점 주변에 학습 표본이 얼마나 모여 있는지를 k-최근접 이웃과 커널 밀도 추정으로 쟀다. CIFAR-10에서 KPE와 밀도의 스피어만 순위 상관은 적분 단계 수가 10, 50, 150으로 늘 때 −0.54, −0.61, −0.65였고, ImageNet-256에서는 −0.31에서 −0.42로 약했다(표 2). 특징 공간을 VAE 잠재 공간으로 바꾸면 ImageNet에서도 −0.74까지 강해졌다(표 3).
근거가 되는 이론은 정리 4.2다. 유한한 학습 점 \(x^{(1)},\dots,x^{(N)}\)에 딱 맞춘 경험적 흐름 매칭(empirical flow matching, EFM)의 최적 속도 \(\hat u^*\)는 중간 분포 \(\hat p_t\)의 점수로 쓸 수 있다(보조정리 4.1). 한 학습 점의 가중치가 \(1-\varepsilon\) 이상인 ‘사후 지배’ 조건에서 순간 속도의 제곱은 \(-\log \hat p_t(z)\)의 상수배 사이에 끼인다.
\[ c_1(t)\big(-\log \hat p_t(z)\big) - C_t' \;\le\; \big\|\hat u^*(z,t)\big\|^2 \;\le\; c_2(t)\big(-\log \hat p_t(z)\big) + C_t' \]
상수는 \(c_1 = \tfrac12 m(t)^2\sigma_t^2\), \(c_2 = 12\,m(t)^2\sigma_t^2\)로 잡을 수 있다(비고 4.3). 밀도가 낮은 곳을 지나는 궤적일수록 에너지가 쌓인다는 뜻이다.
역설: 에너지를 끝까지 올리면 베낀다(5장). 같은 EFM의 속도는 닫힌 꼴로 쓸 수 있다(식 10, Bertrand 외).
\[ \hat u^*(x,t) = \sum_{i=1}^{N} \lambda_i(x,t)\,\frac{x^{(i)} - x}{1-t} \]
\(\lambda_i\)는 \(x\)가 학습 점 \(i\)의 다리 위에 있을 사후 확률이다. 끝 무렵 가중치가 한 학습 점에 몰렸는데 궤적이 그 점에서 일정 거리 \(c\) 이상 떨어져 있으면 속도가 \(c/(2(1-t))\) 이상이 되어 에너지가 발산한다(보조정리 5.1). EFM은 학습 분포를 정확히 맞추는 해이므로 모든 표본이 학습 점 위에 떨어져야 하고, 늦게까지 간격이 남은 궤적은 막판에 에너지를 몰아 쓰며 학습 점으로 끌려간다.
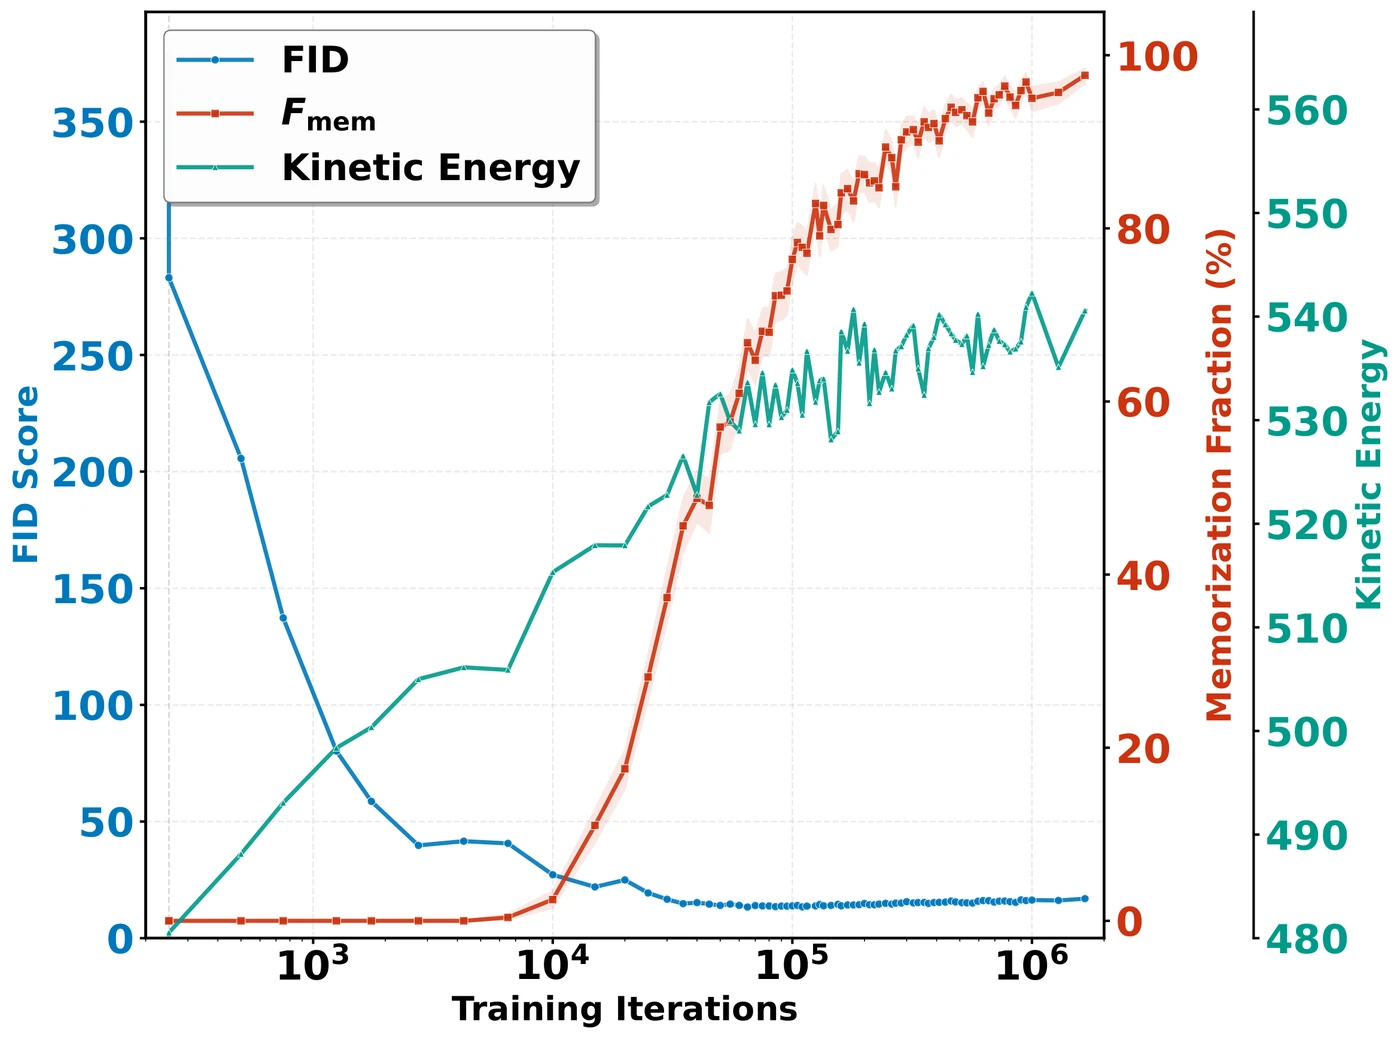
실험도 이와 맞았다. 2차원 합성 데이터 세 가지에서 EFM의 최대 파워는 신경망의 1.3배에서 3.9배였고 KPE도 30~50% 높았다(5.3.1절). 1,024장짜리 CelebA에서 U-Net 흐름 매칭 모델을 오래 학습하면, FID는 약 \(10^4\)번 학습 뒤 약 15에서 멈추는데 복사 비율과 평균 KPE는 계속 올라 200만 번 부근에서 복사 비율이 98%에 이르렀다(5.3.2절, 그림 7).
수식: 운동 궤적 조형
두 결과를 합친 처방은 이렇다. 초반 에너지는 의미를 만드는 데 쓰이니 늘리고, 막판 에너지는 복사를 부르니 줄인다. KTS는 학습한 속도에 시간에 따른 배율 \(\eta(t)>0\)을 곱한다(식 12~15).
\[ \tilde v(x,t) = \eta(t)\,v_\theta(x,t),\qquad \eta(t) = \begin{cases} 1 + \alpha_0\big(1 - t/\tau\big), & t < \tau \\ 1 - \beta_0\big(e^{k(t-\tau)} - 1\big), & t \ge \tau \end{cases} \]
\(\tau = 0.6\)은 합성 데이터에서 파워가 치솟기 시작한 구간 \([0.5, 0.7]\)에서 골랐고 \(k=3\)이다(6.1절). 기본값 \(\alpha_0=\beta_0=0.01\)에서 배율은 1에서 2.5% 넘게 벗어나지 않는다(부록 I). 속도의 방향은 그대로 두고 크기만 바꾸므로, 모델에 넣는 시간 \(t\)까지 바꾸는 시간 재매개화와는 다르다고 저자들은 설명한다(6.1절).
결과 해설
CelebA 32×32(표 4). 30,000번 학습한 시점의 모델에서 기준선은 FID 16.68, 복사 비율 37.34%였다. 연착륙만 켜면 복사가 줄지만 품질이 무너진다. \(\beta_0 = 0.02\)에서 복사 비율은 19.36%까지 내려갔으나 FID가 86.56이 됐다. 발사만 켜면 반대다. \(\alpha_0 = 0.02\)에서 FID는 11.27로 가장 좋았지만 복사 비율은 36.78%로 거의 그대로였다. 둘을 함께 켠 \(\alpha_0=\beta_0=0.01\)이 FID 14.35, 복사 비율 31.22%로 두 지표를 모두 개선했다. 복사 비율은 가장 가까운 학습 이미지까지의 픽셀 거리가 두 번째 이미지까지 거리의 3분의 1 미만인 표본의 비율이다(식 16).
분할 시점을 0.2나 0.4로 당기면 복사는 더 줄지만 FID가 60.31, 48.58로 나빠졌고, 0.8로 늦추면 FID 21.07, 복사 비율 34.30%였다(표 6). 발사와 연착륙의 함수 꼴을 선형, 상수, 지수로 바꿔도 FID는 11.72에서 14.35 사이로 모두 기준선보다 좋았지만, 복사 비율이 크게 준 것은 논문이 쓴 선형과 지수 조합뿐이었다(표 7). 풀이기(오일러, 중점법), 단계 수(100, 250), 시간 간격(균등, 코사인)을 바꾼 여섯 설정에서 복사 비율은 매번 6~10%포인트 줄었다(표 8). 매 걸음 속도에 가우스 잡음을 더하는 방법은 \(\sigma = 0.01\)에서 FID 37.33, 복사 비율 33.25%로 KTS보다 못했다(표 11).
ImageNet-256(표 5). 기준선 FID 11.70, CLIP 24.11에서 균형 설정은 FID 11.63, CLIP 24.20이었다. \(\alpha_0 = 0.05\)는 FID 11.59, CLIP 24.34, 정밀도 0.731로 가장 좋았지만 재현율이 0.655에서 0.630으로 떨어졌다. 초반에 에너지를 더 쓰면 선명도를 얻고 다양성을 조금 잃는다.
의심해볼 점
- 밀도는 대리 지표다. 발견 2의 밀도는 RGB 통계, 가보르 필터 응답, 경계 밀도로 만든 22차원 특징을 PCA로 2차원에 줄인 뒤 잰 값이다(4.2절). 저자들도 이것이 데이터 다양체의 밀도가 아니라 특정 표현 공간에서의 국소적 성김이라고 인정했다. 정리 4.2의 밀도 \(\hat p_t\)는 끝점 주변의 학습 데이터 밀도가 아니라 궤적이 지나는 순간의 중간 분포 밀도라는 점도 다르다. 상수 비 \(c_2/c_1=24\)도 넓다.
- KPE는 먼저 이동 거리를 잰다(블로그의 해석). \(E \ge \tfrac12\|x(1)-x(0)\|^2\)이므로 KPE에는 궤적이 얼마나 멀리 갔는지가 크게 섞인다. 논문 그림 1의 고에너지 표본이 모두 대상이 화면을 채운 근접 사진이라는 점을 보면, 화면 구성이나 대비처럼 끝점 자체의 성질이 에너지와 CLIP 점수를 함께 움직였을 수 있다. 이동 거리를 뺀 나머지 에너지로도 같은 상관이 나오는지는 논문이 확인하지 않았다.
- 상관의 방향이 데이터 배치에 달려 있다(블로그의 해석). 논문 부록 F의 설정대로 2차원 데이터 두 가지에 작은 신경망을 학습해 보면, 성긴 고리가 바깥에 있는 데이터에서는 논문과 같은 음의 상관이 나오지만 성긴 영역이 가운데에 있는 데이터에서는 부호가 뒤집힌다. 원점 근처에서 출발한 잡음이 가운데로 가며 거의 움직이지 않기 때문이다. 논문 그림 3의 둘째 줄은 반대로 나오는데, 원점에서 먼 바깥 무리로 가는 궤적이라면 위 부등식 때문에 에너지가 0.1 안팎이기 어렵다. 어느 쪽이 맞는지는 저자 코드로 확인해 볼 일이다.
(가) 빽빽한 핵과 성긴 고리
(나) 성긴 가운데와 빽빽한 네 무리
- EFM의 메커니즘이 신경망의 메커니즘인가(블로그의 해석). 보조정리 5.1은 궤적이 모든 학습 점에서 일정 거리 떨어져 있다고 가정한다. 그러나 닫힌 꼴 해의 ODE를 그대로 풀면 한 학습 점에 가중치가 몰린 뒤 간격은 \(1-t\)에 비례해 줄고 속도는 일정해진다. 에너지 폭발은 궤적이 학습 점에 닿지 못하는 경우의 이야기다. 신경망 모델의 복사가 같은 막판 고속 운동 때문이라는 직접 증거는 그림 7의 학습 곡선이 거의 전부이고, 거기서 평균 에너지는 약 480에서 540으로 12% 남짓 올랐을 뿐이다.
- 연착륙이 왜 복사를 줄이는가(블로그의 해석). 속도를 상수배 \(\eta\)로 줄여도 닫힌 꼴 해에서는 간격이 \((1-t)^{\eta}\)에 비례해 여전히 0으로 간다. 연속 시간에서는 연착륙이 학습 점으로 끌려가는 것 자체를 막지 못한다는 뜻이다. 2차원 예에서도 닫힌 꼴 해의 복사 비율은 연착륙을 세게 걸수록 오히려 조금 늘었다(아래 그림). CelebA에서 복사가 준 이유는 이산화된 마지막 걸음에 남는 잔차나 신경망 속도장의 다른 성질에서 찾아야 할 수 있다.
(가) 시간에 따른 순간 파워
(나) 연착륙과 복사 비율
- 실험 규모와 기록의 차이. KTS의 효과가 뚜렷한 곳은 1,024장짜리 CelebA이고 ImageNet의 FID 개선은 0.07이다. 발견 1의 표본 수는 본문에 CFG마다 5,000개(4.1절), 부록에 4,000개(부록 E)로 다르게 적혀 있고, 5.3.2절의 CelebA는 64×64, 6장은 32×32다.
리뷰어들이 짚은 점
- 풀이기 의존성. 한 리뷰어는 KPE가 이산화된 적분이라 단계 수와 풀이기에 흔들릴 수 있다고 봤다. 저자들은 오일러와 호인 방법, 단계 수 50, 100, 200의 여섯 조합에서 표본별 KPE 순위의 스피어만 상관이 모두 0.992 이상이라고 답했다(부록 G, 표 9).
- 밀도 표현. 두 리뷰어가 ’저밀도 영역’이라는 표현이 대리 지표에 비해 강하다고 지적했고, 저자들은 ’표현 공간의 국소적 성김’으로 고치겠다고 답했다.
- 비단조성의 증명. 한 리뷰어는 에너지와 품질의 뒤집힌 U자 관계를 수학적으로 이은 증명이 없다고 짚었다. 저자들은 ’품질’을 연속 시간 동역학에 묶어 엄밀하게 정의하는 일은 범위 밖이라고 인정했다.
- EFM과 신경망의 간극, 경쟁 방법 비교, 분할 시점의 근거. 리뷰어들은 닫힌 꼴 해의 결론이 실제 신경망에 얼마나 옮겨 가는지, 다른 암기 완화 방법과 비교했는지, \(\tau = 0.6\)을 어떻게 골랐는지 물었다. 저자들은 표 6~8과 잡음 주입 비교(표 11)를 더했고, 리뷰어 세 명이 우려가 풀렸다며 점수를 올렸다.
계보
- 흐름 매칭. Lipman 외(2022)와 Liu 외(2022)의 흐름 매칭과 정류 흐름(rectified flow), Albergo 외(2023)의 확률적 보간이 출발점이다. 에너지로 확률 경로를 설계한 Shaul 외(2023)와 달리, 이 논문은 학습된 모델이 표본마다 실제로 쓴 에너지를 본다.
- 닫힌 꼴 해와 암기. Bertrand 외(2025)는 흐름 매칭의 닫힌 꼴 해가 학습 점만 되풀이한다는 점과 일반화가 목표의 무작위성에서 오지 않는다는 점을 보였다. Bonnaire 외(2025)는 확산 모델이 학습 초반에 일반화하고 오래 학습하면 암기한다는 시간 척도를 분석했고, 이 논문의 CelebA 설정과 복사 비율 지표도 여기서 왔다. 공저자 Lim의 동시 연구(arXiv 2512.16768)는 경험적 흐름 매칭의 유한 표본 편향을 다룬다.
- 동시기 연구. 흐름 매칭의 닫힌 꼴 속도장이 초반의 여러 모드를 향한 항해와 후반의 가장 가까운 표본으로 다듬기, 두 단계로 나뉜다는 분석(arXiv 2512.02826)은 KTS의 두 구간과 같은 직관을 공유한다. 궤적의 기하로 암기를 탐지하려는 시도로는 상태 전이 행렬의 특잇값을 추적하는 연구(arXiv 2607.12616)가 있다.
- 같은 테마의 이전 글. 확산 모델이 서로 다른 데이터에서도 같은 그림을 그리는 이유를 다룬 랜덤 행렬 이론 논문 해설은 모델이 무엇을 일반화하는지를, 몇 걸음짜리 흐름 모델에 가역성 벌점을 더한 논문 해설은 흐름 모델의 궤적을 확률 계산에 쓰는 법을 다룬다.
열린 질문
- 에너지의 어느 부분이 신호인가. 이동 거리로 설명되는 몫과 궤적이 굽거나 속도가 흔들려 생기는 몫을 나누면, 의미의 선명도와 데이터의 성김은 각각 어느 쪽과 이어질까.
- 신경망 모델의 암기는 막판 고속 운동에서 오는가. 복사된 표본과 새 표본의 순간 파워를 시간대별로 비교하면, 닫힌 꼴 해에서 본 막판 급등이 실제 모델에서도 암기의 표지가 될까.
- 확률적 샘플러와 다른 경로. 잡음을 넣는 샘플러나 직선이 아닌 확률 경로에서도 에너지를 초반과 후반에 나눠 쓰는 원리가 성립할까.
이해 확인
1. 경험적 흐름 매칭의 닫힌 꼴 해에서 끝 무렵 에너지가 폭발할 수 있는 이유는?
- 신경망이 속도장을 과소적합해 속도가 커지기 때문이다
- 끝 무렵 여러 학습 점의 가중치가 고르게 섞이기 때문이다
- 속도에 1/(1 − t) 인자가 있어서, 가중치가 한 학습 점에 몰렸는데 간격이 남아 있으면 속도가 c/(1 − t) 꼴로 커지기 때문이다
- 오일러 방법의 보폭이 끝으로 갈수록 커지기 때문이다
닫힌 꼴 해는 신경망 없이 학습 점만으로 쓴 속도다(식 10). 보조정리 5.1은 가중치가 한 학습 점에 몰리고 궤적이 모든 학습 점에서 c 이상 떨어져 있으면 속도가 c/(2(1 − t)) 이상이 되어 끝 무렵 에너지 적분이 발산함을 보인다. 가중치가 고르게 섞이는 것은 오히려 초반의 모습이다.
2. 운동 궤적 조형(KTS)이 샘플링에서 바꾸는 것은?
- 모델을 다시 학습해 막판 속도를 줄이도록 만든다
- 학습한 속도에 시간에 따른 양의 배율 η(t)를 곱해, 방향은 두고 크기만 초반에는 키우고 후반에는 줄인다
- 매 걸음 속도에 가우스 잡음을 더해 궤적을 흩뜨린다
- 모델에 넣는 시간 t 자체를 바꿔 시간 간격을 다시 나눈다
KTS는 재학습 없이 ṽ = η(t) v_θ를 쓰고, t < 0.6에서는 η > 1, 그 뒤로는 η < 1이다(식 12~15). 모델에 넣는 시간은 그대로라 단순한 시간 재매개화와 다르고, 잡음 주입은 비교 대상으로 따로 실험됐다(표 11).
3. 발견 2의 “고에너지 궤적은 성긴 곳에 떨어진다”에서 실험이 실제로 잰 밀도는?
- 픽셀 공간에서 정확히 계산한 데이터 분포의 확률 밀도
- 정리 4.2의 중간 혼합 분포 밀도를 끝점에서 계산한 값
- 복사 비율을 잴 때 쓰는 가장 가까운 이웃 거리의 비
- 손으로 고른 이미지 특징(또는 VAE 잠재)을 줄인 표현 공간에서 k-최근접 이웃과 커널 밀도 추정으로 잰 학습 표본의 국소 밀도
실험의 밀도는 22차원 이미지 특징을 PCA로 줄인 공간에서 k = 50 최근접 이웃과 커널 밀도 추정으로 잰 상대 순위용 대리 지표다(4.2절, 표 3). 저자들도 이것이 데이터 다양체의 보정된 밀도가 아니라고 밝혔다.
논문 정보
- 제목: A Kinetic Energy Perspective of Flow Matching
- 저자: Ziyun Li, Huancheng Hu, Soon Hoe Lim, Xuyu Li, Fei Gao, Enmao Diao, Zezhen Ding, Michalis Vazirgiannis, Henrik Boström
- 학회: ICML 2026 Spotlight
- 링크: arXiv 2602.07928, OpenReview