NeurIPS 2025 Oral, Best Paper Award
Why Diffusion Models Don’t Memorize: The Role of Implicit Dynamical Regularization in Training
확산 모델은 먼저 배우고, 한참 뒤에야 베낀다
암기가 시작되는 시점이 데이터 수에 비례해 늦어진다는 것을 실험과 랜덤 행렬 이론으로 보인 NeurIPS 2025 최우수 논문
딥러닝의 과학
3줄 요약
- 확산 모델(diffusion model)이 학습 손실을 끝까지 줄이면 학습 데이터만으로 정해지는 경험적 점수(empirical score)에 닿고, 학습 이미지를 그대로 다시 만든다. 그런데 실제 모델은 대개 그러지 않는다. 이 논문은 그 까닭을 학습 동역학에서 찾는다.
- CelebA로 학습한 U-Net에서 좋은 표본이 나오기 시작하는 시점 \(\tau_\mathrm{gen}\)은 데이터 수 \(n\)과 상관없이 약 10만 걸음이지만, 학습 이미지를 베끼기 시작하는 시점 \(\tau_\mathrm{mem}\)은 \(n\)에 비례해 늦어진다(2장, 그림 2). 그 사이에서 멈추면 매개변수가 아주 많은 모델도 베끼지 않는다.
- 랜덤 특징(random features) 모델로 풀면 학습의 시간 척도는 특징 상관 행렬 고윳값의 역수이고, 이 스펙트럼이 \(n\)과 무관한 덩어리와 \(1/n\)로 작아지는 덩어리로 갈라진다(정리 3.2). 두 시간 척도는 여기서 나온다.
선정 이유
NeurIPS 2025 최우수 논문상(Best Paper Award) 네 편 가운데 하나이고 구두 발표(oral) 논문이다. 선정위원회는 데이터 수와 무관한 일반화 국면과 데이터 수에 비례하는 암기 국면을 정량적으로 짚고, 랜덤 특징 모델의 스펙트럼을 랜덤 행렬 이론으로 풀어 그 근거를 댄 기초 연구라고 평했다.
블로그의 연구 여지 지도에서 이 논문이 속한 ’확산 모델 이론과 샘플링’은 LLM 중심 주제를 뺀 109개 주제 중 16위이고, 10월 테마 ’샘플링과 생성 모델의 수학’에 속한다.
- 전후로 아는 것이 달라졌나. 달라졌다. 그동안 암기를 막는 힘은 주로 망의 구조, 용량, 학습률에서 찾았다. 이 논문은 언제 멈추느냐가 암기를 가르고 그 시점이 데이터 수에 비례함을 보였다. 일찍 멈추기 자체는 새롭지 않고, 새로운 것은 비율과 그 출처다.
- 새 질문을 여는가. 연다. 어떤 표본이 먼저 베껴지는지, 옵티마이저가 두 시간 척도를 어떻게 옮기는지, 클래스마다 시간이 다른지가 곧바로 질문이 됐다. 2026년 10월 기준 Semantic Scholar 인용은 95편이다.
- 일반화될 근거가 있나. 어느 정도 있다. 자연 이미지와 합성 데이터, U-Net과 MLP, SGD와 Adam, 조건부 생성에서 같은 비례가 나왔다(부록 A, B). 다만 32×32 흑백 이미지와 매개변수 1,600만 개 이하의 작은 규모다.
- 증거가 주장만큼 강한가. 비례 관계는 \(n\)과 너비를 바꾼 18개 모델에서 곡선이 한데 모이는 모습으로 보였다(부록 A.1). 이론은 확산 시간을 고정하고 첫 층을 얼린 랜덤 특징 모델이라, U-Net의 \(\tau_\mathrm{mem}\)이 같은 메커니즘에서 나온다는 것까지 증명하지는 않는다.
왜 중요한가
확산 모델은 노이즈를 섞는 과정을 거꾸로 돌려 이미지를 만들고, 그러려면 노이즈 섞인 분포의 로그 밀도 기울기, 곧 점수(score)가 필요하다. 점수는 노이즈를 맞히는 회귀 문제로 배운다(식 3, 4). 그런데 학습 데이터 \(n\)개로 만든 손실을 함수 전체에서 최소화하면 답은 학습 점들을 중심으로 한 가우시안 혼합의 점수가 된다(식 5).
\[ P_t^\mathrm{emp}(\mathbf{x}) = \frac{1}{n\,(2\pi\Delta_t)^{d/2}} \sum_{\nu=1}^{n} \exp\!\Big(-\frac{\lVert \mathbf{x}-\mathbf{x}^\nu e^{-t}\rVert^2}{2\Delta_t}\Big), \qquad \Delta_t = 1-e^{-2t} \]
이 점수로 생성하면 궤적이 학습 점 하나로 빨려 들어간다. 같은 연구진은 앞선 연구에서 \(n\)이 차원에 대해 지수적으로 크지 않으면 이 붕괴를 피할 수 없다고 보였다. 손실을 완벽히 줄인 모델은 반드시 베낀다.
실제로는 암기가 \(n\)이 작을 때만 보이고, 데이터가 지수적으로 많아지기 훨씬 전에 사라진다. 지금까지는 그 까닭을 망 구조의 귀납 편향, 한정된 용량, 유한한 학습률에서 찾았다. 저자들은 이런 장치가 모두 있는 모델에서도 같은 전이가 일어난다는 데 주목하고, 남은 후보로 학습 과정 자체를 본다(1장). 상용 모델이 학습 이미지를 재현한 사례가 있고 우주론이나 기후처럼 데이터가 귀한 분야도 있어, 언제 멈출지는 실용적인 문제이기도 하다.
핵심 아이디어
직관: 매끈한 부분을 먼저, 뾰족한 부분은 나중에
노이즈가 작고 \(n\)이 클 때 경험적 점수는 학습 점마다 날카로운 봉우리가 선 울퉁불퉁한 함수다. 이 함수는 모집단 점수에 가까운 매끈한 성분과 데이터마다 다른 뾰족한 성분으로 나눠 볼 수 있다. 신경망은 낮은 주파수를 먼저 배우는 스펙트럼 편향(spectral bias)이 있어서, 먼저 매끈한 보간에 이르러 모집단 점수 근처에 오래 머물고 한참 뒤에야 뾰족한 성분까지 맞추며 암기로 넘어간다(1장).
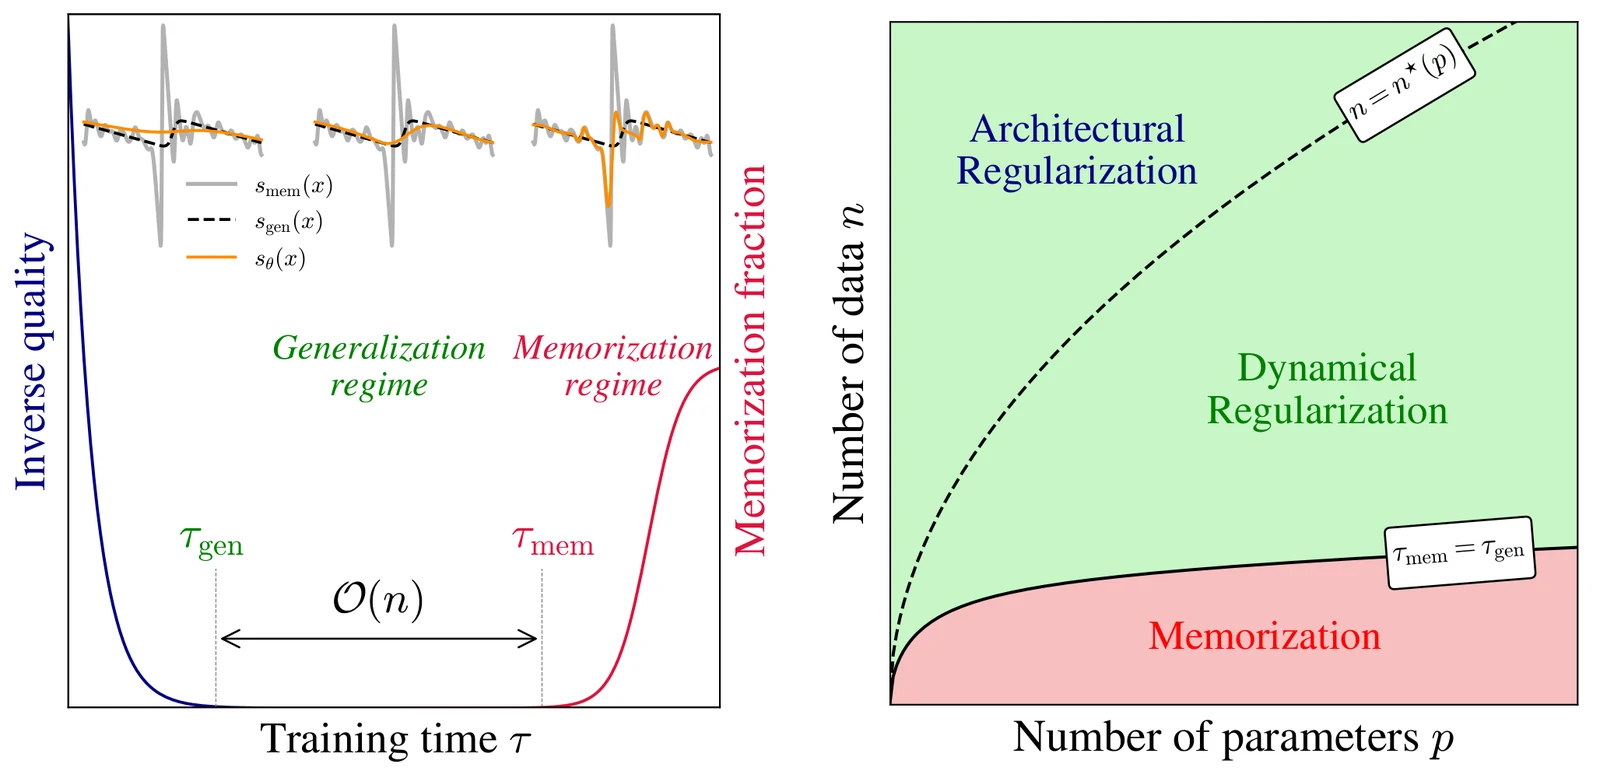
그림 1 오른쪽이 논문이 그리는 큰 그림이다. 데이터가 \(n^\star(p)\)보다 많으면 모델이 경험적 점수를 표현하지 못해 아무리 오래 학습해도 베끼지 않는다(구조적 정규화, architectural regularization). 그보다 적으면 베낄 능력은 있지만 \(\tau_\mathrm{gen}\)과 \(\tau_\mathrm{mem}\) 사이에 멈추면 베끼지 않는다(동역학적 정규화, dynamical regularization). 이 구간이 \(n\)에 비례해 넓어지면서 일반화 영역이 크게 넓어진다.
방법: 생성 품질과 암기를 함께 잰다
실험은 CelebA 얼굴을 32×32 흑백으로 줄인 이미지로 하고, 학습 데이터 수 \(n\)은 128부터 32,768까지다. 점수 모델은 세 해상도 단계의 U-Net이고 기본 채널 수 \(W\)로 크기를 조절한다. 노이즈를 맞히는 DDPM을 배치 \(\min(n, 512)\)의 모멘텀 SGD(학습률 0.01, 모멘텀 0.95)로 학습하며, 지수 이동 평균(EMA)과 학습률 예열은 쓰지 않는다(2장, 부록 A.1).
학습 걸음 수 \(\tau\)마다 두 가지를 잰다. 생성 표본 1만 장과 시험 이미지 1만 장의 FID가 바닥에 닿는 때가 \(\tau_\mathrm{gen}\)이다. 생성 이미지에서 가장 가까운 학습 이미지까지의 거리가 두 번째로 가까운 학습 이미지까지의 거리의 1/3보다 작으면 베낀 것으로 세고(식 6), 그 비율 \(f_\mathrm{mem}\)이 0에서 오르기 시작하는 때가 \(\tau_\mathrm{mem}\)이다. 기준을 1/2, 1/4로 바꿔도 비례는 같았다. 여기에 확산 시간 \(t = 0.01\)에서 잰 학습 손실과 시험 손실을 함께 본다.
수식: 학습 시간 척도는 고윳값의 역수다
이론은 George, Veiga, Macris의 랜덤 특징 모델을 따른다(3장). 점수를 두 층 망으로 두되, 첫 층 가중치 \(\mathbf{W}\in\mathbb{R}^{p\times d}\)는 가우시안으로 뽑아 얼리고 둘째 층 \(\mathbf{A}\)만 경사 하강법으로 학습한다(식 7).
\[ \mathbf{s}_{\mathbf{A}}(\mathbf{x}) = \frac{\mathbf{A}}{\sqrt{p}}\,\sigma\!\Big(\frac{\mathbf{W}\mathbf{x}}{\sqrt{d}}\Big) \]
확산 시간 \(t\)를 하나로 고정하고, \(d, p, n\)을 키우면서 \(\psi_p = p/d\), \(\psi_n = n/d\)를 고정한 고차원 극한을 본다. 손실이 \(\mathbf{A}\)의 이차 함수라서 경사 흐름(식 10)에 닫힌 해가 있다(부록 명제 C.1). 처음에 \(\mathbf{A}=0\)이면 다음과 같다.
\[ \frac{\mathbf{A}(\tau)}{\sqrt{p}} = -\frac{1}{\sqrt{\Delta_t}}\,\mathbf{V}^\top\mathbf{U}^{-1}\Big(\mathbf{I} - e^{-\frac{2\Delta_t}{\psi_p}\mathbf{U}\tau}\Big) \]
\(\mathbf{U}\)는 노이즈 섞인 학습 데이터로 계산한 특징 상관 행렬(\(p\times p\))이고, 고유 방향마다 고윳값 \(\lambda\)에 비례하는 속도로 바닥에 다가가므로 학습의 시간 척도는 \(\psi_p/(\Delta_t\lambda)\)이고, 스펙트럼의 모양이 언제 무엇을 배우는지를 정한다.
저자들은 레플리카 방법(replica method)으로 스펙트럼 방정식을 얻고(정리 3.1), \(\psi_p > \psi_n \gg 1\)인 과매개변수화 영역에서 이를 풀었다(정리 3.2).
\[ \rho(\lambda) = \Big(1-\frac{1+\psi_n}{\psi_p}\Big)\,\delta(\lambda - s_t^2) + \frac{\psi_n}{\psi_p}\,\rho_1(\lambda) + \frac{1}{\psi_p}\,\rho_2(\lambda) \]
- 델타 봉우리. 손실에 영향을 주지 않는 방향이다.
- 둘째 덩어리 \(\rho_2\). 모집단 상관 행렬 \(\tilde{\mathbf{U}} = \mathbb{E}_{\mathbf{X}}[\mathbf{U}]\)의 스펙트럼과 같아서 \(n\)과 상관없고, 고윳값이 \(\psi_p\) 규모다. 시간 척도는 \(1/\Delta_t\) 규모로 이것이 \(\tau_\mathrm{gen}\)이다. 이때는 학습 손실과 시험 손실이 함께 내려가고, 둘의 차는 \(O(1/\sqrt{\psi_n})\)로 작다(부록 명제 C.2).
- 첫째 덩어리 \(\rho_1\). 고윳값이 \(\big[s_t^2 + v_t^2(1-\sqrt{\psi_p/\psi_n})^2,\ s_t^2 + v_t^2(1+\sqrt{\psi_p/\psi_n})^2\big]\)에 놓인다(\(s_t^2\), \(v_t^2\)는 활성화 함수와 \(t\)로 정해지는 상수). \(p \gg n\)이면 고윳값이 \(\psi_p/\psi_n\) 규모라서 가장 느린 시간 \(\tau_\mathrm{mem} = \psi_p/(\Delta_t\lambda_\mathrm{min})\)이 \(\psi_n/\Delta_t\) 규모, 곧 \(n\)에 비례한다. 이때 학습 손실은 내려가고 시험 손실은 올라간다.
\(n > p\)이면 모델이 경험적 점수를 표현하지 못해 그림 1의 구조적 정규화로 넘어간다(\(n^\star(p) = p\), 3장).
(가) 데이터 n개
(나) 데이터 4n개
블로그의 해석으로는 \(\rho_1\)의 고윳값이 \(1/n\)로 작아지는 까닭을 이렇게 읽을 수 있다. 손실은 학습 표본 \(n\)개의 평균이라 표본 하나는 손실에 \(1/n\)만큼만 들어간다. 표본 하나에만 해당하는 성분을 맞추려는 힘도 그만큼 약하니, 그 방향의 바닥은 \(n\)에 비례해 완만해진다. 부록의 가우시안 등가식(보조정리 C.1)에서도 표본마다 다른 무작위 성분은 \(\mathbf{G}\mathbf{G}^\top/n\) 꼴로 들어간다.
이 모델을 작게 돌려 보면 고유 방향이 빠른 무리와 느린 무리로 갈리고, 데이터를 여덟 배로 늘리면 느린 무리만 오른쪽으로 밀려난다.
(가) 고유 방향의 이완 시간
(나) 데이터 수와 두 시간 척도
결과 해설
두 시간 척도(2장, 그림 2). 매개변수를 400만 개(\(W=32\))로 고정하면 FID는 \(n\)과 상관없이 약 10만 걸음에서 바닥에 닿는다. \(f_\mathrm{mem}\)은 한동안 0이다가 \(\tau_\mathrm{mem}\)부터 오르는데, 시간을 \(n\)으로 나눠 그리면 곡선이 한데 모여 \(\tau/n \approx 300\) 근처에서 올라간다. \(n=1024\)일 때 19만 걸음에서는 \(f_\mathrm{mem}=0\%\)에 FID 35.1이었지만, 162만 걸음에서는 생성 표본의 47.2%가 학습 이미지를 베꼈다(부록 A.1).
손실로 보면 더 일찍 드러난다. 학습 손실과 시험 손실이 갈라지는 시점도 \(n\)에 비례하고, 점수를 충분히 과적합해야 표본이 베껴지므로 늘 \(\tau_\mathrm{mem}\)보다 조금 앞선다. \(n=32{,}768\)에서는 1,100만 걸음을 학습해도 두 손실이 거의 붙어 있었다.
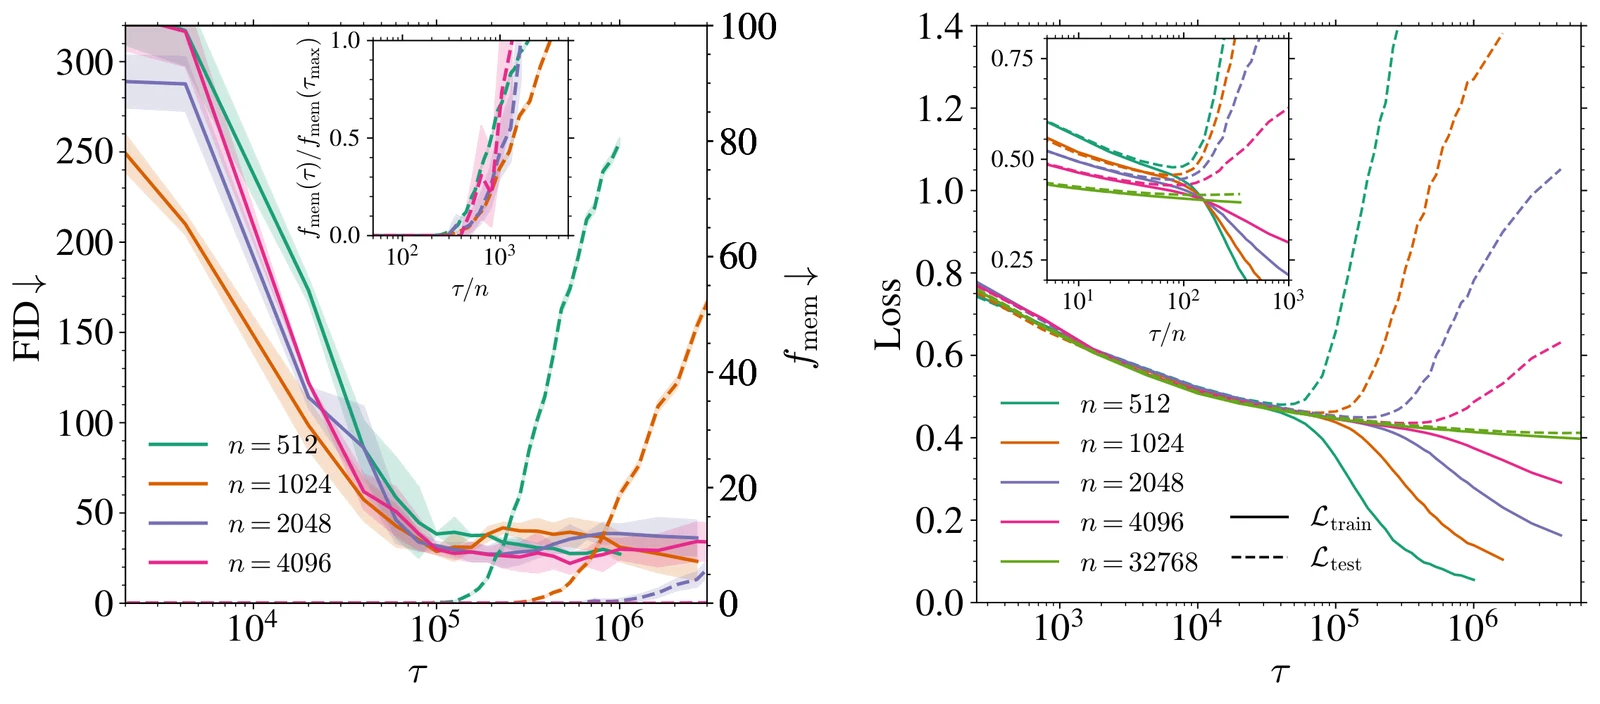
같은 표본을 자주 봐서가 아니다(부록 A.2). 전체 배치(\(B=n\))로 학습하면 \(\tau\)걸음 뒤 모든 표본을 정확히 \(\tau\)번씩 본 셈인데도 \(\tau_\mathrm{mem}\)은 \(n\)에 비례했다. 데이터 수가 바꾸는 것은 노출 횟수가 아니라 손실 지형이다.
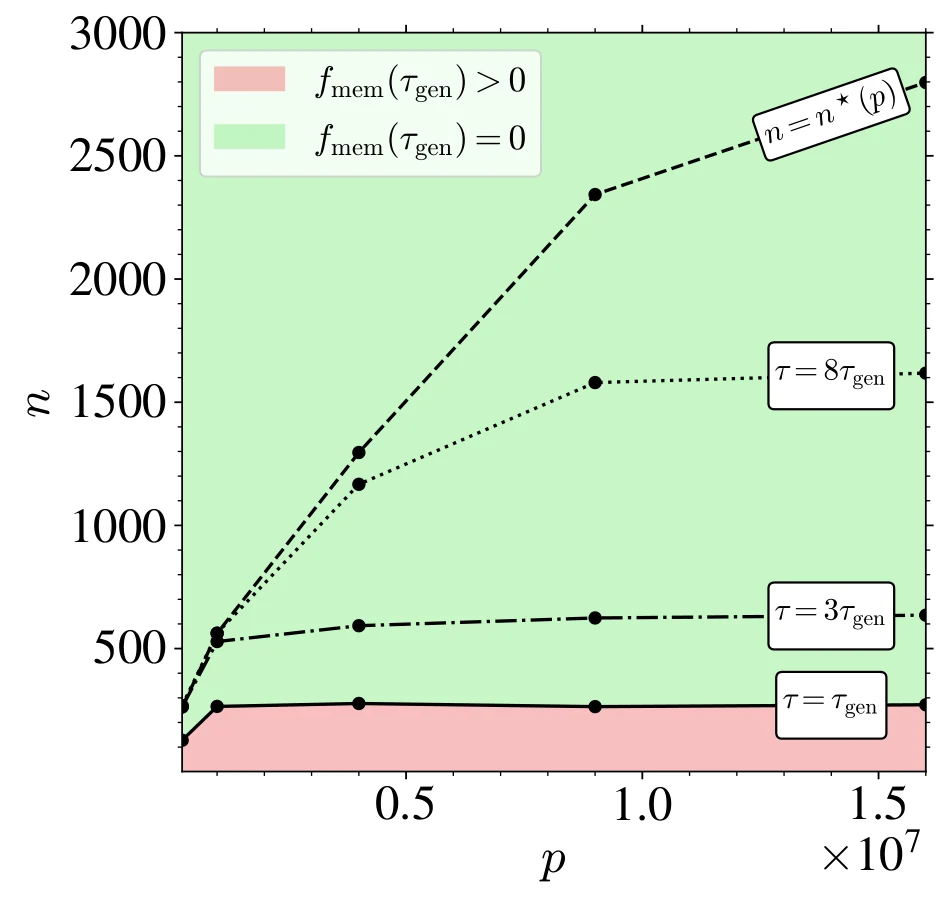
망의 크기(그림 3). 너비 \(W\)를 8부터 64까지(매개변수 26만에서 1,600만 개) 키우면 좋은 표본도, 베끼기도 일찍 온다. \(\tau_\mathrm{gen} \propto W^{-1}\), \(\tau_\mathrm{mem} \propto nW^{-1}\)이라 두 시점이 같아지는 데이터 수 \(n_\mathrm{gm}\)은 \(W>8\)에서 \(p\)와 거의 상관없다. 학습을 \(\tau_\mathrm{gen}\)의 3배, 8배까지 끌면 암기 없이 버티는 최소 데이터 수가 \(p\)와 함께 올라가 경계 \(n^\star(p)\)로 다가간다.
다른 설정에서도(부록 A.3, B). Adam(학습률 \(10^{-4}\))으로 바꾸면 같은 두 국면이 훨씬 적은 걸음 안에 나타났고 \(\tau_\mathrm{mem} \propto n\)도 유지됐다. 8차원 가우시안 혼합을 작은 MLP로 학습하면 KL 발산을 직접 잴 수 있는데, KL은 \(n\)과 무관한 시간에 0 가까이 내려갔다가 \(n\)에 비례하는 시간에 다시 올랐다. 분류기 없는 안내 모델에서도 암기 곡선이 \(\tau/n\) 위에서 겹쳤다.
이론과 수치(3장, 그림 5). 랜덤 특징 모델(\(d=100\), \(\psi_p=64\))에서도 시간을 \(\psi_p/(\Delta_t\lambda_\mathrm{min})\)로 나누면 손실 곡선이 겹치고, 오래 학습할수록 전이선이 올라가 U-Net 국면도와 같은 모양이 된다.
의심해볼 점
- 작은 규모와 단순한 학습법. 32×32 흑백 CelebA, 매개변수 1,600만 개 이하, 고정 학습률의 SGD에 EMA 없이 학습했다(부록 A.1). 실제 모델은 Adam, EMA, 잠재 공간, 텍스트 조건을 쓴다. 저자들도 옵티마이저, 조건부 생성, 좁은 \(p\) 범위를 한계로 적었다(4장).
- 암기를 재는 자. \(f_\mathrm{mem}\)은 픽셀 공간의 최근접 이웃 거리 비라서 통째 복제만 세고, 부분 복제는 잡지 못한다.
- 비례의 근거. 그림 2 왼쪽의 비례는 \(n\) 네 값(512부터 4,096까지)의 곡선이 겹치는 모습으로 보였고, 지수를 맞추고 오차를 붙이지는 않았다. 블로그의 해석으로는 “대략 선형”으로 읽는 것이 안전하다. 랜덤 특징 모델에서도 선형 비례는 \(p \gg n\)의 극한에서 나온다.
- 이론과 실험 사이. 이론은 첫 층을 얼리고 확산 시간마다 모델을 따로 학습하며, 수치 확인은 등방 가우시안 데이터다. U-Net은 모든 시간에 모델 하나를 쓰고 특징을 학습한다. 스펙트럼 방정식은 엄밀하지 않은 레플리카 방법으로 얻었고, 최종 결과는 자유 랜덤 행렬 방법으로 따로 확인했다(부록 C).
- \(n\)과 무관한 것은 시간뿐이다. 랜덤 특징 모델에서 빠른 단계 끝의 점수 오차는 \(\psi_n^{-0.59}\) 정도로 줄어든다(부록 D, 수치 추정). 데이터가 많으면 품질은 좋아지고, 거기 이르는 시간만 같다.
리뷰어들이 짚은 점
OpenReview에 공개된 심사에서 리뷰어 네 명 모두 최종 5점(수락)을 줬다.
- 실무에 무엇을 바꾸나. 한 리뷰어는 실제 대형 모델은 \(\tau_\mathrm{mem}\)에 닿지 않거나 구조적 정규화 영역에 있을 테니 실무에 주는 지침이 없다고 봤다. 저자들은 대형 모델의 부분 복제 사례와 데이터가 귀한 과학 분야를 들며 일찍 멈추기와 용량 조절을 제시했고, 리뷰어는 그 통찰은 이미 알려져 있었다면서도 수락을 유지했다.
- 빈칸 메우기. 그림 3에 구조적 정규화 경계가 없다는 지적에 저자들은 \(W=48\)을 더해 \(n^\star(p)\) 선을 그려 넣었다. 옵티마이저, 조건부 모델, 꼬리가 두꺼운 데이터에 대한 질문에는 Adam 실험, 분류기 없는 안내 실험, 임의 공분산으로 넓힌 스펙트럼 계산을 더해 답했다.
- 단순한 모델. 한 층만 학습하는 모델의 한계를 짚자, 저자들은 깊은 망의 신경 접선 커널(neural tangent kernel, NTK) 극한이 랜덤 특징 모델로 옮겨진다며 확장을 진행 중이라고 밝혔다.
계보
- 암기의 관찰. Carlini 외(USENIX Security 2023)와 Somepalli 외(CVPR 2023)가 대형 모델의 학습 이미지 재현을 보였고, 1/3 기준은 Gu 외와 Yoon 외(2023)에서 왔다.
- 경험적 점수의 이론. Biroli, Bonnaire, de Bortoli, Mézard(Nature Communications 2024)가 정확한 경험적 점수의 붕괴를 보였고, 이 논문은 실제 모델이 왜 거기에 닿지 않느냐를 묻는다.
- 다른 설명과 같은 시기 연구. Kadkhodaie 외(ICLR 2024)와 Kamb, Ganguli(2024)는 망의 귀납 편향과 용량에서, Wu 외(2025)는 큰 학습률에서 일반화의 출처를 찾았다. George, Veiga, Macris(AISTATS 2026)는 같은 랜덤 특징 모델을 끝까지 학습한 극한에서 풀었고, 이 논문은 여기에 학습 시간을 더했다. Favero, Sclocchi, Wyart(TMLR 2025)는 같은 비례 법칙을 독립적으로 보고했다.
- 후속. 저자들은 후속편(arXiv 2609.35377)에서 신경 접선 커널의 그람 행렬에서 같은 두 덩어리를 찾았고, 느린 덩어리가 표본마다 노이즈를 여러 번 뽑아 쓰는 데서 생긴다고 밝혔다. Nicoletti 외(arXiv 2605.06367)는 클래스마다 분산과 표본 수가 다를 때 일반화와 암기 시점이 클래스별로 갈린다는 것을 계산했다.
- 이 블로그의 이전 글. 확산 모델의 일관성 논문은 일반화 국면에서 모델들이 무엇을 공유하는지 다뤘다. 선형 회귀의 그로킹 논문은 순서가 반대로, 학습 데이터를 먼저 맞히고 일반화가 늦게 온다. 블로그의 해석으로는 둘 다 빠른 방향과 느린 방향이 갈리는 이야기이고, 느린 방향에 무엇이 담기느냐가 순서를 정한다.
열린 질문
- 실제 학습 조건에서 구간은 얼마나 넓은가. Adam과 EMA, 학습률 일정, 잠재 공간, 텍스트 조건이 들어간 학습에서 \(\tau_\mathrm{mem}/\tau_\mathrm{gen}\)은 어떻게 바뀌고, 큰 모델은 실제로 \(\tau_\mathrm{mem}\) 근처까지 가는가.
- 누가 먼저 베껴지는가. 암기 시점이 표본이나 클래스마다 따로 정해진다면 무엇이 그것을 정하는가. 흩어진 표본이 먼저 베껴진다는 결과와 전형적인 표본이 먼저라는 결과가 함께 나와 있다.
- 랜덤 특징 너머의 이론. 특징을 학습하고 모든 확산 시간을 함께 배우는 망에서 느린 덩어리는 어떻게 생기고, 확산 시간마다 두 시간 척도는 어떻게 달라지는가.
이해 확인
1. 랜덤 특징 모델에서 τ_mem이 데이터 수 n에 비례하는 직접적인 까닭은?
- 데이터가 많으면 표본 하나를 덜 자주 보기 때문이다
- 표본마다 다른 성분을 담은 고유 방향(ρ₁)의 고윳값이 ψ_p/ψ_n 규모라, 시간 척도 ψ_p/(Δ_t λ)가 n에 비례하기 때문이다
- 모집단 상관 행렬의 고윳값(ρ₂)이 n이 클수록 작아지기 때문이다
- 학습률을 n에 반비례하게 줄였기 때문이다
고유 방향마다 시간 척도는 ψ_p/(Δ_t λ)다. 정리 3.2에서 ρ₂는 n과 무관해 빨리(τ_gen) 끝나고, ρ₁은 p ≫ n일 때 고윳값이 ψ_p/ψ_n 규모라 가장 느린 시간이 n에 비례한다. 노출 횟수 설명은 전체 배치 실험(부록 A.2)에서 배제됐다.
2. 전체 배치(B = n)로 학습해도 τ_mem이 n에 비례했다는 결과가 배제하는 설명은?
- 일찍 멈추면 암기를 피할 수 있다는 설명
- 망이 클수록 일찍 암기한다는 설명
- 데이터가 많을 때 암기가 늦는 것은 표본 하나를 되풀이해 보는 횟수가 적어서라는 설명
- 경험적 점수로 생성하면 학습 이미지를 재현한다는 설명
전체 배치에서는 τ걸음 뒤 모든 표본을 정확히 τ번씩 본다. 노출 횟수가 같은데도 τ_mem은 n에 비례했으니, 데이터 수가 바꾸는 것은 손실 지형이다(부록 A.2). 나머지 보기는 이 실험과 상관없는 내용이다.
3. U-Net의 너비 W를 키우면 두 시간 척도는 어떻게 바뀌었나?
- 둘 다 W에 반비례해 짧아져서, 두 시점이 같아지는 데이터 수 n_gm은 p와 거의 상관없었다
- τ_gen만 짧아지고 τ_mem은 그대로여서 구간이 넓어졌다
- 둘 다 길어져서 큰 망일수록 늦게 베꼈다
- τ_mem이 더 이상 n에 비례하지 않게 됐다
그림 3 왼쪽의 B, D 패널에서 τ_gen ∝ W⁻¹, τ_mem ∝ nW⁻¹로 곡선이 겹쳤다. 두 시간의 비가 W와 무관하니 τ_mem = τ_gen이 되는 n_gm도 W > 8에서 p와 거의 상관없다(2장).
논문 정보
- 제목: Why Diffusion Models Don’t Memorize: The Role of Implicit Dynamical Regularization in Training
- 저자: Tony Bonnaire, Raphaël Urfin, Giulio Biroli (LPENS, Université PSL), Marc Mézard (Bocconi University)
- 학회: NeurIPS 2025 구두 발표(Oral), 최우수 논문상(Best Paper Award)
- 링크: arXiv 2505.17638, OpenReview, 코드