ICML 2026 Spotlight
Why Deep Jacobian Spectra Separate: Depth-Induced Scaling and Singular-Vector Alignment
층을 쌓으면 야코비안의 특이값은 왜 벌어질까
학습 동역학
한 줄 요약
무작위 가중치와 0/1 대각 행렬(게이트)을 번갈아 곱하면 로그 특이값이 깊이에 비례해 저마다 다른 기울기로 변해 스펙트럼이 지수적으로 벌어지고, 벌어진 스펙트럼은 중간 곱들의 특이벡터를 맞춘다. 이 두 성질을 가정하면 균형 가정 없이도 깊은 선형 신경망의 특이값 동역학과 배율만 다른 식이 나온다.
무엇이 달라졌나
깊은 선형 신경망에서는 특이값이 학습 중 어떻게 움직이는지 알려져 있다. 이웃한 두 층이 \(W_{\ell+1}^\top W_{\ell+1}=W_\ell W_\ell^\top\)인 균형(balancing) 상태에서 출발하면 전체 사상의 \(k\)번째 특이값은 \(\dot s_k=-L\,s_k^{2-2/L}\langle\nabla_J\mathcal L,u_kv_k^\top\rangle\)를 따른다(Arora 등 2019, 명제 4.5). 다만 이 조건은 흔한 무작위 초기화를 배제하고 선형 신경망에 묶여 있다(1절).
ReLU 신경망의 야코비안은 활성 패턴이 정해지면 \(W_LD_{L-1}W_{L-1}\cdots D_1W_1\) 꼴이다. 논문은 이 게이트 곱에서 깊이가 만드는 두 성질을 꺼낸다. 첫째는 깊이 스케일링(depth scaling)이다. 가우시안 가중치와 베르누이 게이트를 번갈아 곱하면 \(\frac1L\log s_k\)가 리아푸노프 지수(Lyapunov exponent) \(\gamma_k\)로 거의 확실하게 수렴하고 \(\gamma_1>\gamma_2>\cdots>\gamma_r\)이다(정리 5.3). 그래서 이웃한 특이값의 비 \(s_{k+1}/s_k\)는 층이 쌓일수록 0으로 간다(따름정리 5.6). 둘째는 정렬이다. 스펙트럼이 크게 벌어진 \(A\)에 \(B\)를 곱해도 \(AB\)의 상위 왼쪽 특이벡터는 \(A\)의 것과 거의 같다(정리 6.1).
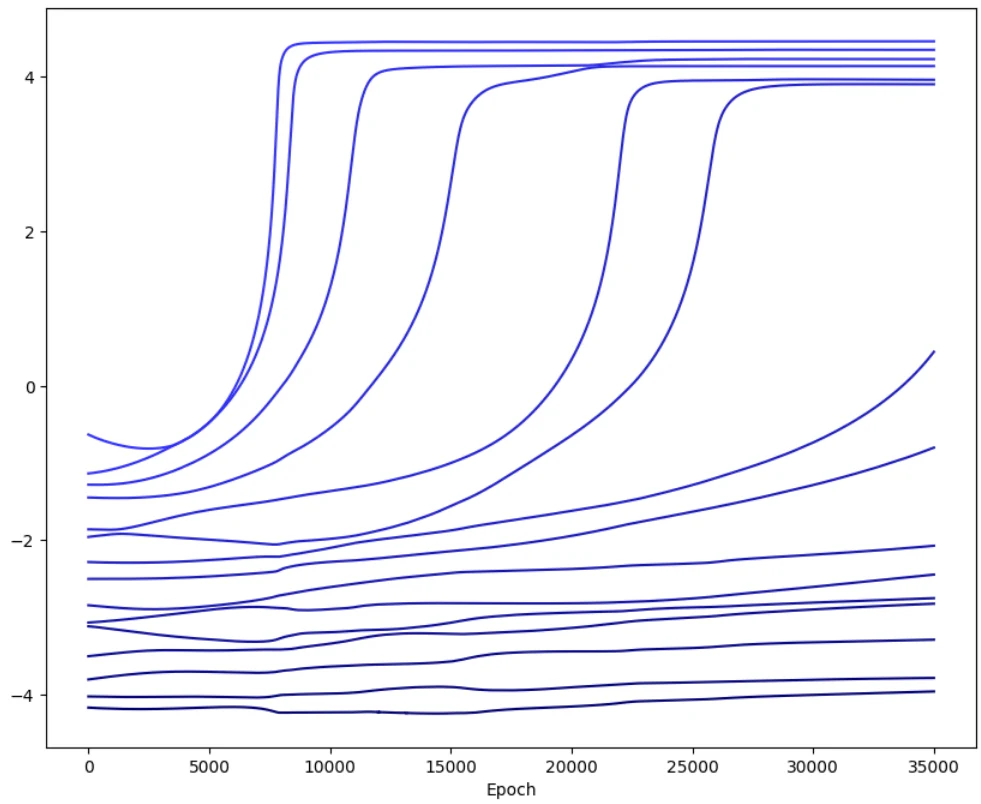
두 성질이 학습 중에도 모든 중간 곱에서 성립한다고 두면 특이값이 따로따로 움직이고, 식은 균형 가정의 식과 배율만 다르다(명제 7.1). 블로그의 해석: 지수 \(2-2/L\)이 1보다 커서 이미 큰 특이값일수록 빨리 자라므로, 아래 그림처럼 특이값이 하나씩 차례로 솟는다.
어떻게 보였나
행렬 곱의 리아푸노프 지수를 다루는 곱셈 에르고드 정리(multiplicative ergodic theorem)는 대개 인자가 가역이라고 둔다. 게이트가 낀 인자는 가역이 아니고, 층을 끝없이 쌓으면 언젠가 곱이 0이 된다. 저자들은 게이트 랭크가 \(r\) 이상이도록 조건을 걸고(정의 5.2), 곱이 0이 되지 않기만 하면 지수가 존재하도록 기존 정리를 넓혔다(부록 정리 C.1).
지수의 값은 부피에서 나온다. \(\gamma_1+\cdots+\gamma_i\)는 한 층이 \(i\)차원 평행체의 부피를 늘리는 배율의 로그 기댓값이다. 랭크 \(t\)인 게이트를 지난 가우시안 열 \(i\)개의 부피 제곱은 위샤트(Wishart) 행렬식이라 로그 기댓값이 디감마 함수의 합으로 나오고(보조정리 C.3), 이를 이항분포로 평균해 이웃한 \(i\)끼리 빼면 \(\gamma_i=\ln(\sqrt2\sigma)+\tfrac12\mathbb E_t\big[\psi\big(\tfrac{t-i+1}{2}\big)\big]\)이다(주석 5.4, 5.5). 블로그의 해석으로 풀면, 한 층은 \(i\)번째 방향을 앞선 방향들을 빼고 남은 \(t-i+1\)차원 가우시안 벡터의 길이만큼 늘린다. 남은 차원이 적을수록 덜 늘어나니 뒤쪽 특이값일수록 기울기가 작다.
정렬은 타원으로 생각하면 쉽다. 스펙트럼이 크게 벌어진 \(A\)는 단위 구를 아주 길쭉한 타원체로 보내므로, 앞에서 \(B\)가 만든 적당한 찌그러짐은 거의 묻힌다(6절). 전체 곱을 쪼갠 뒤쪽 곱도 스펙트럼이 벌어지므로 중간 곱들이 특이벡터를 거의 공유한다. 특이벡터가 맞는 정도를 잰 대각 상관(부록 F)은 논문 실험의 깊이 2, 10, 20에서 0.26, 0.49, 0.84다(그림 6).
(가) 깊이에 따라 벌어지는 특이값
(나) 벌어진 스펙트럼이 만드는 정렬
눈여겨볼 점
첫째, 세 결과가 엄밀한 학습 정리 하나로 이어지지 않는다. 정리 5.3은 무작위 초기화에서, 정리 6.1은 분리가 한없이 강해지는 극한에서 성립하고, 명제 7.1은 둘을 학습 중의 가정으로 빌려 쓴다(3절). 저자들도 특이벡터가 꼭 맞는다는 가정은 현실적인 깊이에서 성립하지 않는다고 적었다(7절, 9절). 부록의 동역학 비교도 상수를 실험에 맞춘 뒤 모양만 견준다(부록 G.1).
둘째, 상위 특이값끼리는 초기화만으로 잘 갈라지지 않는다. 주석 5.5의 식에 논문 실험 설정(너비 128, \(p=0.5\))을 넣으면 \(\gamma_1-\gamma_2\)는 층당 약 0.008이라, 지수 차이만으로 두 특이값의 비가 \(1/e\)이 되려면 120층 남짓이 필요하다(블로그의 계산). 깊이 10의 MNIST 실험에서도 초기화 직후의 정렬은 뒤쪽 곱이 짧아질수록 금세 약해지고, 학습 뒤에야 고르게 강해진다(그림 5). 블로그의 해석: 실제 깊이에서는 학습이 강한 분리를 만들고 이론은 이를 가정한다.
셋째, 게이트를 고정했다. 실제 ReLU 신경망은 입력과 학습에 따라 활성 패턴이 바뀌지만 정리와 실험은 패턴 하나에 머문다(9절). 저자들은 심사 토론에서 패턴이 바뀌는 ReLU 신경망에서도 곡선은 비슷하고 잡음만 더해진다고 답했다(OpenReview).
열린 질문
- 너비가 크고 얕은 신경망이나 초기 특이값을 1 근처로 모으는 잔차 신경망처럼 깊이만으로는 분리가 약한 경우에도 학습 중에 분리와 정렬이 생길까. 생긴다면 명제 7.1의 동역학은 언제부터 실제 특이값 궤적을 맞힐까.
이해 확인
가중치와 게이트를 번갈아 곱한 무작위 곱에서 깊이 \(L\)을 늘리면, 상위 \(r\)개 안에서 이웃한 두 특이값의 비는 어떻게 될까?
- 모든 특이값이 같은 속도로 변해 비가 일정하다
- 로그 특이값의 기울기가 순서마다 달라 비가 지수적으로 0에 다가간다
- 특이값이 1 근처로 모여 비가 1에 다가간다
- 게이트가 방향을 지워 상위 r개 특이값도 결국 0이 된다
정리 5.3에 따라 \(\frac1L\log s_k\)는 \(\gamma_k\)로 수렴하고 \(\gamma_1>\cdots>\gamma_r\)이라서 비는 대략 \(e^{-L(\gamma_k-\gamma_{k+1})}\)로 줄어 0에 간다(따름정리 5.6). 3번은 잔차 연결 등이 노리는 동역학적 등거리성(dynamical isometry)이다. 게이트 때문에 0으로 가는 것은 \(r\)번째 뒤의 특이값뿐이다.
논문 정보
- 제목: Why Deep Jacobian Spectra Separate: Depth-Induced Scaling and Singular-Vector Alignment
- 저자: Nathanaël Haas (Université d’Artois, CNRS, Université du Littoral Côte d’Opale), François Gatine (Sorbonne Université), Augustin M Cosse (Université du Littoral Côte d’Opale), Zied Bouraoui (Université d’Artois, CNRS)
- 학회: ICML 2026 스포트라이트(Spotlight)
- 링크: arXiv 2602.12384, OpenReview, 코드