BF16 플래시 어텐션은 왜 수천 스텝 뒤에 무너질까
한쪽으로 쏠린 반올림과 닮은 낮은 랭크 구조가 맞물려 손실이 터지기까지
저정밀 학습
3줄 요약
- BF16과 플래시 어텐션(flash attention)으로 GPT-2를 학습하면 수천 스텝 뒤 손실이 폭발하는 일이 2년 넘게 보고돼 왔다. 이 논문은 실패 하나를 고정해 되풀이하며 계산을 하나씩 FP32로 바꿔, 역전파의 중간값 \(\delta=\mathrm{rowsum}(dO\circ O)\)에서 원인을 찾았다.
- 점수 행에 같은 최댓값이 둘 이상 있어 \(\bar P=\exp(S-\mathrm{rowmax}(S))\)이 정확히 1인 칸이 여럿이면 \(\bar PV\)의 BF16 반올림이 한쪽으로 쏠린다. 이 오차가 토큰과 스텝을 가로질러 거의 같은 낮은 랭크 행렬 \(R\)의 계수로 들어가, 지워지지 않고 질의 가중치에 쌓인다.
- 그런 행에서만 빼는 값을 바꿔 \(\bar P\)가 1에 닿지 않게 하자 GPT-2 Small이 60만 스텝까지 안정적으로 학습됐다. 다만 분석은 실패 한 건에서 나왔고, 로짓이 아주 큰 설정에서는 이 수정이 언더플로를 일으킨다는 후속 보고가 있다.
선정 이유
ICLR 2026에서 구두 발표(Oral)로 뽑혔고 리뷰 점수는 8, 8, 6, 4로 갈렸다. 블로그의 연구 여지 지도에서 이 논문이 속한 ’트랜스포머 구조와 학습 동역학’은 LLM 중심 주제를 뺀 109개 주제 가운데 43위다. 순위는 중간이지만 GPU 몇 장 규모에서 실패의 원인을 끝까지 따라간 연구라 배울 것이 많다.
- 전후로 아는 것이 달라졌나. 달라졌다. 저정밀 학습의 손실 폭발은 큰 스펙트럼 노름, 큰 활성값, 어텐션 싱크(attention sink) 같은 증상과 함께 언급되고 QK 정규화 같은 처방으로 다뤄졌다(3.1절). 이 논문은 비트 한 자리의 반올림에서 가중치의 스펙트럼 노름 증가까지 이어지는 사슬을 처음으로 이었다.
- 새 질문을 여는가. 연다. 아래 열린 질문들이 바로 따라 나오고, 1년 사이에 이 논문을 잇는 후속 연구가 여럿 나왔다.
- 일반화될 근거가 있나. 부분적으로 있다. 반올림의 산술은 모델을 가리지 않고 Llama 3.1 8B에서도 같은 재료가 보였지만(부록 D), 실패를 고친 것은 GPT-2 Small과 Medium까지다.
- 증거가 주장만큼 강한가. 같은 실패를 되풀이하며 계산 하나만 바꿔 보는 개입 실험은 탄탄하다. 반면 고리 대부분이 실패 한 건에서 나왔고, 수정의 효과는 손실 곡선으로만 봤다.
왜 중요한가
정밀도를 낮추면 메모리와 속도를 함께 얻는다. 지금은 가중치의 FP32 사본을 두고 대부분의 계산을 16비트로 하는 혼합 정밀도(mixed precision) 학습이 표준이고, 16비트로는 FP32와 지수 범위가 같은 BF16(bfloat16)이 널리 쓰인다(2.1절). BF16은 가수가 7비트뿐이라 1과 2 사이에서 쓸 수 있는 값의 간격이 1/128이다.
저자들에 따르면 산업 현장에서는 피드포워드 층을 FP8까지 낮추면서도 어텐션만큼은 BF16에 두는 일이 흔하다(1절). 어텐션이 정밀도에 유난히 예민하다는 뜻이다. 그 어텐션의 표준 알고리즘인 플래시 어텐션은 \(N\times N\) 점수 행렬을 통째로 만들지 않고 블록으로 나눠 계산해, 메모리를 시퀀스 길이의 제곱에서 선형으로 줄인다(2.2절).
그런데 이 조합이 가끔 학습을 무너뜨린다. nanoGPT로 GPT-2를 BF16과 플래시 어텐션으로 학습하면 수천 스텝 뒤 손실이 치솟는다는 보고가 깃허브 이슈에 2년 넘게 쌓였다(3.1절, 부록 그림 10). FP32나 표준 어텐션으로 돌아가면 사라지지만 효율을 잃는다. 큰 언어 모델에서도 비슷한 불안정에 QK 정규화(QK normalization), QK 클립(QK-clip), 게이트 어텐션(gated attention) 같은 처방이 나왔지만, 수치 오차에서 손실 폭발까지의 인과 사슬은 비어 있었다(3.1절).
핵심 아이디어
직관: 반올림은 공평하지만 데이터가 공평하지 않으면 쏠린다
BF16 연산의 결과는 가장 가까운 값으로 반올림되고, 정확히 가운데면 끝자리가 짝수인 쪽으로 간다(round to nearest, ties to even). 값이 무작위로 흩어져 있으면 올림과 내림이 반반이라 오차의 평균은 0이다. 하지만 더하는 값들이 특정한 모양을 띠면 오차가 한쪽으로 쏠린다(부록 B).
논문이 찾은 모양은 이렇다. 소프트맥스는 점수에서 행 최댓값을 빼고 지수를 취하므로 최댓값 자리의 \(\bar P\)는 정확히 1이다. 같은 최댓값이 두 번 이상 나오면 1이 여럿 생기고, 그 자리의 \(\bar PV\)는 BF16 값인 \(V\) 그대로다. 이런 값끼리 더할 때 반올림이 한쪽으로 기운다. 작은 편향이 큰 피해로 번지려면 하나가 더 필요하다. 오차가 늘 같은 방향을 향해야 한다. 논문은 질의 가중치의 기울기 오차가 토큰과 스텝이 달라도 거의 같은 낮은 랭크 행렬 \(R\)의 배수임을 보였다. 같은 방향에 같은 부호의 계수가 거듭 곱해지니 오차가 서로 지우지 못하고 쌓인다.
(가) 앞 계산: 오차가 생기는 곳
(나) 뒤 계산: 오차가 쌓이는 곳
방법: 계산을 하나씩 FP32로 바꿔 범인을 좁힌다
실험 모델은 12층, 헤드 12개, 임베딩 768차원, 문맥 1,024의 GPT-2다. OpenWebText로 사전학습하고 AdamW(β₁ 0.9, β₂ 0.95), 최고 \(10^{-3}\)의 코사인 학습률, 기울기 클리핑 1.0을 썼다. A100 네 장에서 스텝마다 524,288토큰을 처리한다. 처음 실패한 실행의 배치 순서를 기록해 모든 실험에서 다시 쓰기 때문에 같은 실패가 그대로 되풀이된다(3.1절).
다음은 소거법이다(3.2절). 블록 나눔(tiling)을 꺼도 실패하므로 블록 나눔은 범인이 아니다. 층별 스펙트럼 노름은 2번째 층 어텐션에서만 튀고, 그 층에만 플래시 어텐션을 써도 실패하며 그 층만 표준 어텐션으로 바꾸면 안정된다. 역전파의 \(\delta=\mathrm{rowsum}(dO\circ O)\)를 수학적으로 같은 \(\mathrm{rowsum}(dP\circ P)\)로 바꿔도, 순전파의 출력 \(O\)만 FP32로 계산해도 안정된다. 첫 주장이 여기서 나온다. 저정밀 \(O\)로 만든 \(\delta_{lp}\)가 실패를 일으킨다. 헤드별로는 질의 투영 \(W^Q\)의 스펙트럼 노름이 1, 7, 8, 9, 11, 12번 헤드에서 유난히 크고, 이 헤드들만 \(O\)를 FP32로 계산해도 학습이 살아난다. 이후 분석은 8번 헤드에 집중한다.
수식: 오차는 \(\delta\)로 들어와 \(R\) 방향에 쌓인다
점수의 기울기는 \(dS=\alpha P\circ(dP-\delta)\), 질의의 기울기는 \(dQ=dS\,K\)다. 고정밀(hp)과 저정밀(lp) 역전파에서 다른 것은 \(\delta\)뿐이라 차이가 간단해진다(식 1, 2).
\[ dW^Q_{hp}-dW^Q_{lp}=\alpha\sum_{T=1}^{N}(\delta_{lp}-\delta_{hp})[T]\,(PK)[T]^{\top}X[T] \]
기울기 오차는 랭크 1 행렬들의 가중합이고 가중치는 토큰마다의 \(\delta\) 오차다. 논문 그림 4를 보면 6610스텝 50번 토큰과 6619스텝 718번 토큰에서 이 행렬이 똑같이 입력 특징 546번과 678번 열에서 두드러진다. 그래서 공통 구조 \(R\)로 근사할 수 있다(식 3).
\[ dW^Q_{hp}-dW^Q_{lp}\approx\alpha\Big(\sum_{T=1}^{N}(\delta_{lp}-\delta_{hp})[T]\Big)R \]
이제 \(R\) 방향에 쌓이는 양은 계수의 합이 정한다. 실패 직전 6580~6680스텝에서 이 합을 누적하면 양수 쪽으로 꾸준히 커진다(그림 5a). 같은 방향의 오차가 쌓여 가중치의 스펙트럼 노름과 활성값을 키우고 손실을 터뜨린다는 것이 두 번째 주장이다.
계수는 왜 양수일까(3.3.2절). 6619스텝의 718번 토큰에서 특징 20번과 29번은 \(dO\)와 출력 오차 \(O_{lp}-O_{hp}\)가 둘 다 음수라 곱이 양수다(그림 5b, c). 저정밀 출력이 음수 쪽으로 치우쳐 있다. 더 좁히면 정규화 전의 곱 \(\bar O=\bar PV\) 하나만 FP32로 계산해도 학습이 안정되고, 토큰을 하나씩 더해 가며 보면 오차는 \(\bar P\)가 정확히 1인 자리에서 뛴다.
로, 640~670번 사이의 두 토큰에서만 정확히 1이다. 빨간 선은 토큰 t까지 P̄V를 더한 값의 BF16 오차(오른쪽 축, 특징 20)로, 두 번째 1이 더해질 때 약 −0.015로 떨어진다. 출처: Qiu, Yao (2026), CC BY 4.0.](figs/2026-10-15-low-precision-flash-attention-fig6b.webp)
비트 수준에서는 이렇다. 특징 20번의 \(V\)는 대부분 음수다(그림 6a). 앞서 쌓인 합은 BF16 값 −2.40625에 다른 토큰들의 작은 값 약 −0.00087이 붙은 상태이고, 여기에 또 다른 BF16 값 −2.296875가 더해진다. 지수가 같아 가수의 합이 넘치고, 오른쪽으로 한 자리 밀면서 끝 비트 하나가 밀려난다. 그 비트가 1이고 뒤에 작은 값의 비트가 남아 있으니 반올림은 올림이 되고, 결과는 참값 −4.70399보다 더 음수인 −4.71875다. 오차는 −0.0148이다. 밀려난 비트가 0이었다면 작은 값만 잘려 나가 오차가 작고 부호도 반대였다. 큰 음수 오차와 작은 양수 오차가 섞이니 평균은 음수 쪽으로 기운다.
(가) 합이 눈금 사이 가운데에 떨어질 때
(나) 합이 눈금 위에 떨어질 때
\(\bar P\)가 1보다 작으면 가수의 여러 비트가 섞인 값이 곱해져 \(\bar PV\)의 아래쪽 비트가 고루 채워지고, 합이 눈금 사이 아무 데나 떨어져 반올림이 쏠리지 않는다(3.3.2절 Remark 1). 그래서 문제는 최댓값이 여럿인 행에서만 생긴다. 이것이 세 번째 주장이다.
처방은 그 조건만 피한다(4절). 행 최댓값 \(r_m\)이 \(\epsilon\)(예: \(10^{-3}\)) 안에서 두 번 이상 나오는 행에서만 빼는 값 \(m\)을 아래처럼 바꾸고, 나머지 행은 \(r_m\)을 그대로 뺀다.
\[ m=\begin{cases}\beta\,r_m & (r_m>0)\\ 0 & (r_m<0)\end{cases}\qquad \bar P=\exp(S-m),\quad \beta>1 \]
어느 경우든 지수 안의 최댓값이 음수라 \(\bar P\)는 모두 1보다 작다. 소프트맥스는 행마다 같은 상수를 빼도 변하지 않으므로 정확한 산술에서는 원래 어텐션과 같고, 역전파도 그대로다. \(\beta\)는 2에서 8 사이로 잡았다. 작으면 다시 1로 반올림될 수 있고 크면 언더플로가 날 수 있어서다. 고정된 작은 상수를 빼면 최댓값 자리의 \(\bar P\)가 늘 같은 방향으로 반올림되고 \(V\)의 부호가 대체로 같아 편향이 되살아난다. 조건 없이 모든 행에 적용하면 최댓값이 하나뿐인 큰 양수 행에서 \(\exp(-(\beta-1)r_m)\)이 0이 되어 분모가 0이 될 수 있다(부록 C).
결과 해설
수정하면 폭발이 사라진다(4절, 그림 7). 같은 설정에서 원래 플래시 어텐션은 1만 스텝 안팎에서 무너지고, 수정한 쪽(\(\beta=2\))은 GPT-2 Small을 60만 스텝까지 안정적으로 학습한다. RMS를 맞춘 Muon(학습률 \(5\times10^{-4}\), 가중치 감쇠 0.01)으로 바꿔도, GPT-2 Medium을 10만 스텝 학습해도 결과는 같았고, A100, RTX 4090, Ascend 910B에서도 마찬가지였다(5절).
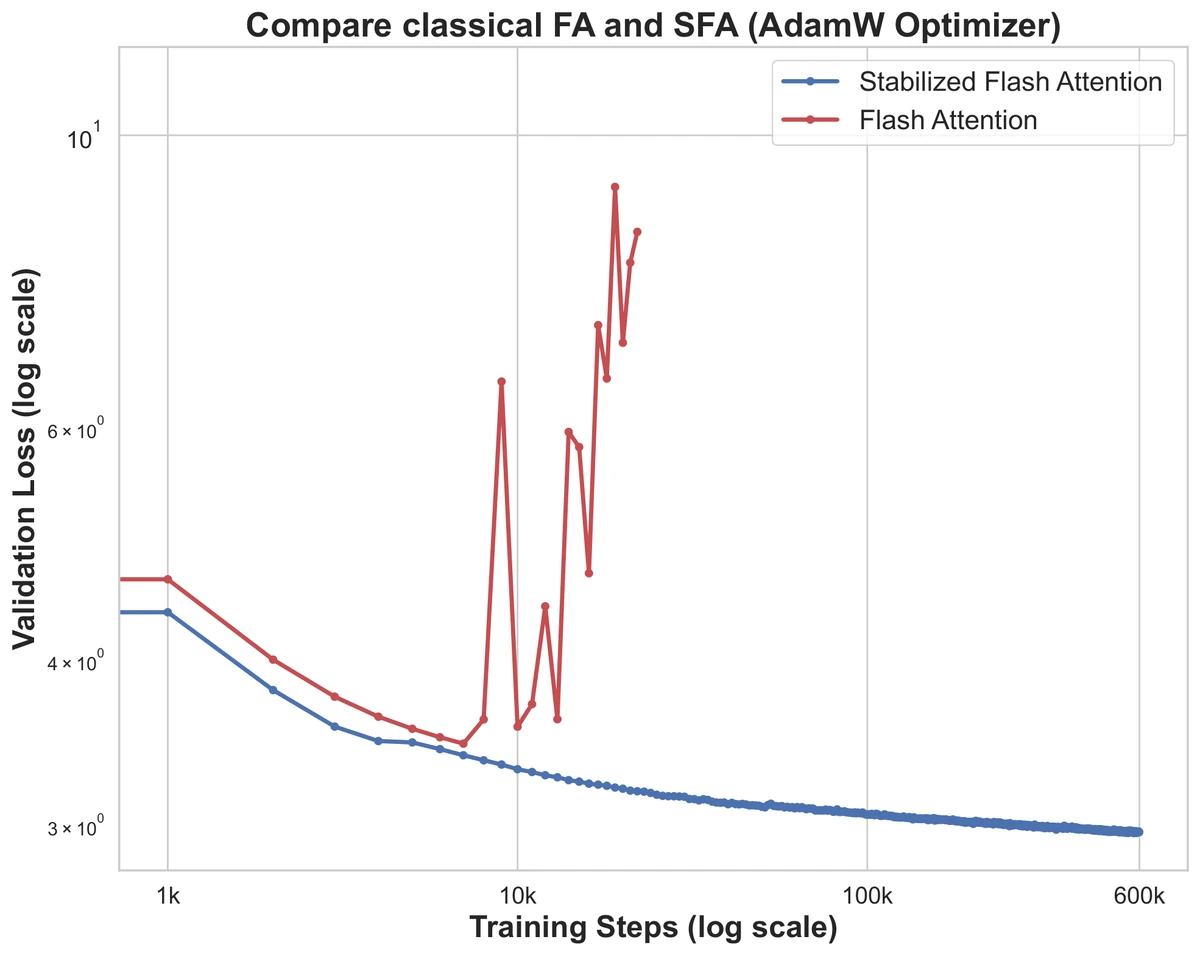
같은 최댓값은 폭발보다 먼저 늘어난다(부록 E.1, 그림 13). 수정 조건에 걸리는 행은 7,000스텝 무렵부터 늘기 시작하고 손실은 그 뒤에 치솟는다.
큰 모델에도 재료는 있다(부록 D). Llama 3.1 8B의 1번째 층 13번 헤드에서도 토큰마다 \((PK)[T]^\top X[T]\)가 같은 열에서 두드러지고(열 사이 코사인 유사도 0.99999), 여러 층에서 최댓값이 둘인 행이 보이며 첫 토큰이 어텐션 싱크로서 높은 점수를 받는다. Llama가 꼭 실패한다는 뜻은 아니라고 저자들은 선을 긋는다.
작은 예. 어텐션 한 행만 떼어 계산하면 아래 그림과 같다. 최댓값이 하나뿐인 행에도 반대 방향의 작은 치우침이 남는다. 블로그의 해석으로는 실제 편향의 방향은 같은 최댓값이 얼마나 자주 나오느냐에 달려 있고, 그림 13에서 그 빈도는 폭발 직전에 늘어난다.
(가) 행마다 생긴 오차
(나) 오차를 차례로 더하면
의심해볼 점
- 실패 사례는 하나다. 헤드, 스텝, 토큰까지 내려간 분석은 GPT-2 Small 실행 하나에서 나왔고, Medium과 Muon 실험은 수정이 듣는지만 확인했다. 저자들도 다른 구조, 더 큰 규모, FP8로의 일반화를 한계로 적었다(5절).
- 분석한 구현과 실제 커널. 공개 코드의 플래시 어텐션은 플래시 어텐션 2 알고리즘을 파이토치 연산으로 옮긴 구현(블록 크기 512)이고, 정규화 전의 곱 \(\bar PV\)를 BF16으로 저장한다. 블로그의 해석으로는 출력 누산을 FP32로 이어 가다 정규화한 뒤 한 번만 BF16으로 내리는 융합 커널에서도 같은 크기의 편향이 생기는지는 따로 확인할 일이다.
- 낮은 랭크 구조의 근거는 그림이다. GPT-2에서 \(R\)은 히트맵이 닮았다는 관찰(그림 4)에 기대고, 스텝을 가로질러 얼마나 닮았는지 수치로 재지 않았다. 이 구조가 왜 생기는지도 설명하지 않는다.
- \(\beta\)는 손이 간다. 공개 코드의 안내문은 NaN이 나면 \(\beta\)를 줄이고 손실이 터지면 늘리라고 권한다. 후속 연구(Chen 외, arXiv 2609.34272, 부록 G)는 QK 정규화 없이 4억 5천만 파라미터 모델을 학습하며 이 수정의 공개 구현을 비교했다. 로짓이 수천까지 커지자 같은 최댓값이 흔해졌고, \(2r\)을 빼는 규칙 때문에 지수가 FP32 범위 밖으로 떨어지면서 이 실행은 25억 토큰 무렵부터 뒤처지다 정체했다. 시드 한 개의 비교지만 처방이 통하는 범위가 좁을 수 있다.
- 기존 처방에 대한 설명은 가설이다. QK 정규화와 게이트 어텐션이 \(R\)의 구조를 깨서 오차가 쌓이지 못하게 한다는 설명(5절)은 실험으로 확인하지 않았다.
리뷰어들이 짚은 점
OpenReview 공개 심사에서 리뷰어들은 추리 소설처럼 원인을 좁혀 가는 서술을 높이 샀고, 메타 리뷰는 일반성, 스파이크의 급격함, 계산 비용을 주된 우려로 꼽았다.
- 일반성. 4점 리뷰어는 GPT-2 하나로는 부족하고 큰 모델에서 문제의 헤드를 어떻게 찾느냐고 물었다. 저자들은 Medium, Muon, 60만 스텝 실험을 더하고 헤드별 스펙트럼 노름을 보면 된다고 답했다. 메타 리뷰는 대규모 검증이 일부만 해결됐다고 봤다.
- 작은 편향과 급격한 스파이크. 6점 리뷰어가 가장 큰 약점으로 꼽은 대목이다. 저자들은 손실이 실제로는 수백 스텝에 걸쳐 오르며 기록 간격 때문에 급격해 보였을 뿐이라고 답했다(그림 7b). 기울기 동역학이 작은 표류를 되돌리지 않느냐는 물음에는 표류가 꾸준해 되돌릴 수 없다고만 답했다.
- \(R\)은 어디서 오나. 8점 리뷰어의 질문에 저자들은 특정 토큰 때문은 아니며(그림 12) 표현의 이방성(anisotropy)으로 보인다고 답했다.
- 비용. 최댓값을 세는 일은 행마다 \(O(N)\)이라는 답이 있었지만 실제 속도는 재지 않았다.
계보
- 혼합 정밀도와 BF16. Micikevicius 외(2017)가 FP16 혼합 정밀도를, Kalamkar 외(2019)가 BF16 학습을 정착시켰다. Lee 외(2024)는 순수 BF16 GPT-2 사전학습의 약 10%가 발산했다고 보고했다(부록 A.1). Zamirai 외(2020)는 반올림에 작은 가중치 갱신이 묻히는 문제를 확률적 반올림(stochastic rounding)으로 다뤘는데, 이번 논문은 반올림이 오차를 한쪽으로 쌓는 문제를 짚었다.
- 플래시 어텐션과 처방들. 플래시 어텐션은 Dao 외(2022), Dao(2023)의 2판, Shah 외(2024)의 3판으로 이어지고 이번 분석의 대상은 2판이다. 배경이 된 처방은 QK 정규화(Henry 외, 2020), Kimi K2의 QK 클립(2025), 게이트 어텐션(Qiu 외, 2025), 어텐션 싱크(Xiao 외, 2023) 연구다.
- 후속 연구. 2026년 10월 기준 Semantic Scholar에 인용이 열 편 넘게 쌓였다. Chen 외(arXiv 2609.34272)는 플래시 어텐션 3의 기울기 폭증을 점수 기울기의 행 합이 0이라는 성질이 반올림으로 깨지는 문제로 설명하고 GProj를 냈다. Xie 외(arXiv 2608.02091)는 GPT-2급 붕괴에서 오차의 출처가 달라도 같은 QK 스펙트럼 폭주로 이어지고, 오차가 파고드는 조건은 크기가 아니라 부호가 스텝을 가로질러 유지되는 성질이라고 보고했다. Huang 외(arXiv 2606.28116)는 저정밀 플래시 어텐션 고장을 손실 붕괴 수천 스텝 전에 알리는 감시 지표를 냈다. Liu 외(NeurIPS 2026, arXiv 2605.06152)는 반올림이 기울기 합이 0이라는 제약을 깨 노름을 키우는 현상으로 ‘슬링샷’ 스파이크를 설명했다.
열린 질문
- FP8이나 MXFP4처럼 가수 비트가 더 적은 형식에서는 짧은 비트열로 표현되는 값끼리 더하는 일이 훨씬 잦아진다. 이 편향은 더 낮은 정밀도에서 어떤 모습으로 나타날까.
- 오차가 쌓이는 통로인 낮은 랭크 구조는 왜 생기고, 표현의 이방성이나 어텐션 싱크와 어떻게 이어질까. QK 정규화 같은 처방은 정말 이 구조를 깨서 듣는 것일까.
- 실패를 가르는 것이 반올림 오차의 크기보다 부호가 얼마나 오래 한 방향을 유지하느냐라면, 이를 학습 중에 싸게 재서 폭발을 미리 알아챌 수 있을까.
이해 확인
1. 한 행에 P̄가 정확히 1인 칸이 둘 이상 있을 때 BF16 반올림이 한쪽으로 쏠리는 까닭은?
- exp(0)을 BF16으로 계산하면 1보다 조금 큰 값이 나오기 때문이다
- 그 자리의 P̄V가 V의 BF16 값 그대로라 합이 눈금 위나 정확히 가운데에 떨어지고, 다른 토큰이 보탠 같은 부호의 작은 값이 가운데 경우를 늘 바깥쪽으로 밀기 때문이다
- 1이 둘이면 소프트맥스 분모가 두 배가 되어 출력이 절반으로 줄기 때문이다
- 같은 최댓값이 있으면 플래시 어텐션의 블록 나눔이 어긋나기 때문이다
exp(0) = 1은 정확히 표현되고 블록 나눔은 범인에서 빠졌다(3.2절). 같은 지수의 BF16 값 둘을 더하면 끝 비트가 밀려나는데, 그 비트가 1이면 남은 작은 값 때문에 늘 올림이 되어 큰 음수 오차가, 0이면 작은 양수 오차가 생긴다(3.3.2절).
2. 작은 반올림 편향이 손실 폭발로 커지려면 무엇이 더 필요한가?
- 워밍업이 끝나며 커지는 학습률
- 순전파의 손실 값이 BF16으로 반올림되는 것
- 기울기 오차를 이루는 랭크 1 행렬들이 토큰과 스텝이 바뀌어도 거의 같은 모양 R이라, 같은 방향에 같은 부호의 계수가 쌓이는 것
- 기울기 클리핑이 작은 오차를 증폭하는 것
질의 가중치의 기울기 오차는 δ 오차를 계수로 한 랭크 1 행렬의 합이다(식 2). 이 행렬들이 공통 구조 R로 근사되고(식 3) 계수의 합이 양수로 치우쳐 있어서(그림 5a) 같은 방향의 오차가 스텝마다 더해진다. 부호가 섞이거나 방향이 매번 달랐다면 지워졌을 것이다.
3. 논문의 수정을 바르게 설명한 것은?
- 모든 행의 점수에서 작은 고정 상수를 더 빼서 P̄가 1에 닿지 않게 한다
- 최댓값이 여럿인 행에서만, 최댓값이 양수면 그 β배를 빼고 음수면 0을 빼서 P̄를 1보다 작게 만들고, 역전파는 그대로 둔다
- 정규화 전의 곱 P̄V만 FP32로 계산한다
- 모든 행에서 최댓값의 β배를 빼서 P̄가 늘 1보다 작게 한다
고정 상수를 빼면 최댓값 자리의 P̄가 늘 같은 방향으로 반올림돼 편향이 되살아나고, 모든 행에 적용하면 언더플로로 분모가 0이 될 수 있다(부록 C). P̄V를 FP32로 계산하는 것은 원인을 좁히는 실험이었다(3.3.2절).
논문 정보
- 제목: Why Low-Precision Transformer Training Fails: An Analysis on Flash Attention
- 저자: Haiquan Qiu, Quanming Yao (Tsinghua University)
- 학회: ICLR 2026 Oral
- 링크: arXiv 2510.04212, OpenReview, 코드