NeurIPS 2025 Oral
헤드를 넉넉히 두면 선형 어텐션 학습은 최소제곱이 된다
학습 이론
한 줄 요약
헤드 여러 개짜리 선형 어텐션(linear attention) 한 층은 손실이 볼록하지 않지만, 헤드 수 제한을 풀면 학습이 최소제곱 회귀로 바뀐다. 그래서 자료가 어떤 분포에서 왔든, 기대 손실이 최선의 선형 어텐션보다 많아야 \(\epsilon\) 큰 모델을 다항 시간에 찾는다.
무엇이 달라졌나
트랜스포머가 튜링 기계나 불 회로를 흉내 낼 수 있다는 표현력 연구는 많지만, 그런 가중치를 자료에서 효율적으로 배울 수 있는지는 열린 문제였다. 학습 가능성을 보인 기존 결과는 대개 가우스 입력 같은 강한 자료 가정에 기댔다(1절).
이 논문은 다중 헤드 선형 어텐션(multi-head linear attention, MHLA) 한 층에서 이 물음에 답한다. 모델은 소프트맥스 없이 \(\hat y=\sum_h V_h Z(Z^\top Q_h z_n)\)을 계산한다. \(z_n\)은 마지막 토큰이고, 키와 쿼리 행렬은 서로 곱해지기만 하므로 \(Q_h\) 하나로 합친다(정의 2.1). 정리 2.2의 알고리즘은 표본 \(N\)개, 임베딩 차원 \(d\), 최대 길이 \(n_{\max}\)에서 \(O(Nd^4 n_{\max}\epsilon^{-1})\) 시간에 돈다. 내놓는 모델은 헤드가 많아야 \(d^2\)개이고, 헤드 수를 몇 개로 잡든 그 가운데 가장 좋은 모델과의 기대 손실 차이가 \(\epsilon\) 이하다. 필요한 표본은 \(O((d^4+\log\delta^{-1})/\epsilon)\)개다. 자료가 정말 선형 어텐션에서 나왔다고 가정하지 않으므로 불가지(agnostic) PAC 학습이다.
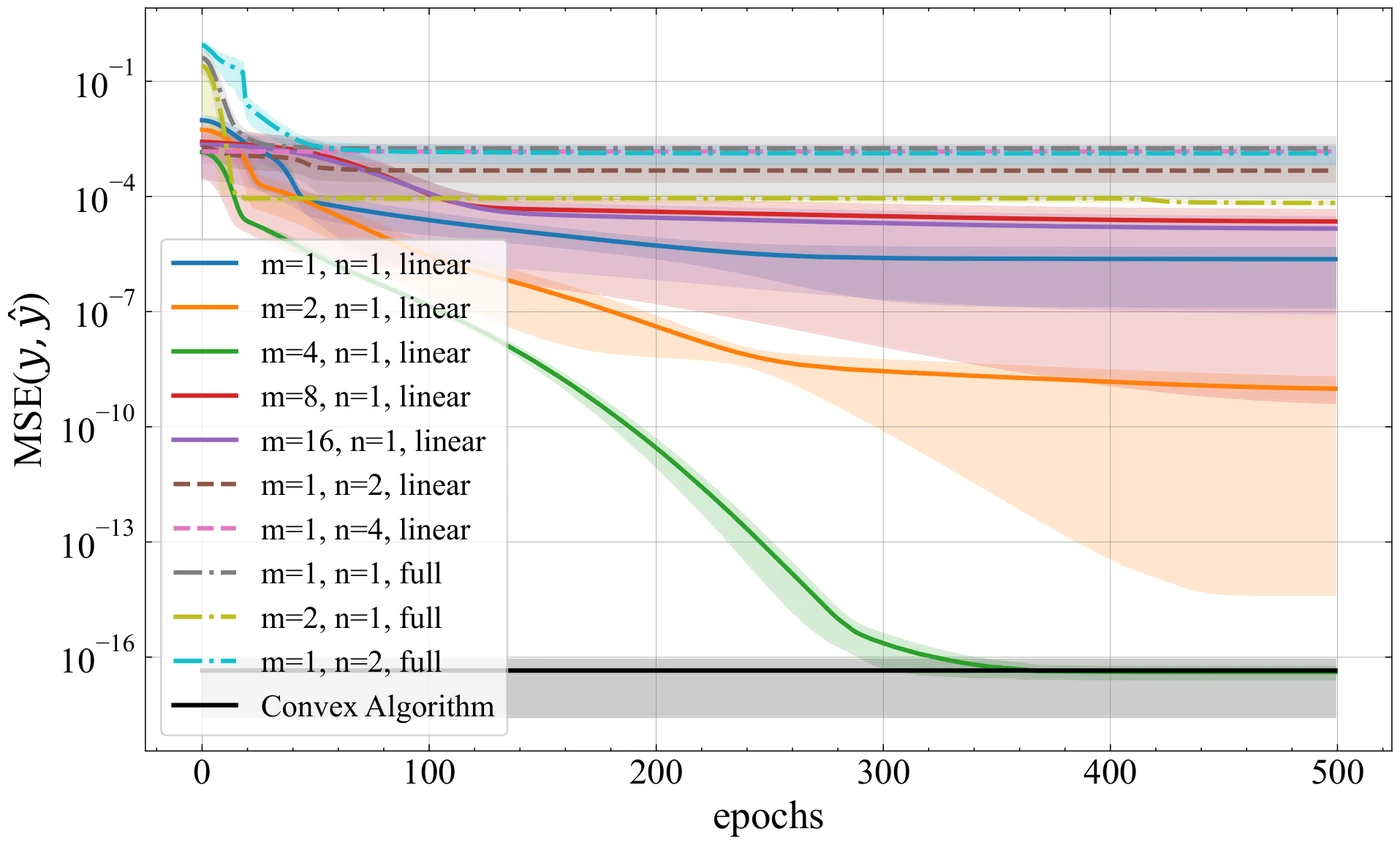
선형 어텐션 한 층으로 만든 자료(\(d=2\), 표본 512개)에서 이 알고리즘의 오차는 약 \(10^{-16}\)으로 부동소수점 정밀도에 닿았다. AdamW로 학습한 모델 가운데 같은 바닥에 닿은 것은 헤드가 \(d^2=4\)개인 모델뿐이었다(4.1절, 부록 G.1, 그림 1(a)).
어떻게 보였나
열쇠는 헤드를 행렬의 조각으로 보는 데 있다. 출력의 \(a\)번째 값을 풀면 \(\sum_h\sum_{j,k,\ell}(V_h)_{aj}(Q_h)_{k\ell}\langle z_{j:},z_{k:}\rangle z_{\ell n}\)이다. 파라미터 쪽 계수를 모은 \(d^2\times d^2\) 행렬 \(W=\sum_h \mathrm{vec}(V_h)\mathrm{vec}(Q_h)^\top\)와, 자료로만 정해지는 3차 특징 \(\langle z_{j:},z_{k:}\rangle z_{\ell n}\)의 내적이 곧 출력이다(2.1절). \(W\) 위에서 보면 손실은 볼록한 2차식이고, 어려움은 헤드 \(H\)개로는 랭크가 \(H\) 이하인 \(W\)만 만들 수 있다는 제약에서 온다.
알고리즘 1은 이 제약을 버린다. 아무 \(W\)나 허용하고 보통 최소제곱으로 풀면, 손실은 어떤 \(H\)개 헤드 모델보다도 낮거나 같다. 답 \(\hat W\)를 특이값 분해(SVD)로 랭크 1 조각들로 나누고 각 조각의 두 벡터를 \(d\times d\) 행렬로 접으면 헤드 하나가 된다. 랭크가 \(d^2\)를 넘지 않으니 헤드도 많아야 \(d^2\)개다. 표본 수 상한은 VC 이론에서 나온다(부록 D). 제약을 푸는 일이 곧 헤드를 늘리는 일이다.
(가) 헤드는 행렬 W의 랭크 1 조각
(나) 랭크 제약을 풀면 그릇 하나
같은 틀에서 두 번째 결과가 나온다. 이 특징들의 2차 모멘트 행렬 \(\Lambda_D\)에서 가장 작은 고윳값이 0보다 크면 최소제곱의 답은 하나뿐이다. 그러면 어떤 MHLA가 만든 자료에서 훈련 손실을 최소로 만든 모델은 파라미터가 달라도 모든 입력에서 같은 값을 낸다(보조정리 2.3). 논문은 이 조건을 식별 가능성 인증(certifiable identifiability)이라 부르며, 다항 시간에 확인할 수 있다. 연관 기억(associative memory) 과제로 시험하면, 이 고윳값이 0.06인 자료에서 경사 하강으로 학습한 모델은 정답과 사실상 같은 함수를 배웠고, 키를 서로 직교하게 뽑아 고윳값이 0이 된 자료에서는 다른 함수를 배웠다(4.2절, 그림 2(b)).
눈여겨볼 점
첫째, 다항 시간이라도 \(d^4\)가 무겁다. \(W\)의 칸이 \(d^4\)개이고 표본도 그만큼 든다. 임베딩 차원이 4096이면 칸이 약 \(2.8\times10^{14}\)개라 지금 형태로는 쓰기 어렵다(블로그의 해석). 실험의 입력 차원도 2와 4다(4.1절). 헤드가 \(d^2\)개는 있어야 한다는 조건이 실제 설정과 크게 다르다는 리뷰어 지적에, 저자들은 헤드가 적은 경우를 저랭크 행렬 최적화와 잇는 일을 다음 과제로 꼽았다.
둘째, 정리는 최소제곱 알고리즘에 관한 것이고 경사 하강에 대해서는 말하지 않는다. 그림 1에서 헤드 수와 오차는 한 방향으로 움직이지 않는다. 500에폭 끝에서 \(d=2\)일 때 헤드 8개와 16개는 1개보다 오차가 컸고, \(d=4\)일 때(그림 1(b))는 헤드 8개와 16개가 바닥에 닿았지만 헤드 1개가 2개, 4개보다 낮았다. 헤드가 많을수록 경사 하강도 쉬워진다는 논문의 해석을 세 번씩 돌린 이 그림만으로 받치기는 어렵다(블로그의 해석).
셋째, 유한 오토마톤 실험은 이 이론이 다루는 모델로 하지 않았다. 4층, 헤드 16개, 은닉 2048차원의 라마(Llama)식 소프트맥스 트랜스포머를 썼다(부록 G.2, G.4). 보편 튜링 기계를 배운다는 결과(보조정리 3.1)도 자료가 인증 조건을 만족한다고 가정하고 얻는다.
열린 질문
- 헤드가 \(d^2\)보다 훨씬 적어 랭크 제약이 살아 있을 때, 경사 하강은 어떤 자료에서 최소제곱의 답에 닿고 어떤 자료에서 멈출까. 저랭크 행렬 복원 이론이 그 경계를 그어 줄 수 있을까.
이해 확인
알고리즘 1이 볼록하지 않은 학습 문제를 다항 시간에 풀 수 있는 까닭으로 가장 알맞은 것은?
- 소프트맥스를 빼면 손실이 파라미터 \(V_h\), \(Q_h\)에 대해 볼록해지기 때문이다
- \(W\)의 랭크 제약을 풀면 최소제곱 문제가 되고, 그 답을 SVD로 헤드 \(d^2\)개 이하의 모델로 되돌릴 수 있기 때문이다
- 입력이 가우스 분포를 따른다고 가정하기 때문이다
- 자료가 식별 가능성 인증 조건을 만족할 때만 알고리즘을 쓸 수 있기 때문이다
출력은 \(W=\sum_h \mathrm{vec}(V_h)\mathrm{vec}(Q_h)^\top\)에 대해 1차식이고, 어려움은 \(W\)의 랭크가 헤드 수 이하여야 한다는 제약에서 온다(2.1절). 제약을 풀면 보통 최소제곱이 되고, 그 손실은 어떤 \(H\)개 헤드 모델보다 낮거나 같다. \(V_h\)와 \(Q_h\)에 대해서는 여전히 둘을 곱한 꼴이라 볼록하지 않다. 정리 2.2는 자료 분포를 가정하지 않고, 인증 조건은 학습이 아니라 학습된 모델들이 같은 함수인지 가릴 때 쓴다(보조정리 2.3).
논문 정보
- 제목: Learning Linear Attention in Polynomial Time
- 저자: Morris Yau, Ekin Akyürek, Jiayuan Mao (MIT CSAIL), Joshua B. Tenenbaum (MIT Brain and Cognitive Sciences), Stefanie Jegelka (TUM, MCML, MIT CSAIL), Jacob Andreas (MIT CSAIL)
- 학회: NeurIPS 2025 구두 발표(Oral)
- 링크: arXiv 2410.10101, OpenReview