ICML 2026 Spotlight
Expressivity-Efficiency Tradeoffs for Hybrid Sequence Models
상태 공간 모델과 어텐션을 섞으면 왜 더 작아도 될까
트랜스포머 표현력
한 줄 요약
맘바(Mamba) 같은 상태 공간 모델(state-space model, SSM) 층과 어텐션 층을 섞은 하이브리드가 언제, 왜 순수 모델보다 나은지를 따진 논문이다. 긴 입력에서 조건 하나를 찾아 그 조건대로 가까운 문맥을 읽는 과제에서, 순수 SSM은 상태가 커야 하고 창을 쓰는 순수 트랜스포머는 창이 입력 길이만큼 넓어야 한다. SSM 한 층 뒤에 어텐션 한 층을 둔 하이브리드는 둘 다 작게 해낸다.
무엇이 달라졌나
하이브리드는 이미 500억 파라미터 규모까지 커졌지만, 왜 나은지는 아직 설명되지 않았다고 저자들은 쓴다(1절). 논문은 함수 합성(function composition)이라는 과제 묶음을 정의한다(정의 3.1). 긴 입력 \(x\)에서 답에 필요한 짧은 문맥 \(u\)와 계산을 조종하는 작은 변수 \(v\)를 뽑아 \(F(u, v)\)를 내놓는 과제다.
대표 예가 선택적 복사(selective copying)다(정의 4.1). 입력에서 가장 최근에 나온 숫자 토큰이 \(k\)이면 끝에서 \(k\)번째 토큰을 내놓는다. 숫자 토큰이 \(N\)종, 일반 토큰이 \(M\)종일 때 순수 SSM은 층을 몇 개 쌓든 상태가 모두 합쳐 \(N\log M\)비트 이상이어야 하고, 슬라이딩 윈도 어텐션(sliding window attention)만 쓰는 트랜스포머는 층별 창 크기의 합이 입력 길이 \(L\)에 비례해야 한다(정리 4.2). 반면 맘바 한 층과 어텐션 한 층으로 된 하이브리드는 창 \(O(N)\)과 \(\mathrm{poly}\log(\max(|V|, L))\)개의 파라미터로 모든 입력을 맞힌다(정리 4.3). 연관 기억(associative recall)에 이진수 해독을 더한 과제에서도 세 층짜리 하이브리드로 비슷한 차이를 보였다(정리 4.5, 4.6).
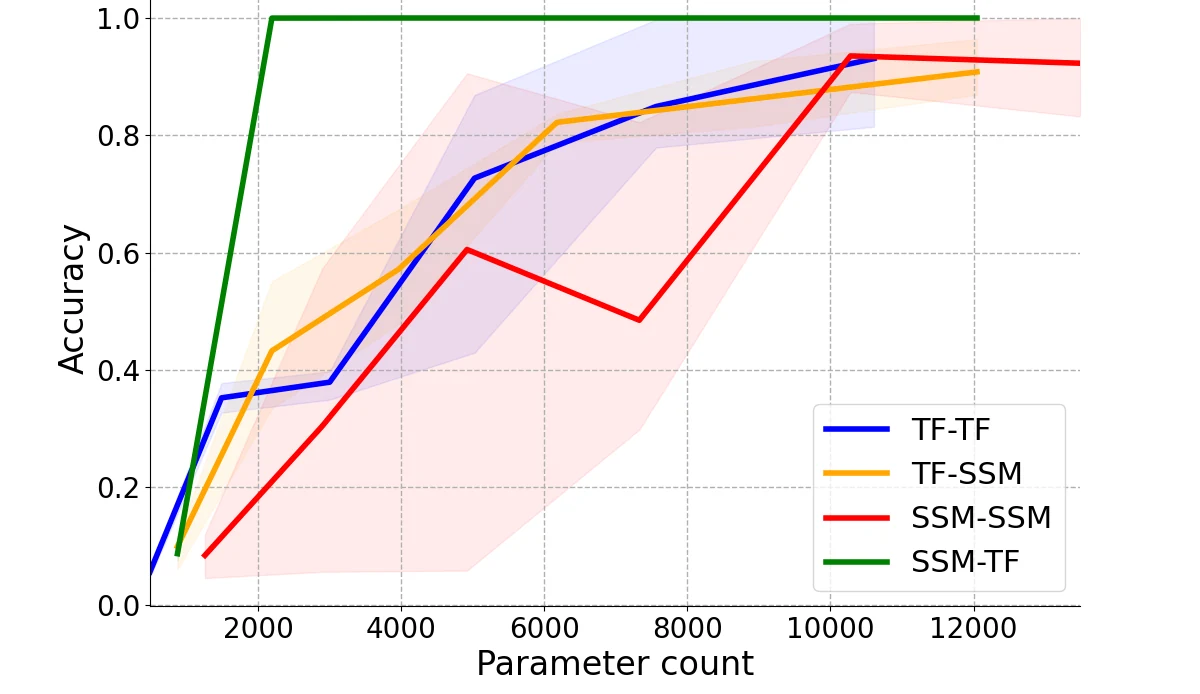
학습 실험도 같은 쪽을 가리킨다. 선택적 복사에서 파라미터가 약 2,000개일 때 SSM 다음에 트랜스포머를 둔 하이브리드의 정확도는 0.999였고 순수 트랜스포머는 0.352, 순수 SSM은 0.305였다. 순수 모델은 약 12,000개에서야 0.923과 0.931에 닿았다(그림 4의 표).
어떻게 보였나
SSM 쪽 하한은 상태를 유한한 기억으로 보는 데서 나온다(2절). SSM을 여러 층 쌓아도 각 층의 상태를 한데 묶은 SSM 한 층과 같으므로(보조정리 3.5) 상태 비트의 합만 세면 된다. 숫자가 맨 끝에 오면 SSM은 그 앞 토큰을 읽는 동안 어느 것을 물을지 모른다. 그러니 마지막 \(N\)개 토큰을 모두 담아 두어야 하고, 이를 정보량으로 세면 \(N\log M\)비트가 나온다(부록 C.2, D.1). 트랜스포머 쪽은 더 단순하다. 숫자가 앞쪽 절반에만 있으면 창의 합이 \(L/2\)보다 짧은 모델은 답이 다른 두 입력을 가려내지 못한다(정리 3.7, 부록 D.1).
하이브리드는 일을 나눈다. SSM은 가장 최근 숫자 하나만 상태에 실어 모든 위치에 붙여 주고, 어텐션은 그 수만큼 거슬러 올라가 토큰을 짚는다(그림 3). SSM은 토큰 하나만 기억하면 되고 어텐션은 \(N\)칸만 보면 된다.
(가) 순수 모델이 막히는 두 입력
(나) 하이브리드의 분업
눈여겨볼 점
첫째, 트랜스포머 하한은 창이 정해진 경우의 이야기다. 전체 어텐션은 창이 \(L\)이라 하한을 이미 채운다. 한 리뷰어는 그래서 논문이 가른 것이 계산할 수 있는 것의 차이가 아니라 같은 일에 드는 작업 기억의 차이라고 짚었고, 저자들은 전체 어텐션을 작업 기억이 가장 큰 특수한 경우로 본다고 답했다.
둘째, 실험 규모가 아주 작다. 선택적 복사는 입력 길이 100에서 파라미터 1만 개 남짓까지만 돌렸고, 저자들도 지금의 언어 모델 규모라면 이 과제를 쉽게 배운다고 적었다(부록 E.1). 창을 넓히자 트랜스포머가 오히려 나빠졌고(부록 E.2, 그림 14), 이론이 트랜스포머와의 차이를 예측하지 않는 다중 키 연관 기억(MKAR)에서도 하이브리드가 앞섰다(5.2절, 그림 6). 블로그의 해석으로는, 학습된 하이브리드가 앞서는 데에는 표현력만이 아니라 배우기 쉬운 정도도 한몫하는 듯하다.
셋째, 순서가 중요하다. 트랜스포머를 앞에 둔 하이브리드는 순수 모델과 다르지 않았다(5.2절, 그림 4). 저자들은 심사 답변에서 조종 변수 \(v\)를 먼저 뽑아야 \(F\)를 계산할 수 있으니 \(v\)를 싸게 뽑는 SSM이 앞에 와야 한다고 설명했지만, 이를 증명하지는 않았다.
열린 질문
- SSM을 앞에 둘 때만 이득이 나는 까닭을 이론으로 보일 수 있을까. 나아가 여러 층을 번갈아 쌓는 실제 하이브리드에서 어텐션 층을 어디에 몇 개 둘지를 과제의 구조에서 미리 정할 수 있을까.
이해 확인
선택적 복사에서 SSM 한 층 뒤에 어텐션 한 층을 둔 하이브리드가 작은 상태와 짧은 창으로 충분한 까닭은?
- SSM이 입력 전체를 상태에 압축해 두고, 어텐션은 그 상태만 읽으면 되기 때문이다
- SSM은 가장 최근 숫자 하나만 실어 나르고, 어텐션은 그 수만큼만 거슬러 보면 되기 때문이다
- 어텐션이 먼저 숫자를 찾고, SSM이 그 숫자가 가리키는 토큰을 기억하기 때문이다
- 하이브리드의 어텐션은 입력 전체를 보므로 창 크기에 제약이 없기 때문이다
정리 4.3의 구성에서 맘바 층은 가장 최근 숫자 토큰만 상태에 담아 각 위치에 붙이고, 어텐션 층은 그 수만큼 떨어진 토큰을 짚는다. 그래서 창은 \(O(N)\)이면 된다. 입력 전체를 담으려면 상태가 \(N\log M\)비트 이상 필요하고(정리 4.2), 트랜스포머를 앞에 둔 순서는 실험에서 순수 모델보다 낫지 않았다(그림 4).
논문 정보
- 제목: Expressivity-Efficiency Tradeoffs for Hybrid Sequence Models
- 저자: John Cooper, Ilias Diakonikolas, Mingchen Ma, Frederic Sala (University of Wisconsin-Madison)
- 학회: ICML 2026 스포트라이트(Spotlight)
- 링크: arXiv 2603.08859, OpenReview, 코드