가끔만 주고받은 모델들은 마지막에 한 번 평균하면 연합 학습에 가까워진다
탈중앙 학습, 모델 병합
한 줄 요약
에이전트마다 데이터가 크게 치우친 탈중앙 학습(decentralized learning)에서, 학습 내내 무작위 이웃 하나와 가끔 섞기만 한 모델들을 마지막에 한 번 평균하면 연합 학습에 가까운 정확도가 나온다. 통신을 아예 끊으면 같은 평균이 무너진다.
무엇이 달라졌나
탈중앙 학습에서는 중앙 서버 없이 기기끼리 모델을 주고받는다. 대역폭이 모자라고 기기마다 데이터가 다르면 성능이 크게 떨어진다는 것이 통념이었고, 연구는 주로 누구와 주고받을지에 쏠렸다(1절). 이 논문은 언제 주고받을지를 묻는다.
핵심 결과는 마지막 병합 한 번의 효과다(4.2절). 에이전트 32개가 Tiny ImageNet을 디리클레 분포(α = 0.1)로 크게 치우치게 나눠 갖고, 라운드마다 0.2의 확률로 무작위 이웃 하나와 모델을 평균하며 ResNet-18을 처음부터 학습한다(부록 C.1). 병합 직전 각 모델의 전체 데이터 정확도 평균은 0.22 안팎으로, 혼자 학습한 경우(0.19 안팎)와 큰 차이가 없다. 그런데 32개 모델을 한 번 평균하자 0.47로 뛰었다. 매 라운드 서버에서 평균하는 연합 학습은 0.55였다(그림 1b). 에이전트마다 평균 60번쯤 이웃과 섞고도 혼자 학습한 모델과 비슷했으니, 이 도약은 쌓인 주고받기로 설명되지 않는다고 저자들은 본다(비고 2). 사전학습한 CLIP ViT-B/32도 0.38에서 0.56으로 올라 연합 학습(0.59)에 다가갔다(그림 1a).
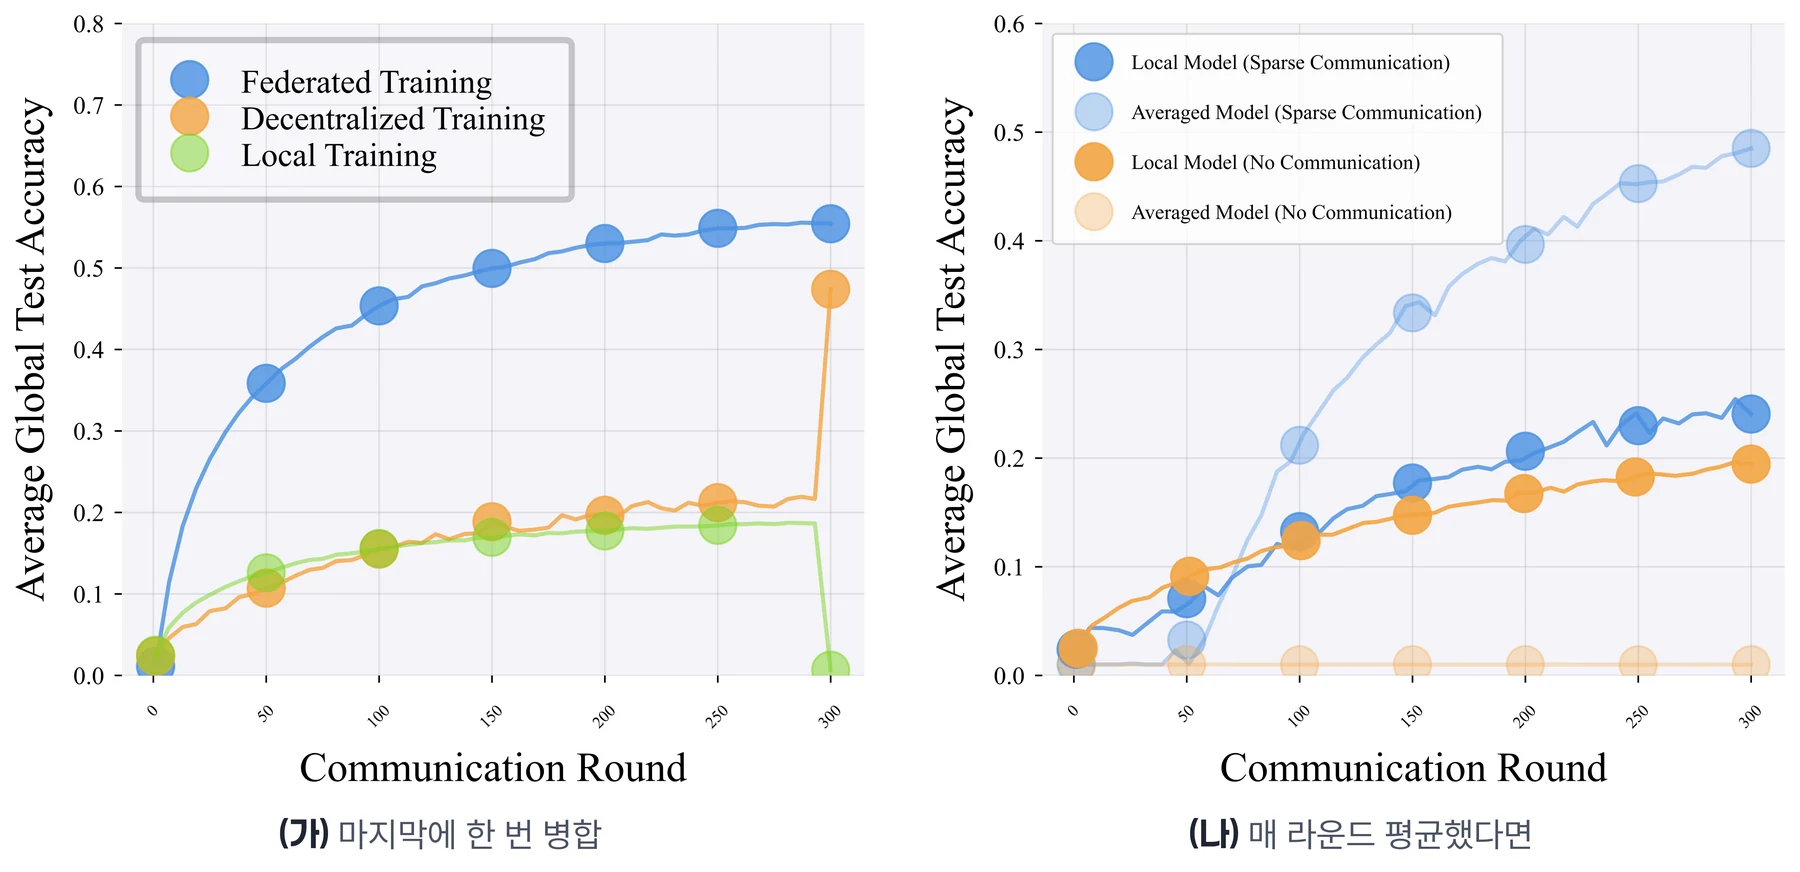
그림 (나)가 핵심 대조다. 가끔이라도 주고받은 모델들은 70라운드 무렵부터 평균이 각 모델보다 낫고, 끝에는 0.49 대 0.24로 벌어진다. 통신 없이 학습한 모델들은 평균하면 0.01 근처, 곧 100개 범주를 찍는 수준이 된다(4.3절). 평균해도 망가지지 않는 모델은 보통 출발점이 같거나 데이터가 비슷하거나 뉴런 순서를 맞춘 경우였는데(모드 연결성 해설), 저자들은 셋 다 없이도 평균이 통한다고 강조한다(부록 B.3).
어떻게 보였나
출발점은 통신을 시간에 나눠 쓰는 실험이다(4.1절). 300라운드를 열 구간으로 나눠 한 구간에서만 매 라운드 모든 모델을 평균(AllReduce)하고 나머지에서는 가끔 이웃과만 섞었더니, 집중 구간이 뒤로 갈수록 정확도가 높았다(그림 2a). 그 구간을 한 라운드로 줄인 것이 마지막 병합이다.
이론은 탈중앙 SGD의 평균 모델이 병렬 SGD와 같은 속도로 정류점(stationary point)에 다가갈 수 있다고 보인다(정리 1, 명제 2). 기존 분석은 모델 사이의 어긋남을 잡음으로만 보고 벌점을 매겼다(5.2절, 표 1). 이 논문은 모델들이 평균 주변에 퍼진 정도 \(\Xi_t\)를 다시 본다. 손실이 줄어드는 쪽으로 가면 날카로움(sharpness)이 커진다는 가정(가정 4)과 학습률이 \(1/L_2\)보다 크다는 조건(비고 6) 아래에서는, \(\Xi_t\)가 작을 때 퍼짐이 주는 2차 이득이 3차 오차보다 커서 오히려 하강을 돕는다(명제 2, 식 9). \(\Xi_t^2\)의 기댓값은 그래프가 모델을 섞는 정도 \(p\)에 대해 \((1-p)/p^2\) 정도로 묶이는데, 통신이 없으면(\(p = 0\)) 이 한계가 사라진다(식 10). 명제 3의 충분조건은 평균 모델의 기울기가 클수록 느슨해서, 기울기가 작아지는 후반일수록 자주 주고받아야 한다.
눈여겨볼 점
첫째, “통신은 후반에 몰아라”는 “멈추기 직전에 맞춰라”에 가깝다. 그림 2(a)에서 집중 구간이 마지막이 아니면 최종 정확도는 0.24에서 0.28 사이이고, 마지막일 때만 0.55다. 150라운드부터 집중하면 0.45까지 오르다가, 가끔 주고받기로 돌아가면 곧 내려가 0.27로 끝난다. 블로그의 해석으로는, 실용적인 교훈은 통신 일정보다 내보내기 직전의 평균 한 번에 있다.
둘째, 이론과 실험 사이에 틈이 있다. 정리 1은 모든 에이전트가 같은 초기값에서 출발한다고 두지만 실험 대부분은 서로 다른 초기값을 쓴다(부록 A). 정리가 다루는 것도 시험 정확도가 아니라 기울기가 줄어드는 속도이고, 병렬 SGD와 같다는 결론은 가정 4가 모든 점에서 성립해야 나온다. 한 리뷰어가 이를 과장이라고 짚자, 저자들은 모델이 모두 같으면 병렬 SGD가 그대로 나오니 공정한 비교라고 답했다. 실험은 이미지 분류에 한정된다(부록 A).
열린 질문
- 통신을 얼마나 더 줄여야 평균이 더는 통하지 않는 지점이 오며, 그 경계는 모델 크기와 데이터 치우침에 따라 어떻게 움직일까.
이해 확인
논문 그림 2(c)가 보여 주는 것으로 맞는 것은?
- 가끔 주고받은 모델들은 각자의 정확도도 평균 모델만큼 오른다
- 각 모델의 정확도는 비슷하지만, 평균했을 때 가끔 주고받은 쪽만 크게 좋아진다
- 통신이 없는 모델들도 평균하면 정확도가 두 배 가까이 오른다
- 가끔 주고받은 모델들은 학습 끝에 사실상 같은 모델로 모인다
각 모델의 정확도는 0.24와 0.19 안팎으로 비슷하지만, 평균하면 가끔 주고받은 쪽은 0.49로 오르고 통신이 없는 쪽은 0.01 근처로 무너진다(4.3절). 모델들은 한 점으로 모이지 않고 손실이 낮은 분지를 둘러싸므로 4번도 틀렸다(4.3절, 그림 1c).
논문 정보
- 제목: On the Surprising Effectiveness of a Single Global Merging in Decentralized Learning
- 저자: Tongtian Zhu (Zhejiang University), Tianyu Zhang (Mila, Quebec AI Institute and Université de Montréal), Mingze Wang (Peking University), Zhanpeng Zhou (Shanghai Jiao Tong University), Can Wang (Zhejiang University)
- 학회: ICLR 2026 구두 발표(Oral)
- 링크: arXiv 2507.06542, OpenReview, 코드