NeurIPS 2025 Oral
두 베타를 같게 둔 Adam은 잡음이 클수록 걸음을 줄이는 부호 모멘텀이다
딥러닝 옵티마이저
한 줄 요약
언어 모델을 1,500개 넘게 학습해 보니 부호 모멘텀(Signum)은 끝까지 튜닝해도 Adam에 못 미쳤고, Adam의 두 모멘텀 계수를 \(\beta_1=\beta_2\)로 묶어도 성능은 거의 그대로였다. 이렇게 묶은 Adam은 기울기의 평균과 분산을 온라인으로 추정하고, 잡음이 신호를 덮을수록 걸음을 줄이는 Signum으로 다시 쓸 수 있다.
무엇이 달라졌나
Adam이 언어 모델에서 SGD보다 왜 잘 되는지 밝히려고 최근 연구들은 Adam을 기울기 이동 평균의 부호만 쓰는 Signum 같은 단순한 방법과 견주어 왔다(2절). 이 논문은 그 비교를 큰 규모로 다시 했다.
1억 6천만(160M) 파라미터 모델을 친칠라 최적 예산인 SlimPajama 32억 토큰으로 학습했고(부록 A.1.1), 시퀀스 길이는 2,048, 배치는 256이다. 방법마다 학습률, 모멘텀, 클리핑을 격자로 훑었다(3.1절).
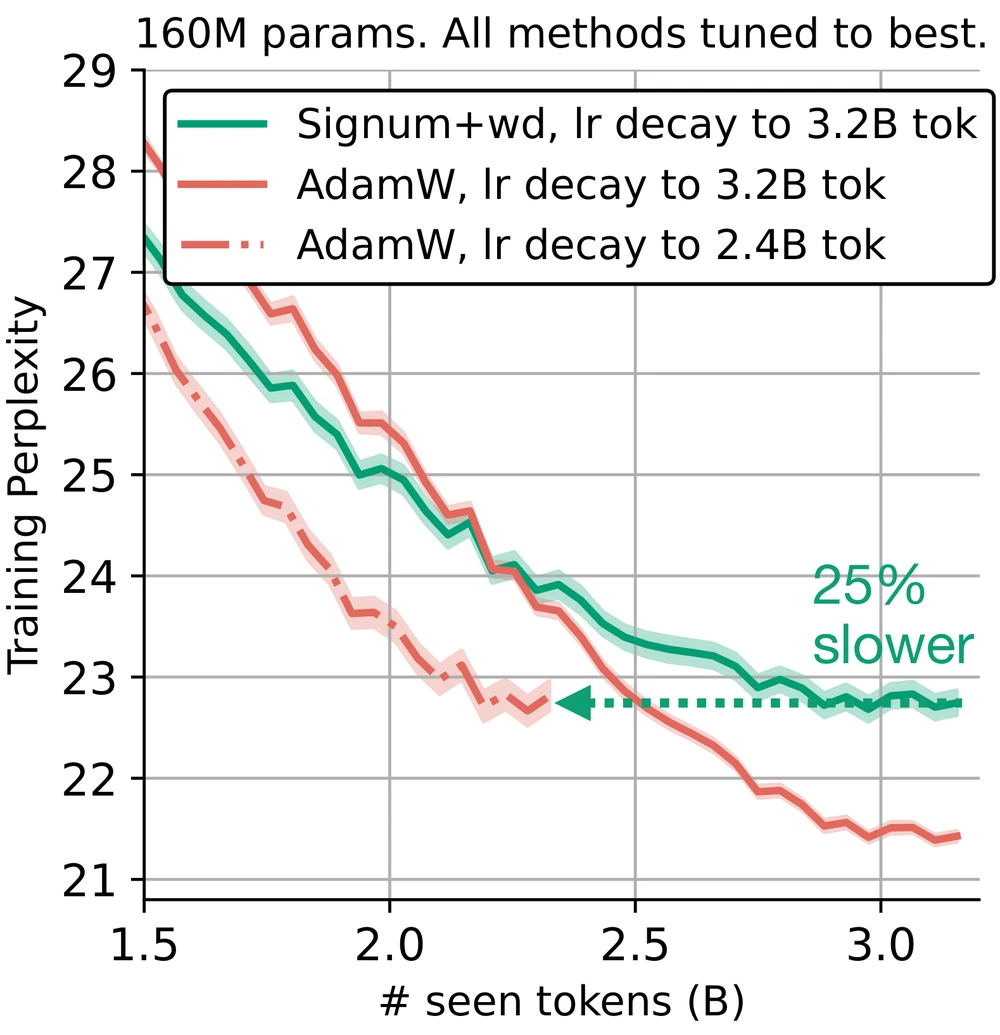
튜닝한 Signum의 검증 퍼플렉서티는 23.23으로, 모멘텀 SGD(53.62)와 Adam(21.86) 사이 간격의 96%를 메웠지만 끝내 Adam에 닿지 못했다(표 1). Adam은 예산의 4분의 3만으로 Signum의 최종 성능에 이른다(그림 1).
두 계수를 같게 두는 쪽은 거의 최적이었다. 같은 설정에서 Adam을 200번 돌리자 다섯 가지 \(\beta_1\) 모두에서 \(\beta_2=\beta_1\)이 최적에 가까웠고, 대부분의 Adam 실행이 가장 잘 튜닝한 Signum보다 나았다(그림 2). 배치 128, 256, 512로 500번을 더 돌린 실험에서 \(\beta_1=\beta_2\)는 격자 안의 최적보다 0.3 넘게 나빠진 적이 없다. 반면 Signum과 Adam의 간격은 1.37이었다(그림 3). 시퀀스 길이 512, 토큰 두 배, 가중치 감쇠를 끈 FineWeb에서도 결과는 같았다(3.2절). 4억 1천만(410M) 파라미터 모델 44개에서도 두 계수를 같게 둔 설정이 최적에 가까웠고, 흔히 쓰는 (0.9, 0.95)는 꽤 뒤처졌다(그림 5).
어떻게 보였나
이론은 두 계수를 \(\beta\) 하나로 묶고, 실험에서 영향이 작았던 \(\epsilon\)과 편향 보정을 뺀 한 좌표의 갱신 \(d_k=m_k/\sqrt{v_k}\)에서 출발한다(4절). \(m_k\)와 \(v_k\)는 기울기와 기울기 제곱의 지수 이동 평균이다. 두 계수가 같으면 \(v_k-m_k^2\)는 직전 평균과 새 기울기의 차이 제곱을 다시 평균한 \(\sigma_k^2=\beta\,\mathrm{EMA}_\beta[(m_{k-1}-g_k)^2]\)와 정확히 같다(명제 1). 그래서 갱신은 \(d_k=\mathrm{sign}(m_k)/\sqrt{1+\sigma_k^2/m_k^2}\)이 된다(식 9).
정리 4.1은 두 값이 무엇을 추정하는지 보인다. 새 기울기가 정규분포 \(\mathcal N(m,\sigma^2)\)에서 나왔을 가능도를 높이되, 직전 추정 \(\mathcal N(m_k,\sigma_k^2)\)에서 멀어진 만큼 KL 발산에 \(1/\lambda\)를 곱해 벌점으로 주는 문제(식 4)를 풀면, 해가 Adam의 두 이동 평균과 같은 갱신식이 되고 \(\beta=1/(1+\lambda)\)이다. Adam은 기울기의 평균과 분산을 온라인 변분 추론으로 따라가는 셈이다.
최급강하(steepest descent)로 보면 Signum은 반지름 1인 신뢰 영역(trust region) 안에서 \(-m_k\) 쪽으로 가장 멀리 가는 걸음이고(식 10), Adam은 반지름을 \(1/\sqrt{1+\sigma_k^2/m_k^2}\)로 줄인 걸음이다(식 11). 신호 대 잡음비 \(|m_k|/\sigma_k\)가 크면 둘이 같아지고, 잡음이 신호를 덮으면 Adam만 걸음을 줄인다. 아래 그림 (나)에서 신호 대 잡음비가 0.1일 때 Adam의 평균 갱신량은 0.10으로 반지름과 겹치지만 Signum은 0.49다.
(가) 잡음이 커질 때의 갱신량
(나) 신호 대 잡음비와 평균 갱신량
이 분해는 두 계수가 같을 때만 성립한다. \(\beta_1\neq\beta_2\)이면 \(v_k-m_k^2\)를 어떤 상수로도 이런 차이 제곱의 이동 평균으로 쓸 수 없다(부록 명제 2). Balles와 Hennig(2018)도 Adam을 신호 대 잡음비로 조절한 Signum으로 보았지만, \(v_k-m_k^2\)가 분산이라는 것은 가정이었다(4.2절). Signum에 고정된 완화 상수 \(\epsilon\)을 넣어 \(m_k/(\sqrt{m_k^2}+\epsilon)\)로 바꿔도 거의 나아지지 않았다(그림 4). 저자들은 분모의 분산 항이 시점과 파라미터 묶음마다 달라진다는 데 주목한다(5절).
눈여겨볼 점
“거의 최적”의 근거는 격자 실험이다. \(\beta\)는 \(1-\kappa(1-0.9)\)에서 \(\kappa\)를 2의 거듭제곱으로 바꿔 골랐고(3.1절), 저자들도 격자가 달라지면 결론이 바뀔 수 있으며 배치가 작으면 최적이 조금 비켜난다고 적었다(6절). 언어 모델 실험은 모두 4억 1천만 파라미터 이하다. Signum과의 간격도 설정을 탄다. 시퀀스 길이 512에서는 약 0.7로 줄었다(3.2절).
정리 4.1은 두 버퍼가 평균과 분산의 추정치라는 것까지만 보이고, 둘을 왜 이 몫으로 묶는지는 설명하지 않는다(6절). 블로그의 해석으로는, 이 설정이 잘 된다는 관찰과 깔끔하게 읽힌다는 관찰이 나란히 있을 뿐 뒤의 것이 앞의 것을 설명하지는 않는다.
열린 질문
- 기울기 평균과 분산의 온라인 추정치를 왜 \(m/\sqrt{m^2+\sigma^2}\)로 묶어야 하는가. 신호 대 잡음비를 다른 함수로 걸음 크기에 옮기는 규칙이 언어 모델에서 더 나은지, 이 몫이 어떤 최적성 원리에서 나오는지는 아직 모른다.
이해 확인
β₁ = β₂로 둔 Adam과 Signum의 관계로 논문이 보인 것은?
- Adam은 Signum과 같은 부호로 움직이되, 잡음이 클수록 걸음을 키운다
- Adam은 Signum과 같은 부호로 움직이되, 추정한 분산이 평균의 제곱에 비해 클수록 걸음이 짧아진다
- Adam은 Signum에 고정 상수 ε을 넣은 것이라, ε만 잘 고르면 Signum도 Adam만큼 된다
- β₁, β₂가 달라도 Adam의 분모는 늘 기울기 분산의 추정치로 쓸 수 있다
식 9에서 갱신은 sign(m)/√(1 + σ²/m²)이라 방향은 Signum과 같고, 잡음이 신호에 비해 클수록 크기가 줄어든다(식 11). 고정 ε을 넣은 Signum은 거의 나아지지 않았고(그림 4), 이 분해는 β₁ = β₂일 때만 성립한다(부록 명제 2).
논문 정보
- 제목: In Search of Adam’s Secret Sauce
- 저자: Antonio Orvieto (ELLIS Institute Tübingen, Max Planck Institute for Intelligent Systems, Tübingen AI Center), Robert M. Gower (Center for Computational Mathematics, Flatiron Institute)
- 학회: NeurIPS 2025 구두 발표(Oral)
- 링크: arXiv, OpenReview, 실험 자료와 코드