NeurIPS 2025 Oral, Best Paper Award
1000 Layer Networks for Self-Supervised RL: Scaling Depth Can Enable New Goal-Reaching Capabilities
강화학습도 층을 쌓으면 새 동작이 나온다
보상 없이 목표에 닿는 법을 대조 학습으로 배우는 강화학습에서 망을 1,024층까지 쌓자 성능이 계단처럼 뛰고 새 동작이 나타났다는 NeurIPS 2025 최우수 논문
강화학습, 목표 조건 강화학습, 대조 학습, 깊이 스케일링
3줄 요약
- 강화학습(reinforcement learning, RL)은 상태 벡터를 입력받는 과제에서 오래 2~5층짜리 망을 써 왔다. 저자들은 보상 없이 목표에 닿는 법을 배우는 대조 강화학습(contrastive RL, CRL)의 정책망(actor)과 비평가(critic)를 잔차 연결, 층 정규화, Swish 활성화로 쌓아 최대 1,024층까지 깊게 했다.
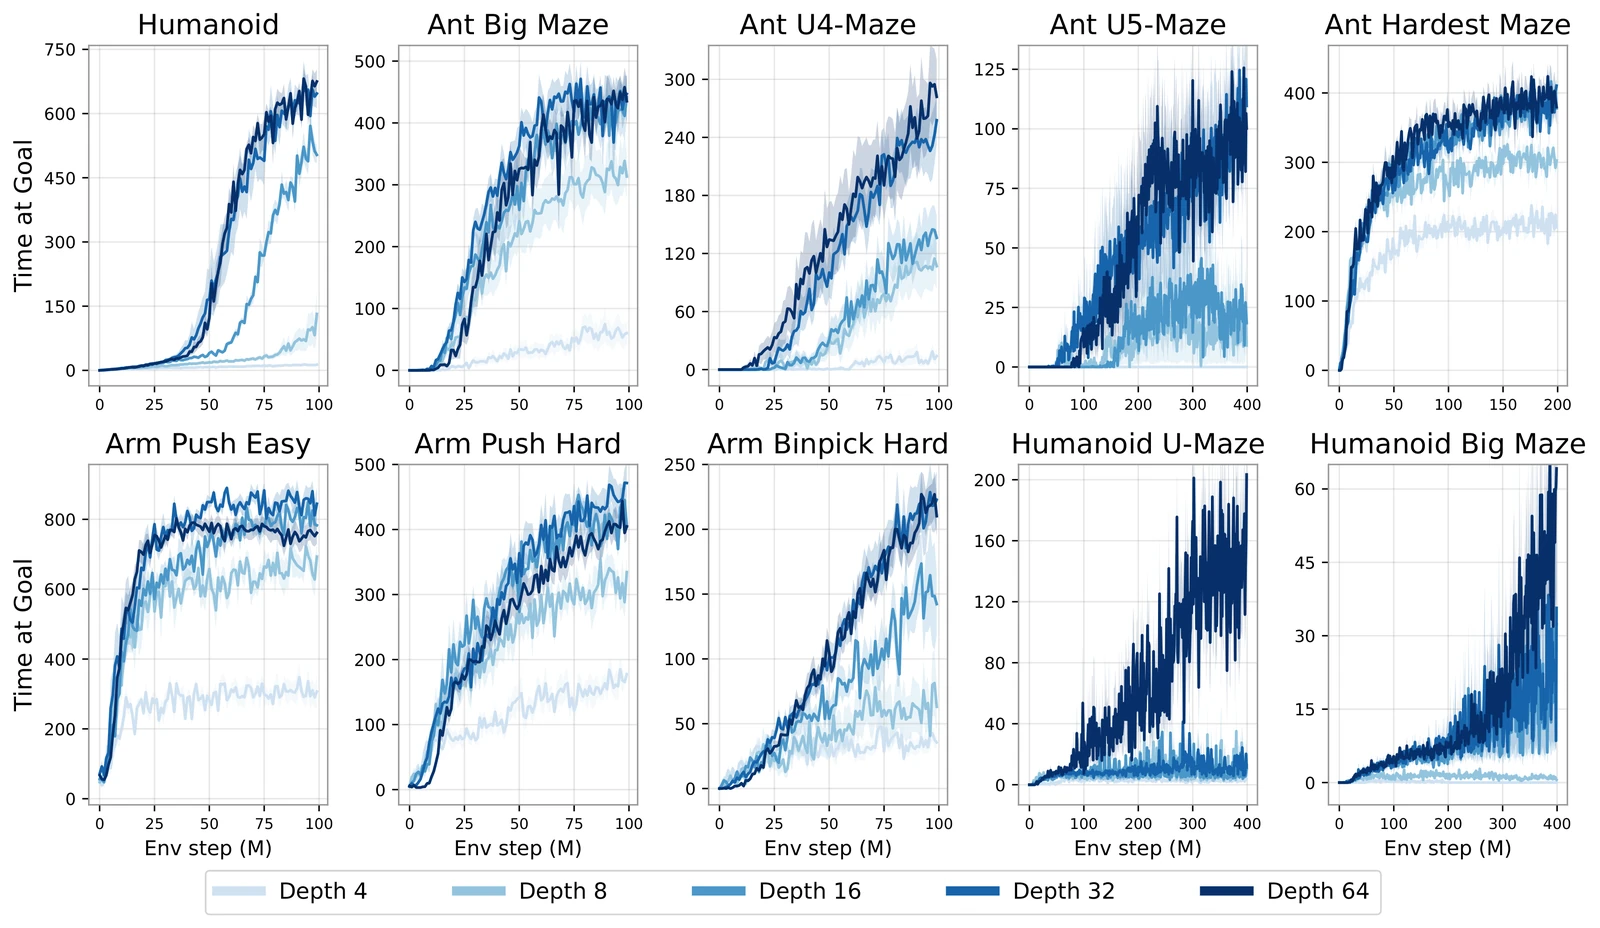
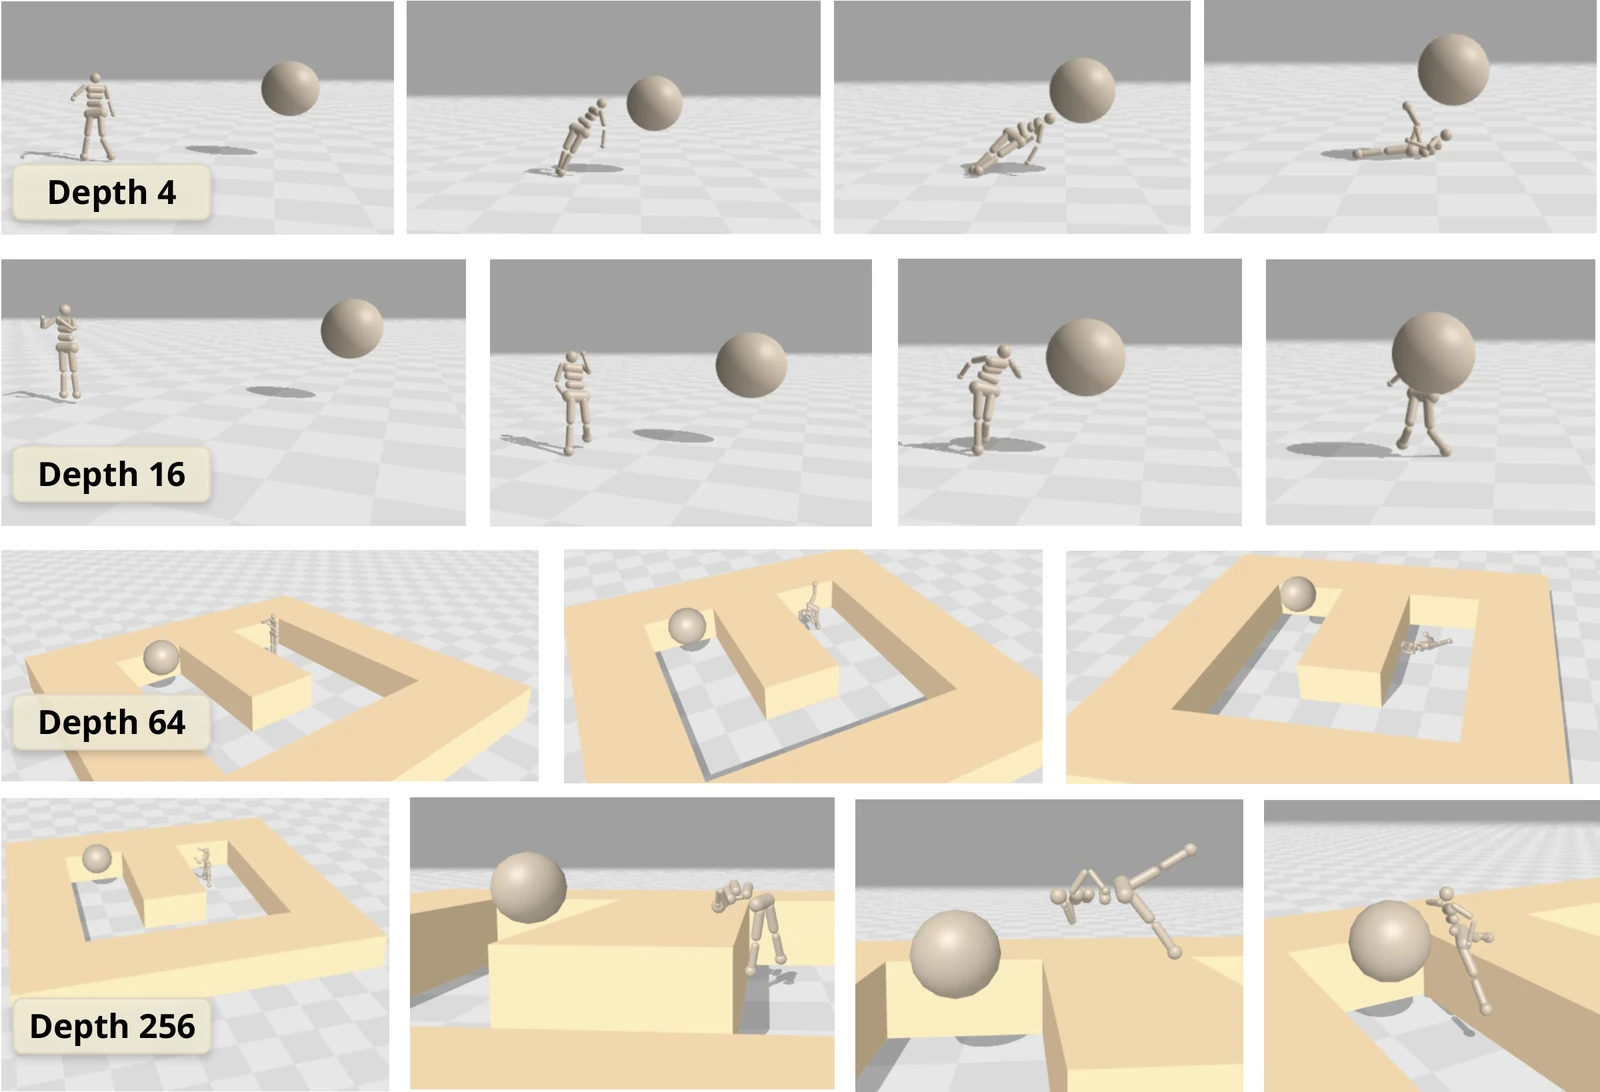
- 깊이를 4층에서 64층으로 늘리자 열 개 과제 중 다섯에서 성능이 20배 넘게 올랐다(부록 표 1). 성능은 매끈하게 오르지 않고 과제마다 다른 깊이에서 뛰었다. 휴머노이드는 그런 깊이에서 처음으로 똑바로 걷거나 벽을 넘었다(그림 1, 3).
- 저자들이 드는 까닭은 셋이다. 비평가가 회귀 대신 분류를 풀고, 깊은 망에서는 큰 배치가 효과를 내며, 탐색과 표현력이 서로를 키운다(4.4절, 4.5절). 같은 구조를 SAC 같은 시간차(TD) 방법이나 오프라인 학습에 쓰면 깊이의 득이 거의 없었다.
선정 이유
NeurIPS 2025 최우수 논문상(Best Paper Award) 네 편 가운데 하나이고 구두 발표(oral) 논문이다. 선정위원회는 강화학습이 주는 정보만으로는 깊은 망의 많은 매개변수를 이끌기 어려우니 큰 모델은 자기지도 학습으로 키우고 강화학습은 미세 조정에만 쓰자는 통념에 이 논문이 맞선다고 평했다. 위원회는 이 논문이 쉬운 방법으로 아주 깊은 망을 학습해 깊이를 늘릴수록 더 정교한 능력이 나온다는 것을 보였다고 적고, 깊은 망에서 배치 크기가 중요하다는 분석을 쓸모 있는 예로 들었다. 리뷰어 네 명은 모두 최종 5점(6점 만점, 수락)을 줬다.
- 전후로 아는 것이 달라졌나. 달라졌다. 강화학습 망을 키운 최근 연구는 폭을 넓혔고 깊이에서는 득이 작거나 손해라고 보고했다(2장). 이 논문은 알고리즘을 바꾸면 깊이로도 득을 볼 수 있고, 그 득이 못 풀던 과제를 풀게 되는 도약일 수 있음을 보였다.
- 새 질문을 여는가. 연다. 임계 깊이를 무엇이 정하는지, 왜 시간차 학습에서는 깊이가 통하지 않는지가 열려 있다.
- 일반화될 근거가 있나. 아직 좁다. 같은 구조로 깊이를 늘려도 SAC 계열의 이득은 4층에서 멈췄고, 오프라인 학습에서는 깊을수록 대개 나빠졌다(부록 A.2, A.8).
- 증거가 주장만큼 강한가. 큰 이득은 열 개 과제에서 시드 다섯 개로 일관됐다(그림 1). 1,024층의 이득은 한 과제, 시드 세 개에서 나왔고 오차 띠가 넓다(그림 12). 원인 분석은 과제 세 개 이하, 시드 세 개로 했다.
왜 중요한가
언어와 시각 모델은 층이 수백 개에 이르고(Llama 3, Stable Diffusion 3), 어떤 크기를 넘는 순간 못 하던 과제를 하게 되는 일도 흔하다(1장). 상태 벡터를 입력받는 강화학습에서는 Stable Baselines3나 CleanRL 같은 표준 구현이 2~5층 망을 쓴다. 비슷한 도약을 찾으려는 시도는 대개 작은 이득에 그쳤고, 그마저 작은 모델이 이미 어느 정도 풀던 과제에서였다.
강화학습에서 깊은 망이 어려운 까닭은 짐작할 만하다. 긴 관찰 끝에 드문 보상 하나를 받으니 매개변수 수에 비해 되먹임이 아주 적다. 학습 불안정, 가소성 상실(plasticity loss) 같은 문제도 거듭 보고됐다(2장). BRO(NeurIPS 2024)와 SimBa(ICLR 2025)가 잔차 연결로 망을 키웠지만 둘 다 폭을 넓힌 쪽이었고 4층 MLP를 썼다.
저자들은 보상이나 시연 없이 스스로 만든 과제로 배우는 자기지도 강화학습에, 데이터를 많이 모으는 GPU 시뮬레이터와 깊은 잔차망을 더한다. 셋 다 새 재료는 아니다. 합쳤을 때 깊이가 어떤 구실을 하는지가 질문이다.
핵심 아이디어
직관: 보상 대신 “같은 궤적의 미래인가”를 맞힌다
목표 조건 강화학습(goal-conditioned RL)에서 에이전트는 현재 상태 \(s\)와 함께 도달할 목표 \(g\)를 받는다(3장). 학습에는 보상을 쓰지 않고, 평가할 때만 한 에피소드 1,000걸음 가운데 목표 근처에 머문 걸음 수를 잰다(4.1절).
대조 강화학습은 가치를 회귀로 맞히지 않는다. 비평가는 상태와 행동을 받는 인코더 \(\phi(s,a)\)와 목표를 받는 인코더 \(\psi(g)\)로 이뤄지고, 두 표현이 가까울수록 높은 점수를 준다. 한 궤적의 \((s, a)\)와 그 뒤에 온 상태 하나가 양성 쌍이고, 배치 안 다른 궤적의 상태들이 음성이다. 비평가는 “이 미래가 내 궤적의 것인가”를 맞히는 분류기이고, 정책은 이 점수를 키우는 행동, 곧 표현 공간에서 목표에 다가가는 행동을 고르도록 배운다.
(가) 비평가 학습: 같은 궤적의 미래 고르기
(나) 행동 고르기: 목표 표현에 다가가기
방법: 세 가지 재료
자기지도 알고리즘. Eysenbach 외(NeurIPS 2022)의 CRL을 그대로 쓴다. 자기 예측을 다시 목표로 삼는 부트스트래핑 없이 교차 엔트로피 꼴의 분류 손실로 비평가를 배운다.
많은 데이터. JaxGCRL은 환경 512개를 GPU에서 한꺼번에 돌려 과제마다 1억~4억 걸음을 모은다. 배치는 512, 할인율은 0.99다(부록 표 7).
깊은 잔차망. 잔차 블록 하나는 Dense 층, 층 정규화(layer normalization), Swish 활성화를 네 번 거친 뒤 입력을 더한다(\(\mathbf{h}_{i+1}=\mathbf{h}_i+F_i(\mathbf{h}_i)\), 3장, 그림 2). 깊이는 블록 안 Dense 층의 수라서 1,024층이면 블록이 256개다. 정책망과 두 인코더를 같은 깊이로 키우고, 폭은 기본 256, 표현은 64차원이다(4.1절, 부록 표 7).
수식: 비평가는 무엇을 배워야 하나
배치에서 \((s_i, a_i, g_i)\)는 같은 궤적에서, \(g_j\)는 다른 궤적에서 뽑는다. 비평가는 InfoNCE 손실 \(\mathcal{L}\)을 줄이고, 정책은 점수 \(f\)의 기댓값을 키운다(3장).
\[ f(s,a,g) = -\lVert\phi(s,a)-\psi(g)\rVert_2 \]
\[ \mathcal{L}(\phi,\psi) = -\,\mathbb{E}\sum_{i}\log\frac{e^{f(s_i,a_i,g_i)}}{\sum_{j} e^{f(s_i,a_i,g_j)}} \]
\[ \max_{\pi}\ \mathbb{E}_{a\sim\pi(\cdot\mid s,g)}\big[f(s,a,g)\big] \]
미래 상태를 할인율에 따라 뽑으므로, 최적의 \(f\)는 정책을 따를 때 \(g\)를 방문할 할인 확률 \(p^{\pi}_{\gamma}(g\mid s,a)\)를 \(g\)의 주변 확률로 나눈 값의 로그에 \((s,a)\)마다 다른 상수를 더한 꼴이다(Eysenbach 외 2022). 이 방문 확률이 3장이 정의한 목표 조건 Q 함수다. 블로그의 해석으로는 손실에 더한 logsumexp 벌점(부록 표 7)이 그 상수를 0 근처로 묶어 상태끼리 점수를 비교할 수 있게 한다.
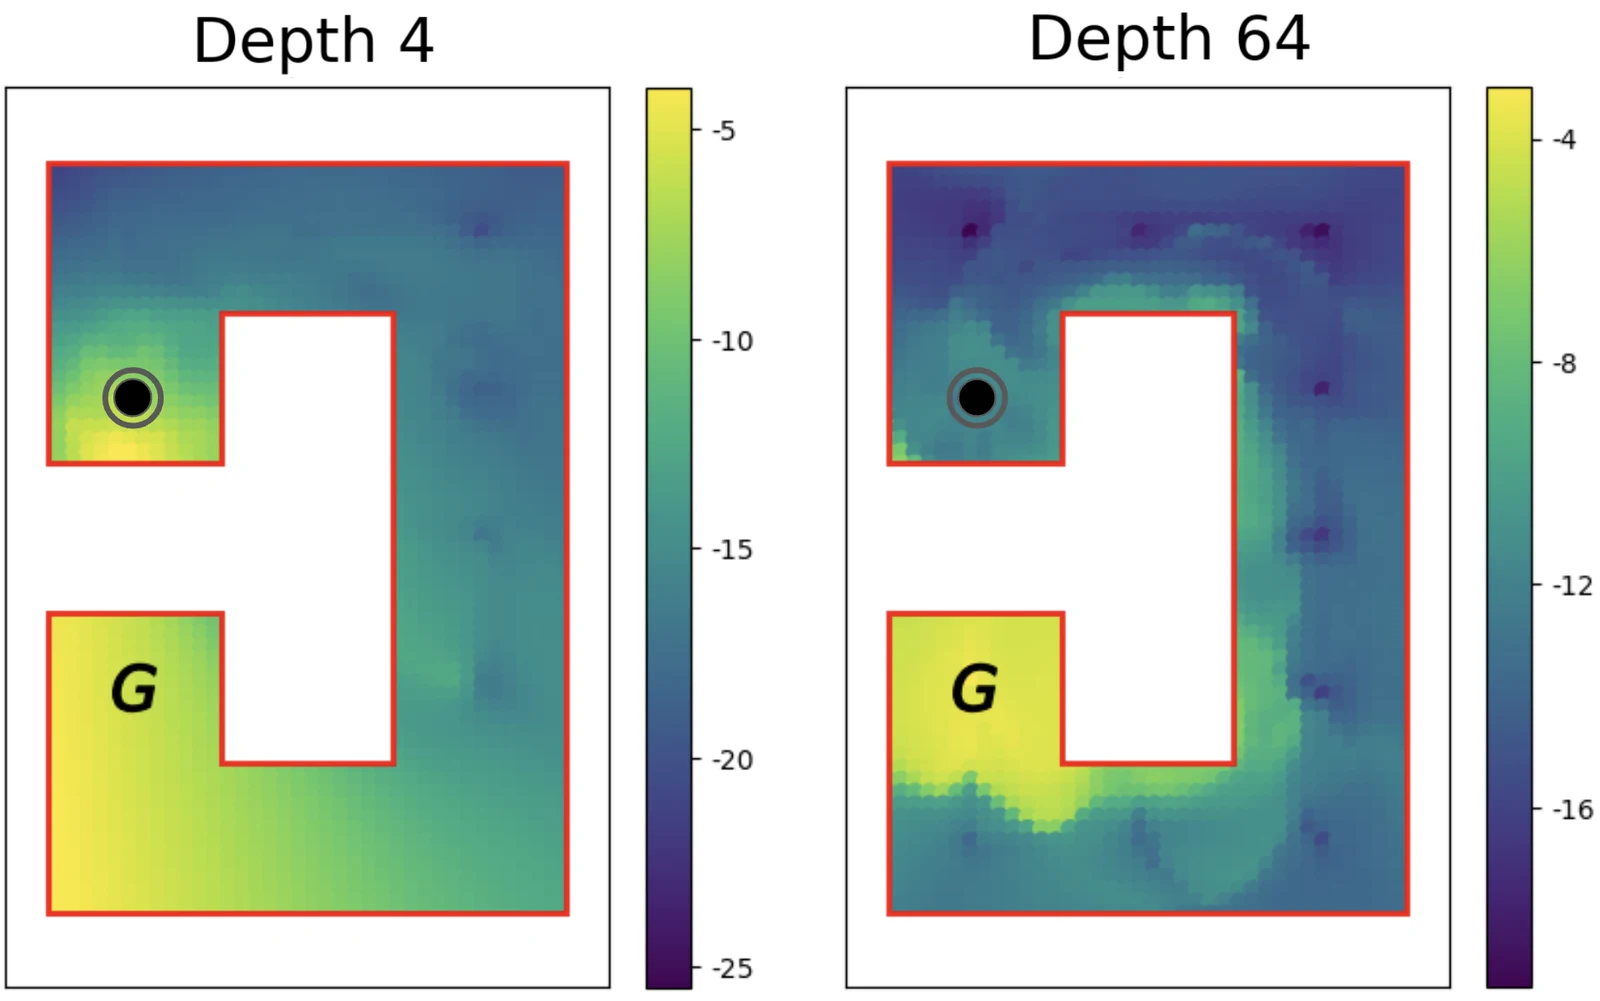
U자 미로에서 이 값을 계산하면 다음과 같다.
(가) 직선 거리 (부호를 바꿈)
(나) 목표를 방문할 할인 확률의 로그
직선으로 7칸인 출발점이 실제로는 21칸을 돌아가야 하는 곳이다. 좋은 비평가는 이 꺾임을 표현 공간의 거리에 담아야 하고, 블로그의 해석으로는 거기에 표현력이 든다. 뒤의 그림 9는 깊이가 그 표현력을 준다는 정황이다.
결과 해설
성능은 계단처럼 뛴다(4.2절, 4.3절). 64층은 4층에 비해 로봇 팔 과제에서 2.4~5.7배, 긴 미로 Ant U4-Maze와 U5-Maze에서 25배와 63배, Humanoid와 Humanoid U-Maze에서 약 50배 높았다(부록 표 1). Humanoid는 목표 근처 걸음이 12.6에서 649가 됐다. 곡선은 고르게 오르지 않는다. Ant Big Maze는 8층에서, Humanoid U-Maze는 64층에서 크게 뛰었다.
뛰는 자리마다 동작이 바뀐다. 4층 휴머노이드는 목표 쪽으로 몸을 던지며 쓰러지고, 16층에서 처음으로 똑바로 걷는다. U자 미로에서 64층은 벽 앞에서 넘어지고, 256층은 몸을 접어 벽을 넘거나 벽 위에 앉아 비집고 넘어간다(그림 3).
세 부품이 다 있어야 한다(그림 5, 부록 A.5). 잔차 연결 없이 32층을 쌓으면 점수가 0.02로 무너지고, 잔차 연결을 두면 16층 518, 32층 635로 뛴다. 층 정규화를 빼면 64층도 13 안팎에 머물고, ReLU를 쓰면 64층이 185로 Swish(673)에 한참 못 미쳤다.
폭보다 깊이(4.4절, 그림 4, 6). 4층에서 폭을 2,048까지 넓힌 망은 폭 256에 깊이만 8층으로 늘린 망을 세 과제 모두에서 넘지 못했다. Humanoid에서 각각 약 150과 560이었고(그림에서 읽은 값), 매개변수는 폭 쪽이 30배 가까이 많다. 정책망과 비평가 중 어느 쪽이 중요한지는 과제마다 달랐고, Humanoid는 둘 다 키워야 했다.
깊어야 배치가 산다(4.4절, 그림 7). 4층에서는 배치를 128에서 2,048로 키워도 거의 차이가 없었다. 64층에서는 배치 256이 약 300, 512 이상이 약 700이었다(Humanoid, 그림에서 읽은 값). 저자들은 큰 배치는 큰 모델과 짝을 이룰 때 득이 된다는 다른 분야의 관찰로 이를 읽는다. 블로그의 해석으로는 InfoNCE에서 배치 크기가 곧 음성 표본의 수라서, 기울기 잡음이 준 덕인지 음성이 늘어난 덕인지는 이 실험만으로 가를 수 없다.
탐색과 표현력(4.5절, 그림 8). 수집기 하나가 재생 버퍼를 채우고, 깊은 학습기와 얕은 학습기는 그 버퍼로만 배운다. 데이터가 같으니 두 학습기의 차이는 표현력에서 온다. 32층 수집기의 데이터로는 세 과제 모두 깊은 학습기가 크게 앞섰고, 4층 수집기의 데이터로는 Humanoid에서 둘 다 거의 0이었다. 저자들은 표현력이 크면 더 넓게 탐색하고, 데이터가 넓어야 표현력이 산다고 정리한다.
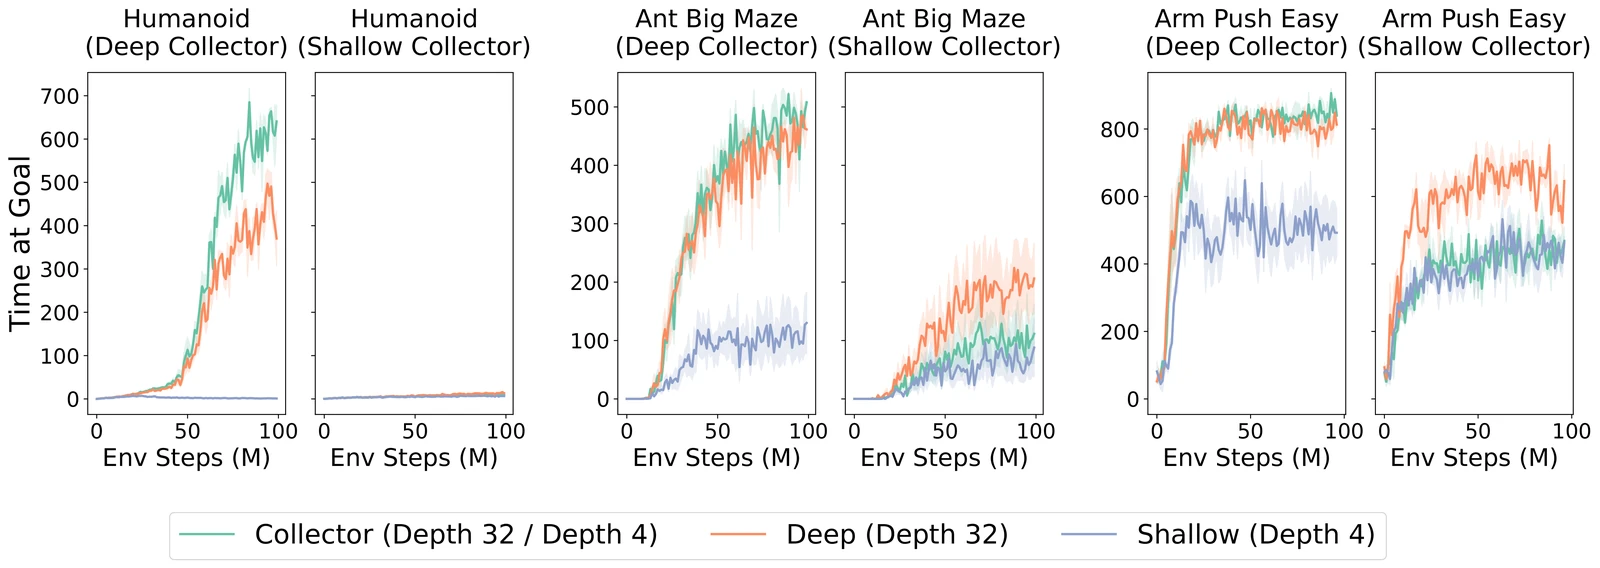
다만 4층 수집기 쪽은 과제마다 다르다. Ant Big Maze와 Arm Push Easy에서는 좁은 데이터로도 깊은 학습기가 얕은 학습기와 수집기를 넘었다(Arm Push Easy에서 약 600 대 450). 블로그의 해석으로는 “데이터가 좁으면 깊어도 소용없다”는 본문 문장은 Humanoid에만 온전히 맞는다.
비평가가 미로를 배운다(4.5절, 그림 9, 11). Ant U4-Maze에서 4층 비평가는 벽 너머 출발점 근처에도 높은 값을 줘 직선 거리를 따르는 듯하고, 64층은 목표에서 안쪽 벽을 따라 높은 값을 이어 간다. 앞 계산 그림의 (가)와 (나)다. 출발점과 목표가 3칸 안쪽인 쌍으로만 학습하고 6칸을 돌아가야 하는 쌍으로 평가하자 깊이 4, 16, 64의 점수가 약 170, 240, 360이었다(그림에서 읽은 값). 짧은 경험을 이어 긴 과제를 푸는 이어 붙이기(stitching)가 일부 일어난 셈이다.
1,024층과 기준선(그림 12, 부록 A.1). Humanoid U-Maze는 256층과 1,024층에서 더 올랐다. 1,024층은 정책망 손실이 학습 초기에 폭발해서 정책망을 512층으로 두었다. Humanoid Big Maze에서는 256층, 512층이 64층과 뚜렷이 다르지 않았다. 깊은 CRL은 열 과제 중 여덟에서 SAC 같은 기준선을 앞섰다.
얼마나 드나(부록 B.3). 64층 학습에 Humanoid는 11시간, Humanoid U-Maze는 47시간이 걸렸다(표 3). 4층부터 64층까지 다섯 깊이를 시드 다섯 개씩 돌리면 Humanoid는 약 120시간, Humanoid U-Maze는 약 550시간이다. 저자들은 심사 답변에서 1,024층까지 모든 실험을 80GB A100 한 장으로 돌릴 수 있다고 밝혔다. 블로그의 해석으로는 GPU 네 장이면 Humanoid 스윕은 하루 남짓, Humanoid U-Maze는 엿새쯤이다.
(가) 깊이와 폭에 따른 매개변수
(나) 깊이에 따른 학습 시간
의심해볼 점
- “깊이가 통한다”의 범위. 대조 강화학습, 온라인 학습, JaxGCRL이 함께 있을 때의 결과다. 시간차 방법, 행동 복제, QRL에서는 득이 없었고 오프라인 CRL은 깊을수록 대개 나빠졌다(4.6절, 부록 A.3, A.8). 블로그의 해석으로는 깊이를 강화학습 일반의 축이 아니라, 분류형 목표와 많은 온라인 데이터가 함께 있을 때 열리는 축으로 읽는 편이 안전하다.
- 계단의 정체. 왜 특정 깊이에서 뛰는지 묻자 저자들은 LLM의 창발 능력에 빗대어, 걷기처럼 협응이 일정 수준을 넘어야 목표에 닿는 과제에서는 조금씩 나아지는 실력이 계단처럼 드러난다고 답했다. 블로그의 해석으로는 “목표 근처 걸음 수”라는 지표가 문턱을 품고 있어서, 계단의 출처를 가리려면 손실 같은 연속 지표를 깊이별로 봐야 한다. 논문에는 그런 비교가 없다.
- 실행 사이의 차이. 같은 Humanoid 64층 점수가 부록 표 1에서는 649, 그림 4와 부록 그림 13에서는 750 안팎이다.
- SAC와의 비교. 본문은 휴머노이드 미로에서 SAC가 초반에만 앞서고 결국 비슷해진다고 썼지만(4.2절), 부록 표 6에서 64층 CRL은 이 두 과제에서 SAC의 최종 성능에 닿지 못했다. SAC는 보상을 쓰고 CRL은 쓰지 않으니 같은 조건의 비교도 아니다.
- 본문의 작은 오류. 3장의 비평가 식에는 음의 부호가 빠져 있다(코드와 그림 9의 값은 −‖φ − ψ‖). 4.4절은 매개변수가 폭에 선형, 깊이에 제곱으로 는다고 썼지만 반대다(위 그림의 (가)).
리뷰어들이 짚은 점
한 리뷰어는 답변을 보고 4점에서 5점으로 올렸다. 영역 의장은 새 동작, 배치 분석, 이어 붙이기 분석을 특히 꼽았다.
- 새로움과 설명. 쓰인 기법이 모두 기존 것이라 새로움이 규모의 효과에 있고, 계단의 이론적 설명이 없다는 지적이 나왔다.
- 일반성. 결과가 CRL과 온라인 학습에 묶여 있다는 지적에, 저자들은 오프라인 GCBC가 이 구조로는 깊이를 따라 좋아지고(2층 0.474, 32층 0.634) 기본 MLP로는 32층에서 0.210으로 무너진다는 결과를 더했다(부록 A.3).
- 비용과 구조. 학습 시간을 묻자 시간 표를 더했고(부록 B.3, B.4), 층 정규화 대신 Simba-v2의 초구면 정규화를 써도 같은 경향임을 보였다(부록 A.6).
계보
- 목표 조건 강화학습과 대조 학습. Kaelbling(IJCAI 1993)이 목표 도달 학습을 정식화했고, HER(Andrychowicz 외, NeurIPS 2017)는 실패한 궤적을 실제로 닿은 상태를 목표로 삼아 다시 썼다. Eysenbach 외(NeurIPS 2022)가 이를 대조 표현 학습으로 풀어 CRL을 냈다. JaxGCRL은 Bortkiewicz 외(ICLR 2025)가 만들었다.
- 강화학습 망 키우기. BRO와 SimBa는 폭을 넓혔다. Farebrother 외(ICML 2024)는 가치 학습을 분류로 바꿔 큰 망을 학습했고, 저자들은 이 논문을 분류가 강화학습 확장의 재료라는 두 번째 증거로 본다(2장).
- 후속 연구. 2026년 10월 기준 Semantic Scholar 인용은 46편이다. 같은 연구진은 이어 붙이기에 망 크기가 시간차 학습 여부보다 중요하다고 보고했고(arXiv 2510.21995), 정책의 계산량을 매개변수 수와 떼어 다뤘다(Ghugare 외, ICML 2026). 목표에 머무는 시간을 분류로 배우는 생존 강화학습(arXiv 2605.31273)은 긴 이동 과제에서 깊은 CRL을 2~8배 앞섰다고 보고한다.
- 이 블로그의 이전 글. 같은 해 최우수 논문인 확산 모델 암기 논문과, 층을 쌓으면 야코비안이 어떻게 변하는지 다룬 야코비안 특이값 글이 있다.
열린 질문
- 임계 깊이는 무엇이 정하나. 과제의 어떤 성질이 성능이 뛰는 깊이를 정하는지, 그 계단이 지표의 문턱에서 오는지 표현의 변화에서 오는지는 열려 있다.
- 왜 대조 목표에서만 통하나. 시간차 방법이 깊이로 나아지지 않는 까닭이 부트스트래핑 목표의 흔들림인지, 회귀 손실인지, 탐색의 차이인지는 가려지지 않았다.
- 데이터의 폭과 깊이. 깊이가 탐색과 짝을 이뤄야 통한다면, 고정된 데이터셋에서 깊이가 득이 되는 조건도 데이터가 덮는 범위로 설명할 수 있을까.
이해 확인
1. 이 논문에서 비평가를 학습시키는 신호는?
- 환경 보상을 할인해 더한 값을 회귀로 맞히는 손실
- 같은 궤적의 미래 상태를 배치 안 다른 궤적의 상태들 가운데서 골라내는 분류 손실
- 전문가 시연의 행동을 따라 하는 손실
- 다음 상태를 그대로 복원하는 예측 손실
비평가는 φ(s, a)와 ψ(g)의 거리로 점수를 매기고, 같은 궤적의 미래 상태가 다른 상태들보다 높은 점수를 받도록 InfoNCE로 배운다(3장). 보상은 평가에만 쓴다(4.1절).
2. 32층 수집기의 버퍼로만 학습한 깊은 학습기가 얕은 학습기를 크게 앞섰다(그림 8). 이 결과가 직접 보여 주는 것은?
- 깊이의 이득은 모두 더 넓은 탐색에서 온다
- 얕은 망도 좋은 데이터만 있으면 깊은 망을 따라잡는다
- 데이터를 같게 묶어도 깊은 망이 더 잘 배우므로, 표현력 자체가 이득의 일부다
- 깊이를 늘리면 배치를 줄여도 된다
두 학습기는 같은 버퍼로 배우니 탐색의 차이가 없고, 남는 차이는 표현력이다(4.5절). 탐색의 몫은 4층 수집기 실험에서 따로 드러나며 그 결과는 과제마다 달랐다.
3. Humanoid에서 배치를 128부터 2,048까지 바꾼 실험(그림 7)의 결과는?
- 깊이와 상관없이 배치가 클수록 크게 좋아졌다
- 4층에서는 거의 차이가 없었고, 16층과 64층에서는 배치를 키울수록 크게 좋아졌다
- 깊은 망일수록 큰 배치에서 불안정해져 나빠졌다
- 배치 크기는 대조 손실의 음성 표본 수와 상관이 없어 영향이 없었다
작은 망에서는 득이 없다가 망이 깊어지자 큰 배치의 이득이 나타났다(4.4절). InfoNCE에서는 배치 안 다른 궤적의 상태가 음성이므로 배치가 클수록 음성 표본도 많다.
논문 정보
- 제목: 1000 Layer Networks for Self-Supervised RL: Scaling Depth Can Enable New Goal-Reaching Capabilities
- 저자: Kevin Wang, Ishaan Javali, Benjamin Eysenbach (Princeton University), Michał Bortkiewicz, Tomasz Trzciński (Warsaw University of Technology)
- 학회: NeurIPS 2025 구두 발표(Oral), 최우수 논문상(Best Paper Award)
- 링크: arXiv 2503.14858, OpenReview, 코드