NeurIPS 2025 Oral, Best Paper Runner-up
언어 모델의 손실은 왜 폭에 반비례해 줄어들까
특징을 버리지 않고 겹쳐 담으면 손실이 빈도 분포와 상관없이 폭에 반비례한다는 것을 장난감 모델과 공개 LLM으로 보인 NeurIPS 2025 최우수 논문 차점작
스케일링 법칙, 중첩, 표현 기하, 해석 가능성
3줄 요약
- 언어 모델은 5만 개가 넘는 토큰을 고작 수천 차원에 담는다. 이 논문은 Elhage 외(2022)의 중첩(superposition) 장난감 모델에 행별 가중치 감쇠를 더해 중첩의 정도를 조절하고, 손실이 폭 \(m\)에 따라 어떻게 줄어드는지 쟀다.
- 자주 나오는 특징 \(m\)개만 담고 나머지를 버리는 약한 중첩에서는 손실이 버린 특징의 빈도 합이라, 빈도가 거듭제곱으로 줄 때만 손실도 거듭제곱 법칙을 따른다(3.1절). 모든 특징을 겹쳐 담는 강한 중첩에서는 손실이 표현 벡터의 겹침에서 오고, 겹침의 제곱이 \(1/m\) 규모라 손실도 빈도 분포와 거의 상관없이 \(1/m\)로 준다(3.2절).
- 공개 LLM 네 계열의 출력층도 모든 토큰을 겹쳐 담고 있었고, 평가 손실 가운데 폭에 달린 부분의 지수는 \(0.91 \pm 0.04\)였다(그림 6).
선정 이유
NeurIPS 2025 구두 발표(Oral) 논문이고, 최우수 논문상 차점(Best Paper Runner-up) 세 편 가운데 하나다. 선정위원회는 이 논문이 스케일링 법칙의 관찰을 넘어, 표현 중첩이 그 법칙을 좌우하는 주된 메커니즘임을 보이려 했다고 평했다. 통제된 장난감 모델과 정교하게 설계한 실험들이 핵심 결과를 받친다는 평도 덧붙였다.
- 전후로 아는 것이 달라졌나. 달라졌다. 기존 설명은 대개 데이터의 거듭제곱 꼬리를 가정하고 그 지수를 물려받았다. 이 논문은 데이터 분포에 거의 좌우되지 않는 지수 1이 표현의 기하에서 나올 수 있음을 보였고, 기존 설명들을 약한 중첩이라는 한 영역으로 정리했다(4장).
- 새 질문을 여는가. 연다. 폭과 깊이가 손실을 어떻게 나눠 갖는지, 중첩을 북돋우는 구조가 지수 대신 계수를 바꾸는지가 질문이 된다(5장).
- 일반화될 근거가 있나. 장난감 모델 안에서는 넓다. 빈도 분포 세 가지에서 강한 중첩의 지수가 0.89에서 1.01 사이였고(부록 D.1), 활성 밀도를 바꿔도 지수는 같았다(부록 D.4). 다만 특징끼리 독립인 오토인코더라는 단순한 설정이다.
- 증거가 주장만큼 강한가. 장난감 모델의 현상은 탄탄하고, LLM 쪽은 정황 증거에 가깝다. 출력층의 겹침이 \(1/m\)로 준다는 관찰은 무작위 벡터도 보이는 성질이고, 지수 0.91은 폭과 함께 깊이도 바뀌고 학습 데이터도 계열마다 다른 모델들을 한 식에 맞춘 값이다.
왜 중요한가
언어 모델을 키우면 손실이 예측 가능하게 준다. Kaplan 외(2020)와 Hoffmann 외(2022)는 손실이 모델 크기, 데이터 양, 계산량의 거듭제곱으로 준다고 보고했고, 이 경험 법칙이 대형 모델 개발을 이끌어 왔다. 그런데 왜 하필 거듭제곱인지, 지수는 무엇이 정하는지는 아직 결론이 나지 않았다(1장).
기존 설명은 모델이 클수록 데이터 다양체를 더 잘게 근사한다거나(Bahri 외, 2024), 중요한 기술을 순서대로 하나씩 더 배운다거나(Michaud 외, 2023), 커널 고윳값이 거듭제곱으로 준다고(Maloney 외, 2022) 본다. 어느 쪽이든 데이터나 스펙트럼에 거듭제곱 꼬리를 가정해야 손실도 거듭제곱이 되고, 지수는 그 꼬리의 모양에 예민하다.
저자들은 다른 병목을 본다. 언어 모델은 토큰마다 벡터를 배워 은닉 공간에 넣고 출력층(language model head)에서 다시 토큰으로 읽어 낸다. 5만 개가 넘는 토큰을 수천 차원에 담으려면 표현의 질이 폭에 묶일 수밖에 없다. 차원보다 많은 특징을 담는 방법이 중첩인데(Elhage 외, 2022), 저자들은 기존 이론이 은연중에 중첩이 약한 상황을 가정해 왔다고 지적한다. 그렇다면 중첩이 강할 때 손실은 폭에 따라 어떻게 줄어드는가. 이것이 논문의 질문이다.
핵심 아이디어
직관: 버리느냐, 겹쳐 담느냐
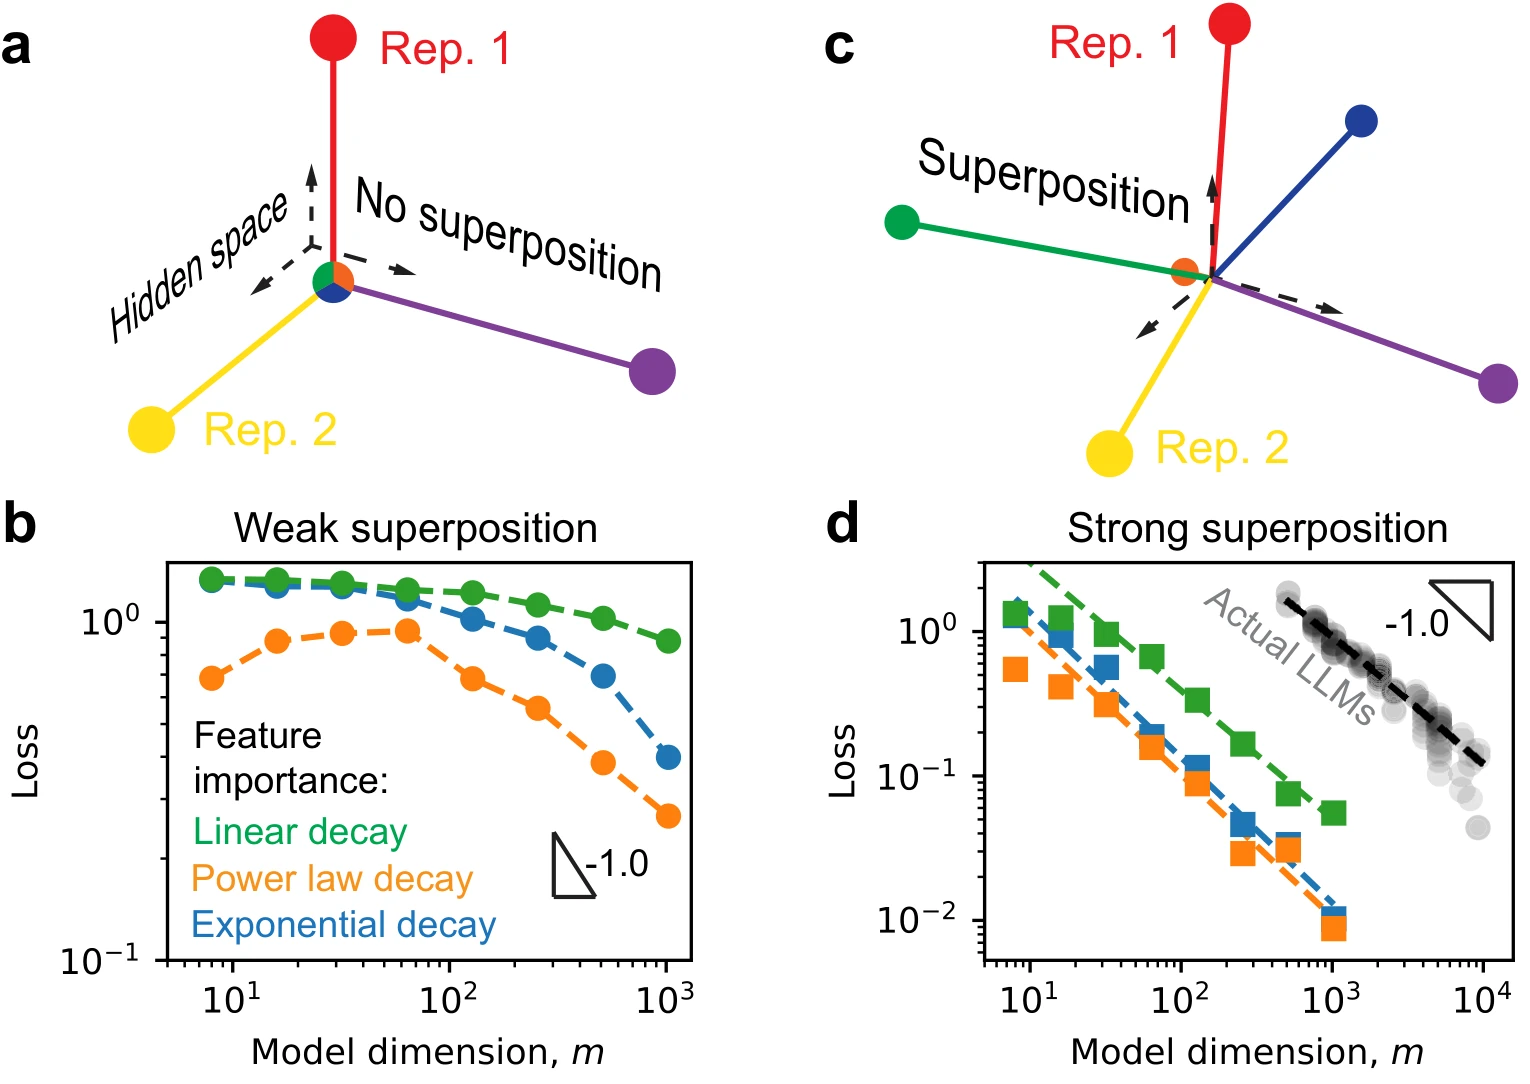
차원이 \(m\)인 공간에 \(m\)개보다 많은 특징을 담는 방법은 둘이다. 가장 자주 나오는 특징 \(m\)개에 서로 직교하는 방향을 주고 나머지는 버릴 수 있다. 간섭은 없지만 버린 특징은 복원하지 못한다. 아니면 모든 특징에 방향을 주고 서로 조금씩 겹치게 둘 수 있다. 모두 담기는 대신, 한 특징이 켜지면 겹친 특징들도 조금씩 켜진 것처럼 읽힌다.
(가) 약한 중첩: 버린다
(나) 강한 중첩: 겹쳐 담는다
첫째 방식의 손실은 버린 특징이 얼마나 자주 나오느냐로 정해지니 빈도 분포를 그대로 닮는다. 둘째 방식의 손실은 방향들이 얼마나 겹치느냐로 정해지고, 겹침은 고차원 기하의 문제라 데이터 분포와 무관한 법칙을 따를 수 있다.
방법: 가중치 감쇠로 중첩을 조절한다
장난감 모델은 Elhage 외(2022)의 오토인코더를 조금 고친 것이다(2장). 입력 \(x \in \mathbb{R}^n\)의 성분 \(x_i\)는 특징 \(i\)의 활성으로, 확률 \(p_i\)로 켜지고 켜지면 0과 2 사이의 균등한 값을 갖는다(식 1). 특징 번호는 빈도 순이고, 켜지는 특징 수의 기댓값 \(E=\sum_i p_i\)를 활성 밀도라 부른다. 모델은 입력을 \(m\)차원으로 눌렀다가 같은 행렬로 다시 펼친다.
\[ y=\mathrm{ReLU}\big(W W^\top x+b\big),\qquad L=\big\langle \lVert y-x\rVert_2^2\big\rangle_x,\qquad W\in\mathbb{R}^{n\times m} \]
\(W\)의 \(i\)번째 행 \(W_i\)가 특징 \(i\)의 표현 벡터다. 0이 아닌 행이 \(m\)개를 넘으면 중첩이다. 선형 모델에서는 간섭이 커서 중첩이 손해지만, ReLU와 음의 편향이 작은 간섭을 잘라 내면 빈도가 고르고 입력이 희소할 때 중첩이 유리해진다(2장).
저자들이 더한 장치는 행마다 거는 가중치 감쇠다(식 2). \(\gamma \ge 0\)이면 보통의 분리형 감쇠(decoupled weight decay)이고, \(\gamma<0\)이면 \((\lVert W_i\rVert_2-1)^2\)에 대한 경사 하강처럼 각 행의 노름을 1 쪽으로 끌어당긴다.
\[ W_{i,t+1}=\begin{cases} W_{i,t}-\eta_t\,\gamma\, W_{i,t}, & \gamma\ge 0\\[2pt] W_{i,t}-\eta_t\,\gamma\, W_{i,t}\big(1/\lVert W_{i,t}\rVert_2-1\big), & \gamma<0\end{cases} \]
\(\gamma\)가 크면 행의 노름이 0 근처와 1 근처로 갈리고, 노름이 1/2보다 큰 행의 비율 \(\phi_{1/2}\)(식 3)가 \(m/n\)까지 떨어진다. \(\gamma\)가 작거나 음수이면 거의 모든 행이 노름 1 근처라 \(\phi_{1/2}\approx 1\)이다(그림 3). 본문의 실험은 \(n=1000\), \(m=10\sim100\), \(E=1\), \(p_i\propto 1/i^{\alpha}\)로 두고 손실을 \(L\propto 1/m^{\alpha_m}\)로 맞춰 모델 지수 \(\alpha_m\)을 얻는다(3장).
수식: 꼬리의 합과 겹침의 기하
약한 중첩. 가장 잦은 특징 \(\phi_{1/2}n\)개를 간섭 없이 담고 나머지를 버리면, 버린 특징은 편향을 평균값에 맞추는 것이 최선이고 손실은 그 분산의 합이다(식 4).
\[ L=\sum_{i>\phi_{1/2}n}\big(\langle v^2\rangle p_i-\langle v\rangle^2 p_i^2\big)\ \approx\ \frac{4}{3}\sum_{i>\phi_{1/2}n}p_i \]
이상적으로 \(\phi_{1/2}n=m\)이고 \(p_i\propto 1/i^{\alpha}\)(\(\alpha>1\))이면 꼬리의 합이 \(m^{-(\alpha-1)}\)로 줄어 \(\alpha_m=\alpha-1\)이다(결과 1). 빈도가 지수적으로 줄면 손실도 지수적으로 줄 뿐 거듭제곱이 아니다. 거듭제곱을 넣어야 거듭제곱이 나오는 셈이고, 저자들은 양자화 모델이나 커널 이론 같은 기존 설명이 이 영역에 속한다고 본다(4장).
강한 중첩. 특징 \(j\) 하나만 켜져도 출력 \(y_i\)에는 \(W_i\cdot W_j\)에 비례하는 간섭이 생기고, 손실은 겹침의 제곱을 따라간다(3.2절). 가장 단순한 기준은 단위 구 위에 고르게 흩은 무작위 벡터다. \(\mathbb{R}^m\)에서 두 무작위 단위 벡터의 겹침 제곱은 \(\mathrm{Beta}(\tfrac12,\tfrac{m-1}{2})\) 분포를 따라 평균이 정확히 \(1/m\)이다. 배치를 다듬어도 넘을 수 없는 선도 있다. 단위 벡터 \(\nu\)개(\(\nu\ge m\))의 최대 겹침에는 Welch 하한이 걸린다(식 5).
\[ \max_{i\neq j}\,\lvert w_i\cdot w_j\rvert\ \ge\ \sqrt{\frac{\nu-m}{m(\nu-1)}}\equiv\kappa\ \approx\ \frac{1}{\sqrt{m}}\qquad(\nu\gg m) \]
이 하한에는 모든 쌍의 겹침이 같은 등각 긴밀 틀(equiangular tight frame, ETF)이 닿고, 실수 공간의 ETF는 벡터가 \(m(m+1)/2\)개 이하일 때만 있다. 무작위로 흩든 가장 정교하게 배치하든 겹침 제곱은 \(1/m\) 규모라는 뜻이다. 학습된 모델에서 노름이 1보다 큰 행들은 ETF에 가까웠다. 겹침 제곱의 분산이 무작위 벡터보다 작았고 평균은 \(1/m\) 위에 모였으며(그림 5c, d), 그런 행은 대략 \(m^2/2\)개였다(부록 D.6). 그래서 빈도가 고르면 손실도 \(1/m\)로 줄고(\(\alpha_m=1\)) 빈도 분포에 거의 좌우되지 않는다(결과 2).
빈도가 크게 치우치면 다르다. 가장 중요한 특징 \(m^2/2\)개가 ETF처럼 놓여 손실에 거의 기여하지 않고 나머지가 손실을 지배한다고 가정하면, 손실은 \(\sum_{i>m^2/2}p_i\propto m^{-2(\alpha-1)}\)이 되어 \(\alpha_m=2(\alpha-1)\)이다(부록 A.1). 저자들도 극단을 가정한 추측이라고 선을 긋는다.
논문 설정을 줄여 돌려 봐도 두 영역의 차이가 보인다.
(가) 손실과 폭
(나) 표현 벡터의 겹침
폭을 16배로 늘려도 약한 중첩의 손실은 거듭제곱 빈도에서 1.5배, 지수 빈도에서 2.3배 줄 뿐이다. 감쇠가 강해 폭 128에서도 담긴 특징이 각각 53개, 138개라 가장 잦은 특징 \(m\)개를 완벽히 담는 경우(회색 점선)보다 손실이 높다. 강한 중첩은 두 분포 모두 직선에 가깝다. 오른쪽에서 학습된 행 벡터의 겹침 제곱 평균은 무작위 단위 벡터의 \(1/m\) 가까이에 놓인다. 블로그의 해석으로는 이것이 기하 논증의 요약이다. 특징이 차원보다 훨씬 많으면 겹침의 크기는 배치 솜씨보다 차원이 정한다.
결과 해설
분포를 바꿔도 강한 중첩의 지수는 1 근처다(그림 1). 특징 10,240개짜리 큰 장난감 모델을 폭 8부터 1,024까지 학습했다(부록 B.1). 빈도는 \(e^{-i/400}\), \(i^{-1.2}\), \(n-i\) 세 가지이고, 약한 중첩은 \(\gamma=0.1\), 강한 중첩은 \(\gamma=-1\)이다. 약한 중첩에서는 거듭제곱 빈도만 큰 폭 쪽에서 로그 축 직선에 가까웠다(그림 9a). 강한 중첩에서는 세 분포 모두 직선이었고 지수는 차례로 \(1.01\pm0.05\), \(1.0\pm0.1\), \(0.89\pm0.05\)였다(부록 D.1).
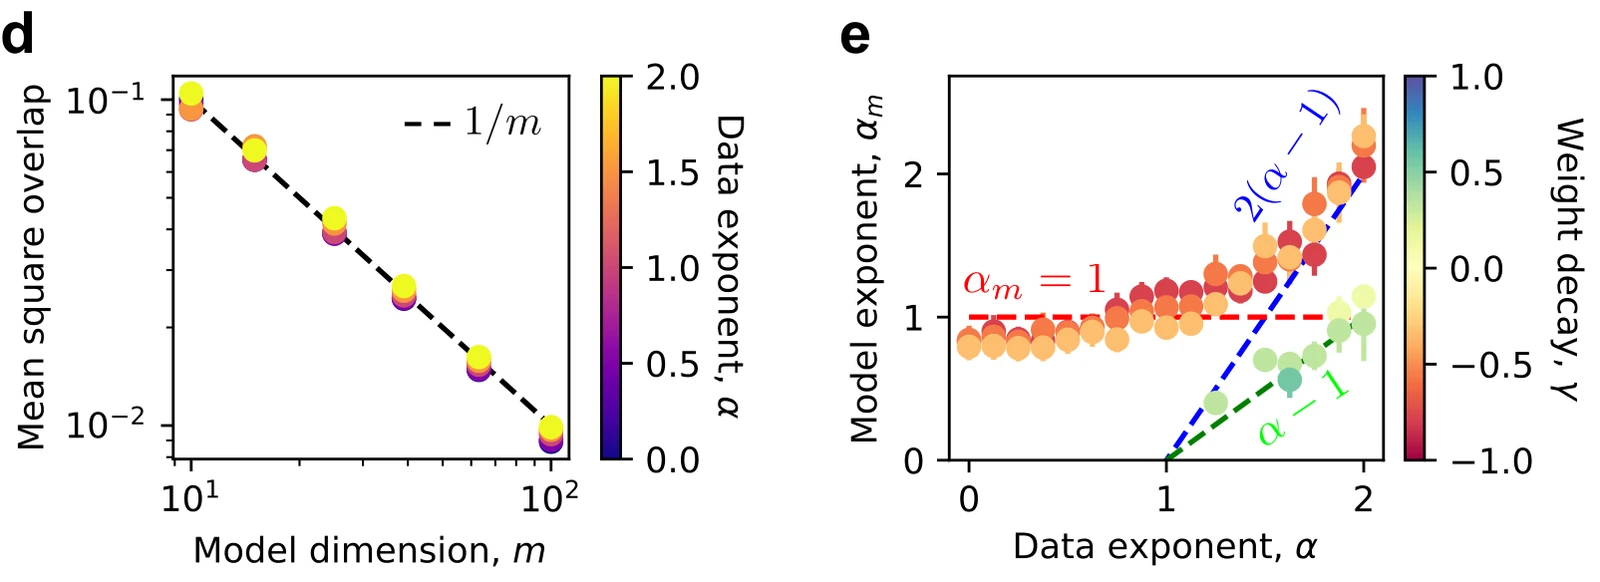
1은 언제 무너지나(그림 5e). 작은 모델에서 데이터 지수 \(\alpha\)를 0부터 2까지, \(\gamma\)를 \(-1\)부터 1까지 훑으면 세 영역이 나온다(부록 B.2, 그림 9b). 약한 중첩에서는 \(\alpha_m\)이 작아 손실이 느리게 줄고, 이상적인 경우 \(\alpha-1\)에 가깝다(그림 4b). 강한 중첩에서 \(\alpha\)가 작으면 \(\alpha_m\approx1\)로 안정적이다. \(\alpha\)가 1.5 근처를 넘으면 강한 중첩이라도 \(\alpha_m\)이 \(2(\alpha-1)\) 쪽으로 커진다(부록 D.6). 언어의 토큰 빈도는 \(\alpha\approx1\)이라 지수 1이 안정적인 영역에 든다.
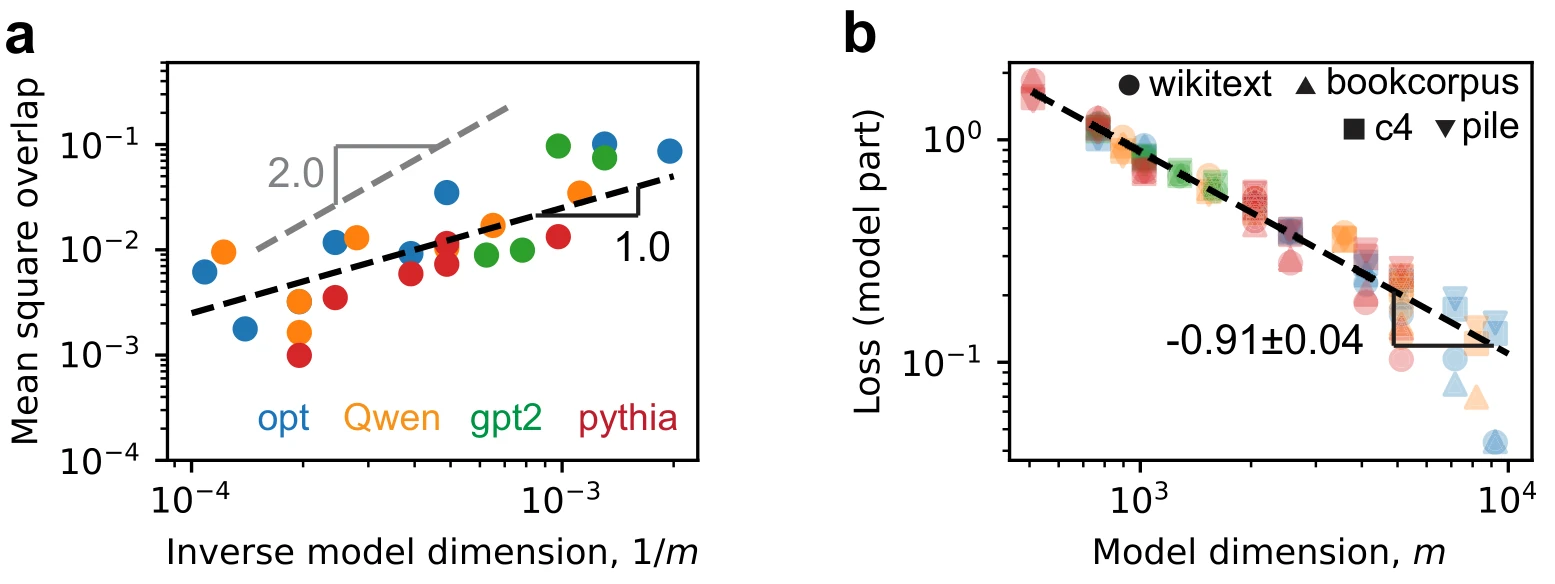
공개 LLM도 강한 중첩에 있다(3.3절, 그림 6). 저자들은 토큰을 원자 특징으로 보고 어휘 크기를 \(n\), 은닉 차원을 \(m\), 출력층 행렬을 \(W\)에 대응시켰다. 대상은 OPT, GPT-2, Qwen2.5, Pythia로 매개변수가 대략 1억 개에서 700억 개까지다. 근거는 셋이다. 출력층의 모든 행이 0이 아닌 노름을 가지니 모든 토큰이 표현되어 있고(부록 D.7), 토큰 빈도는 \(\alpha\approx1\)인 거듭제곱이며(그림 22), 정규화한 행 벡터의 겹침 제곱 평균이 대략 \(1/m\)로 준다(그림 6a). 잡음이 커서 저자들도 6a에는 직선을 맞추지 않았다.
손실 쪽은 네 계열의 평가 손실을 Wikitext-103, Pile-10k, C4, BookCorpus에서 구해(부록 C.2) 다음 식에 맞췄다(식 6).
\[ L=\frac{C_m}{m^{\alpha_m}}+L_{\backslash m} \]
\(C_m\)과 \(\alpha_m\)은 공통이고, 폭과 무관한 상수 \(L_{\backslash m}\)은 계열과 데이터셋의 조합마다 하나씩 16개다. 이렇게 맞춘 값이 \(\alpha_m=0.91\pm0.04\)다(그림 6b). Chinchilla 모델은 매개변수 수가 \(N\propto m^{2.52\pm0.03}\)이고 Besiroglu 외(2024)가 다시 추정한 지수가 \(\alpha_N=0.35\pm0.02\)라서, 폭에 대한 지수로 바꾸면 \(0.88\pm0.06\)이다. 교차 엔트로피여도 폭에 달린 가장 낮은 차수의 항은 겹침의 제곱을 따른다(부록 A.2).
저자들은 자연어에서는 폭에 대한 지수를 1보다 키우기 어렵고, 중첩을 북돋우는 nGPT 같은 구조의 개선은 지수보다 계수를 바꾸는 것일 수 있다고 전망한다(5장).
의심해볼 점
- 겹침이 \(1/m\)로 준다는 것만으로는 강한 중첩을 가르지 못한다. 무작위 단위 벡터의 겹침 제곱 평균이 이미 정확히 \(1/m\)이다. 저자들도 리뷰 토론에서 무작위 초기화도 \(1/m\)을 주니 이 스케일링은 아주 일반적인 결과일 수 있다고 답했다. 블로그의 해석으로는 그림 6a에서 기울기보다 크기가 더 눈에 띈다. 같은 폭의 무작위 벡터보다 겹침 제곱이 대략 다섯 배에서 백 배 크고, 같은 폭에서도 계열에 따라 한 자릿수 넘게 흩어진다. LLM이 강한 중첩에 있다는 판단은 결국 모든 행의 노름이 0이 아니라는 관찰에 크게 기댄다.
- 폭만 바뀐 것이 아니다. 네 계열에서 폭이 커지면 대체로 깊이도 함께 늘었다(5장, 부록 D.7). 저자들도 폭에 달린 손실을 표현 손실 \(f_m(m)\)과 층의 처리 손실 \(f_\ell(\ell)\)의 합으로 쓰고, 최적의 모양에서는 두 항이 균형을 이뤄 합 전체가 \(1/m\)처럼 보일 수 있다고 적었다(5장). 0.91을 표현 손실만의 지수로 읽기 어려운 까닭이다. 저자들이 리뷰 토론에서 내놓은 반증 실험도 깊이를 고정하고 폭만 늘려 보자는 제안이다.
- 장난감 모델을 풀지는 못했다. 저자들이 첫 번째로 적은 한계다(5장). ETF에 가깝다는 판단은 분산과 평균에서 얻은 정황이고, \(\alpha\)가 클 때의 \(2(\alpha-1)\)도 가설이다. 특징끼리 독립이라고 가정했고, 분석은 출력층의 토큰 표현에 한정되며, 데이터 양과 학습 시간에 대한 스케일링은 다루지 않았다.
리뷰어들이 짚은 점
OpenReview에 공개된 심사에서 리뷰어 네 명의 최종 점수는 6, 5, 5, 4(6점 만점)였다. 한 리뷰어는 장난감 모델에 비해 LLM 절이 훨씬 덜 설득력 있다고 봤고, 저자들도 이를 인정했다.
- 상관인가 인과인가. 감쇠를 바꾸니 스케일링이 바뀌었다고 중첩이 원인이라 할 수 있느냐는 질문에, 저자들은 온도에 따라 물이 얼음이 되는 비유를 들었다. 더 정확히 말하면 강한 중첩 영역의 표현 기하가 폭에 대한 스케일링 법칙을 낳는다는 답이다.
- 상관된 특징. 저자들은 상관 행렬의 고유 벡터를 원자 특징으로 보면 된다고 답했다. Pile의 토큰 동시 출현 행렬은 고윳값 지수가 1에서 1.2 사이라 결론이 크게 바뀌지 않으리라 봤다.
- ETF라는 주장의 근거. 작은 폭에서 노름이 1보다 큰 행이 \(m^2/2\)개보다 꽤 많다는 지적(그림 16)에, 저자들은 그편이 손실을 더 줄일 수 있고 손실 지형이 울퉁불퉁하며 Adam이 벡터를 돌리는 데 서툴다는 이유를 들었다. 리뷰어는 처음 주장은 과했지만 보완한 설명은 납득된다며 점수를 올렸다.
계보
- 출발점과 기존 설명. Elhage 외(2022)가 장난감 모델의 출처다. Bahri 외(2024)의 분산 제한 영역에서도 중심극한정리로 \(1/m\)이 나오지만 이는 데이터가 고정된 경우다. 이 논문의 장난감 모델은 걸음마다 새 데이터를 뽑으니, 같은 \(1/m\)이라도 나오는 이유가 다르다. 커널 이론의 \(\alpha_m=\alpha'-1\)은 약한 중첩의 결과와 같은 꼴이다(4장).
- 같은 그룹의 후속 연구. 저자들은 LLM의 손실이 깊이에도 반비례하며 비슷한 층들의 앙상블 평균 때문일 것이라는 연구(Liu 외, arXiv 2602.05970), 소프트맥스와 교차 엔트로피 때문에 학습 시간에 대한 지수가 1/3로 정해진다는 연구(Liu 외, arXiv 2602.03685)를 냈다. Guo, Liu, Gore(arXiv 2609.36455)는 같은 장난감 모델에서 폭을 키우면 일부 특징만 표현되는 국면에서 모든 특징이 표현되는 국면으로 연속 상전이가 일어나고, 그 위에서 손실이 폭에 반비례함을 근사 이론으로 계산했다.
- 상관된 특징의 중첩. Prieto 외(arXiv 2603.09972)는 인터넷 문서의 단어 주머니 표현을 중첩으로 담게 해, 특징이 상관되면 간섭이 잡음이 아니라 도움이 될 수 있음을 보였다.
- 이 블로그의 이전 글. RNN의 시간 중첩 논문은 같은 장난감 모델을 시간 축으로 넓혔다. 얕은 신경망의 스케일링과 스펙트럼 논문은 목표 함수의 거듭제곱 스펙트럼에서 지수를 얻는다. 블로그의 해석으로는 후자가 이 논문이 말하는 “거듭제곱을 넣어 거듭제곱을 얻는” 쪽에 속한다.
열린 질문
- 깊이와 학습량을 묶어 두고 폭만 늘리면, 실제 언어 모델의 손실 가운데 표현에 달린 부분은 정말 폭에 반비례하는가.
- 출력층 바깥, 층을 지나며 문맥에 따라 조합되는 특징에서도 강한 중첩과 \(1/m\) 법칙이 성립하는가. 특징끼리 강하게 상관되면 어떻게 달라지는가.
- 지수가 기하로 고정된다면, 중첩을 북돋우는 구조나 옵티마이저는 스케일링 법칙의 계수를 얼마나 바꿀 수 있는가.
이해 확인
1. 약한 중첩 영역에서 손실이 폭에 대해 거듭제곱 법칙을 따르려면 무엇이 필요한가?
- 활성 밀도 E가 1보다 작아야 한다
- 특징의 빈도 자체가 거듭제곱으로 줄어야 한다
- 가중치 감쇠 γ가 음수여야 한다
- 표현 벡터들이 등각 긴밀 틀(ETF)을 이뤄야 한다
약한 중첩의 손실은 버린 특징의 빈도 합이다(식 4). pi ∝ 1/iα(α > 1)이면 이 합이 m−(α−1)로 줄고, 빈도가 지수적으로 줄면 손실도 지수적으로 준다. 음수 γ와 ETF는 강한 중첩 쪽 이야기이고, 활성 밀도는 지수를 바꾸지 않았다(부록 D.4).
2. 강한 중첩에서 손실이 빈도 분포와 거의 상관없이 1/m로 주는 까닭은?
- 표현되는 특징의 수가 정확히 m개로 고정되기 때문이다
- ReLU와 음의 편향이 모든 간섭을 정확히 0으로 지우기 때문이다
- 차원보다 훨씬 많은 벡터를 담으면 무작위로 흩든 ETF처럼 정돈하든 겹침 제곱이 1/m 규모이고, 손실이 그 겹침 제곱을 따르기 때문이다
- 빈도가 낮은 특징을 모두 버려서 꼬리의 합이 1/m이 되기 때문이다
무작위 단위 벡터의 겹침 제곱 평균은 정확히 1/m이고, 가장 정교한 배치(ETF)도 Welch 하한 때문에 최대 겹침이 약 1/√m이다(식 5). 강한 중첩의 손실은 겹침의 제곱을 따르므로 1/m로 준다(3.2절). 1번과 4번은 약한 중첩의 그림이다.
3. 공개 LLM에서 얻은 αm = 0.91 ± 0.04를 바르게 설명한 것은?
- 깊이를 고정하고 폭만 바꾼 모델들로 잰 표현 손실의 지수다
- 폭과 함께 깊이도 바뀌는 네 계열 모델의 평가 손실을, 공통 지수 하나와 계열과 데이터셋마다 다른 상수로 맞춘 값이다
- 출력층 행 벡터의 겹침 제곱 평균이 폭에 따라 줄어드는 기울기다
- Chinchilla 논문이 보고한 매개변수 지수를 그대로 옮긴 값이다
식 6에서 Cm과 αm은 공통이고 상수는 16개다(부록 D.7). 모델들이 폭만 다른 것이 아니라서 표현 손실만의 지수로 읽기는 어렵다. 겹침의 기울기(그림 6a)는 따로 맞추지 않았고, Chinchilla에서 바꿔 얻은 값은 0.88 ± 0.06으로 따로 있다.
논문 정보
- 제목: Superposition Yields Robust Neural Scaling
- 저자: Yizhou Liu, Ziming Liu, Jeff Gore (MIT)
- 학회: NeurIPS 2025 구두 발표(Oral), 최우수 논문상 차점(Best Paper Runner-up)
- 링크: arXiv 2505.10465, OpenReview, 코드