NeurIPS 2025 Oral
On the Closed-Form of Flow Matching: Generalization Does Not Arise from Target Stochasticity
플로우 매칭이 학습 이미지를 베끼지 않는 까닭은 목표의 잡음이 아니었다
플로우 매칭, 일반화와 암기
한 줄 요약
조건부 플로우 매칭이 맞추는 목표 \(x_1 - x_0\)은 표본 하나로 만든 흔들리는 값이고, 이 흔들림이 모델을 암기에서 떼어 놓는다는 가설이 있었다. 이 논문은 고차원 이미지에서는 그 흔들림이 시간 \(t\)가 작은 짧은 구간에만 남고, 흔들림을 크게 줄인 목표로 학습해도 일반화가 나빠지지 않음을 보였다.
무엇이 달라졌나
학습 이미지 \(n\)개로 이루어진 경험적 분포를 데이터 분포로 놓으면 플로우 매칭 손실을 최소로 만드는 속도장 \(\hat u^\star\)가 닫힌 형태(closed-form)로 나온다(명제 1, 식 6).
\[\hat u^\star(x,t)=\sum_{i=1}^{n}\lambda_i(x,t)\,\frac{x^{(i)}-x}{1-t},\qquad \lambda(x,t)=\mathrm{softmax}_i\!\left(-\frac{\lVert x-t\,x^{(i)}\rVert^2}{2(1-t)^2}\right)\]
이 속도장을 따라가면 학습 이미지만 나온다(2절). 실제 모델이 베끼지 않는 까닭으로 Vastola(ICLR 2025)는 목표의 분산을 꼽았다. \(x_1 - x_0\)은 \(\hat u^\star\)를 평균으로 하는 흔들리는 표본일 뿐이라는 설명이다.
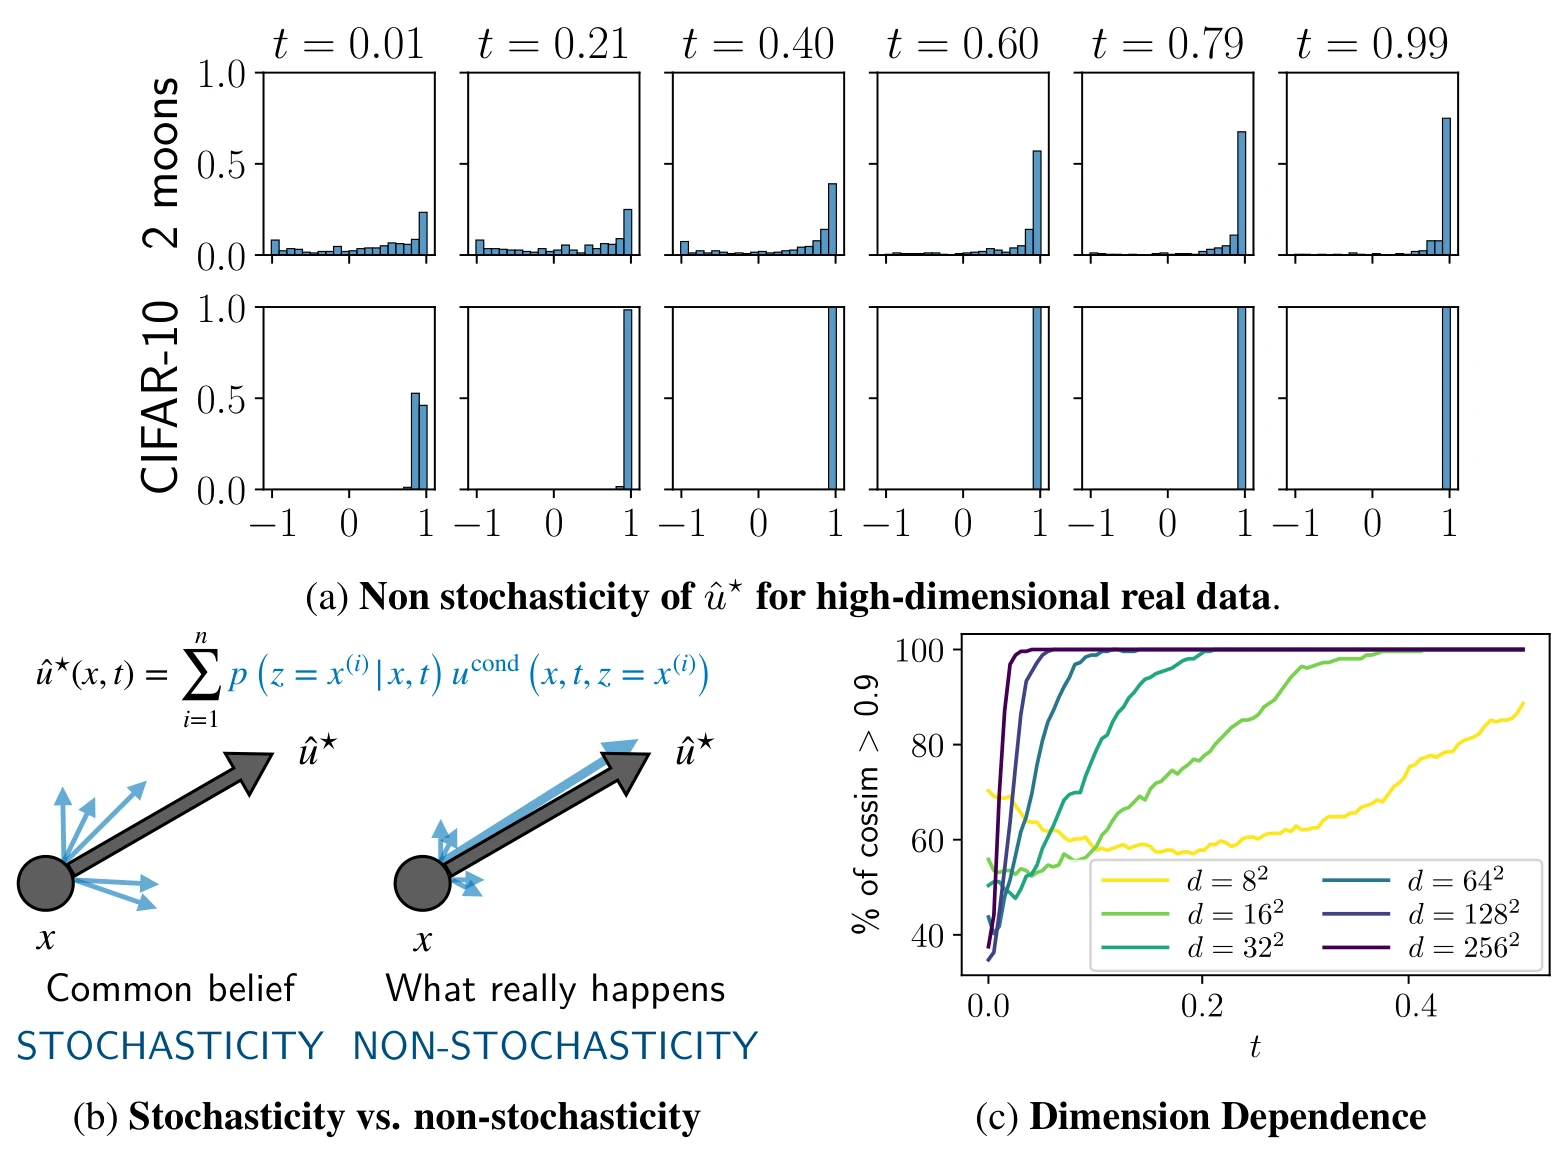
저자들은 두 목표의 코사인 유사도를 쟀다(3.1절, 그림 1). 2차원 두 반달(two moons) 데이터에서는 \(t\)가 커져야 유사도가 1 쪽으로 모이지만, CIFAR-10(\(d\) = 3,072, \(n\) = 5만)에서는 \(t\) = 0.2 전에 거의 모두 1에 붙는다. 소프트맥스 가중치가 \(x_t\)를 만든 학습 이미지 하나에 쏠리기 때문이다. 목표가 같으니 두 손실도 사실상 같다. Imagenette 해상도를 8×8에서 256×256으로 올리면 이 쏠림이 더 일찍 일어난다(그림 1c).
어떻게 보였나
흔들림이 짧은 구간에만 있어도 일반화가 바로 그 구간에서 정해진다면 가설은 살아남는다. 실제로 생성할 때 처음 \(\tau\)까지만 \(\hat u^\star\)를 따르고 그 뒤는 학습한 모델에 맡기면, \(\tau\)가 0.2 이하일 때는 새 이미지가 나오지만 0.3부터는 일반화하지 못한다(3.3절, 그림 3).
그래서 목표 자체를 바꿨다. 경험적 플로우 매칭(EFM)은 학습 이미지 \(M\)개로 \(\hat u^\star\)를 어림해 목표로 쓴다(식 7, 8). \(x_t\)를 만든 \(x_1\)을 \(M\)개 안에 꼭 넣어야 추정이 치우치지 않고, 분산은 \(x_1 - x_0\)보다 작아진다(명제 2). \(M\) = 1이면 보통의 조건부 플로우 매칭(CFM)이다.
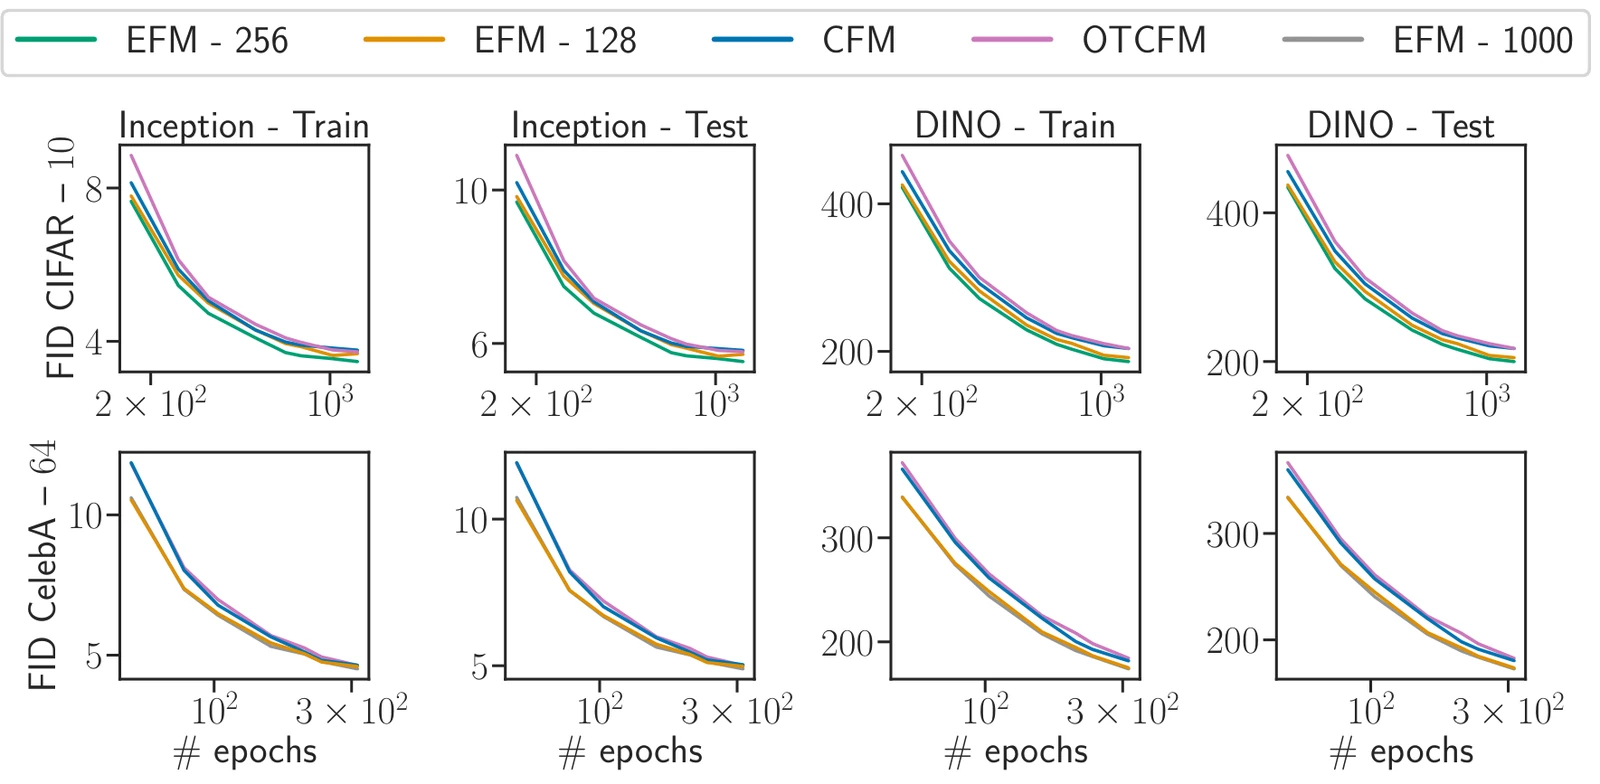
CIFAR-10과 CelebA 64×64에서 \(M\)을 128, 256, 1000으로 키우자 학습 FID와 시험 FID가 CFM보다 나빠지지 않고 작지만 꾸준히 좋아졌다(4.2절, 그림 4). Fashion-MNIST에서도 200 에포크 FID가 CFM 19.67, EFM(\(M\) = 512) 16.85였다(부록 C, 표 2).
그러면 일반화는 어디서 오나. CIFAR-10 부분집합으로 3,400만 매개변수 U-Net을 학습하면 이미지가 10장일 때는 \(\hat u^\star\)를 거의 그대로 배워 베낀다. 이미지가 늘수록 \(t \approx 0.15\) 근처와 \(t = 1\) 근처에서 \(\hat u^\star\)를 놓치고, 3,000장부터는 생성 이미지와 가장 가까운 학습 이미지의 거리가 크게 벌어진다(3.2절, 그림 2). 저자들은 신경망이 이른 시점의 최적 속도장을 끝내 맞추지 못하는 데서 일반화가 나온다고 본다.
눈여겨볼 점
EFM도 결정적인 목표는 아니다. \(M\)개로 낸 어림값이라 분산이 0은 아니라는 리뷰어 지적에, 저자들은 \(M\)을 1000 넘게 올려도 결과가 같았다고 답했다(4.2절). 엄밀히 보인 것은 흔들림을 크게 줄여도 일반화가 줄지 않는다는 데까지다. FID 차이는 작고 오차 막대도 없다(논문 체크리스트 7번). FID는 암기를 잘 잡지 못한다. 1,000장으로 학습한 모델은 시험 FID가 낮은데도 학습 이미지를 베꼈다(3.2절). 실험은 이미지와 U-Net에 한정된다.
블로그의 해석으로는 후보 하나를 지운 논문이다. 신경망이 \(\hat u^\star\)를 어떤 모양으로 놓치는지, 구조의 귀납 편향과 최적화가 어떻게 얽히는지는 한계로 남았다(6절). 남은 후보는 합성곱의 국소성 같은 구조의 편향과, 학습 시간 척도가 암기를 늦춘다는 논문이 다룬 학습 동역학이다.
열린 질문
- 신경망이 이른 시점에 \(\hat u^\star\)를 놓치는 오차를 데이터 수와 차원을 바꿔 가며 재고, 합성곱망과 트랜스포머에서 그 오차가 같은 방향을 향하는지 보면 일반화를 만드는 실패가 어떤 모양인지 가려낼 수 있을까.
이해 확인
고차원 이미지에서 \(x_1 - x_0\)과 닫힌 형태 목표 \(\hat u^\star\)가 이른 시점부터 거의 같아지는 까닭은?
- 학습하면서 신경망이 목표의 잡음을 평균 내어 지우기 때문이다
- \(t\)가 1에 가까워져야 두 목표가 같은 방향을 가리키기 때문이다
- 소프트맥스 가중치가 \(x_t\)를 만든 학습 이미지 하나에 쏠리기 때문이다
- EFM이 학습 이미지 \(M\)개로 목표를 평균 내기 때문이다
식 6의 \(\hat u^\star\)는 학습 이미지 방향들의 가중 평균인데, 고차원에서는 이른 시점부터 가중치 하나만 남는다(3.1절, 그림 1). 그림 1은 학습 없이 목표만 계산한 결과라 1번은 틀렸고, 2번은 2차원 두 반달 데이터의 모습에 가깝다. 4번의 EFM은 이 관찰 뒤에 나온 학습법이다.
논문 정보
- 제목: On the Closed-Form of Flow Matching: Generalization Does Not Arise from Target Stochasticity
- 저자: Quentin Bertrand (Université Jean Monnet Saint-Étienne, Inria, Laboratoire Hubert Curien; Mila), Anne Gagneux (ENS de Lyon, Inria, LIP), Mathurin Massias (Inria, ENS de Lyon, LIP), Rémi Emonet (Université Jean Monnet Saint-Étienne, Inria, Laboratoire Hubert Curien; Institut Universitaire de France)
- 학회: NeurIPS 2025 구두 발표(Oral)
- 링크: arXiv, OpenReview, 코드