NeurIPS 2025 Oral
평균 속도를 배운 흐름 모델은 한 걸음에 데이터에 닿는다
구간의 평균 속도와 순간 속도를 잇는 항등식 하나로, 사전 학습과 증류 없이 ImageNet 256에서 함수 평가 한 번으로 FID 3.43을 낸 NeurIPS 2025 구두 발표 논문
플로우 매칭, 한 걸음 생성, 일관성 모델
3줄 요약
- 흐름 매칭(flow matching)은 순간 속도를 배워 생성할 때 수십에서 수백 걸음에 걸쳐 적분한다. MeanFlow는 두 시각 \(r\)과 \(t\) 사이의 평균 속도 \(u(z_t, r, t)\)를 배우게 해서, 잡음에서 데이터까지 \(u(\epsilon, 0, 1)\) 한 번으로 건너간다.
- 평균 속도의 정의를 \(t\)로 미분하면 \(u = v - (t-r)\tfrac{d}{dt}u\)라는 MeanFlow 항등식이 나온다(식 6). 시간 미분은 야코비안 벡터 곱 한 번으로 계산하고 목표에 기울기 차단을 걸어, 흐름 매칭과 거의 같은 회귀 문제로 만든다(식 8~11).
- 사전 학습, 증류, 커리큘럼 없이 ImageNet 256×256에서 함수 평가 한 번(1-NFE)으로 FID 3.43, 두 번으로 2.20을 냈다(표 2). 대신 목표에 신경망 자신의 미분이 들어가고, 안내 세기를 학습 때 정해야 한다.
선정 이유
NeurIPS 2025 구두 발표(oral) 논문이다. 공개된 심사에서 리뷰어 다섯 명의 최종 점수는 6, 5, 5, 5, 3이었고(6점 만점), 결정문은 원리가 분명하고 결과가 강하다며 구두 발표를 권했다.
블로그의 연구 여지 지도에서 ’플로우 매칭과 정규화 플로우’는 LLM 중심 주제를 뺀 109개 주제 가운데 3위다.
- 전후로 아는 것이 달라졌나. 달라졌다. 처음부터 학습한 1-NFE 모델의 최고 기록은 Shortcut의 FID 10.60이었는데(표 2), MeanFlow가 3.43으로 끌어내렸다. 신경망 출력에 일관성 제약을 거는 대신, 신경망과 상관없이 존재하는 정답 장(field)이 만족하는 항등식으로 학습할 수 있음을 보였다.
- 새 질문을 여는가. 연다. 2026년 10월 14일 기준 arXiv 초록에 MeanFlow가 들어간 논문이 125편이고, 개선판과 학습 목표의 분해, 기울기 차단의 수렴 분석이 잇달아 나왔다.
- 일반화될 근거가 있나. 논문 안에서는 ImageNet 잠재 공간과 CIFAR-10뿐이지만, 항등식은 데이터에 매이지 않고 후속 연구가 음성과 로봇 정책으로 넓혔다.
- 증거가 주장만큼 강한가. 절반쯤이다. 절제 실험(ablation)은 꼼꼼하지만 작은 B/4 모델에서만 했고 지표는 FID 하나다. 실제 학습 목표가 항등식의 해로 수렴한다는 보장은 논문에 없다.
왜 중요한가
흐름 매칭은 데이터 \(x\)와 잡음 \(\epsilon\)을 \(z_t = (1-t)x + t\epsilon\)으로 잇고, 경로의 속도 \(v_t = \epsilon - x\)를 회귀로 배운다(3장). 같은 \(z_t\)가 여러 \((x, \epsilon)\) 쌍에서 나오므로 신경망이 실제로 맞추는 값은 그 평균인 주변 속도(marginal velocity) \(v(z_t, t) = \mathbb{E}[v_t \mid z_t]\)다(식 1). 생성할 때는 \(z_1 = \epsilon\)에서 출발해 \(dz_t/dt = v(z_t, t)\)(식 2)를 \(t = 0\)까지 거꾸로 푼다.
문제는 궤적이 휜다는 데 있다. 조건부 경로가 모두 직선이어도 이를 평균한 주변 속도장의 궤적은 휘고, 이는 근사 오차가 아니라 정답 장 자체의 성질이다(3장). 휜 궤적을 큰 보폭으로 따라가면 오차가 커진다.
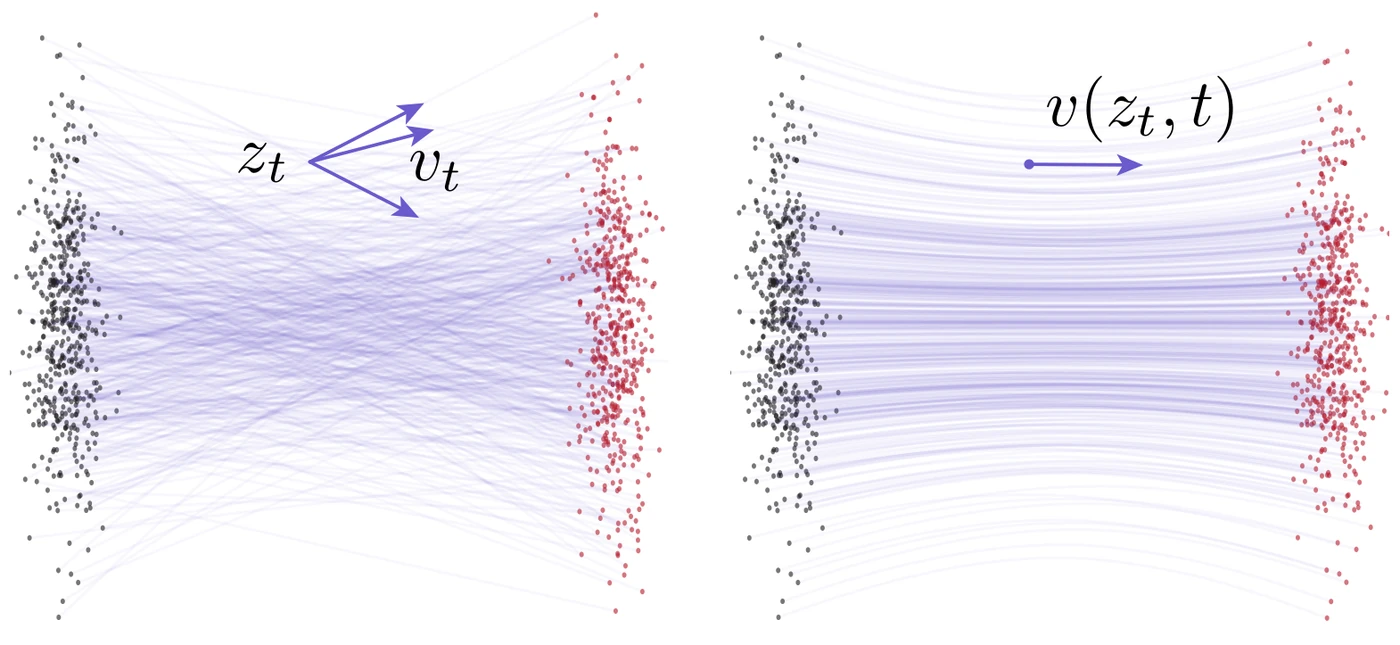
걸음 수를 줄이는 길은 둘이었다. 미리 학습한 여러 걸음 모델을 증류하는 길과, 일관성 모델(consistency model)처럼 처음부터 학습하는 길이다. 저자들은 일관성 모델이 같은 궤적 위 점들의 출력을 맞추라는 제약을 신경망에 걸 뿐 학습을 이끌 정답 장은 모른다고 지적한다. 그래서 학습이 불안정하고 시간 간격을 점점 좁히는 커리큘럼이 필요했다(1장).
핵심 아이디어
직관: 속도계 대신 평균 속력
서울에서 부산까지 400km를 4시간에 갔다면 평균 속력은 시속 100km다. 도중에 속도계 바늘이 어떻게 움직였든 평균 속력과 걸린 시간만 알면 도착 지점이 나온다. 흐름 매칭은 속도계 바늘을 배우니 바늘을 계속 읽으며 적분해야 한다. MeanFlow는 처음부터 구간의 평균 속도를 배운다(4.1절, 식 3).
\[ u(z_t, r, t) \triangleq \frac{1}{t-r}\int_r^t v(z_\tau, \tau)\,d\tau \]
평균 속도는 변위를 구간 길이로 나눈 값이라, 궤적의 접선이 아니라 두 끝점을 잇는 현과 방향이 같다. 정의에서 두 성질이 나온다. \(r \to t\)이면 \(u \to v\)이고, 구간을 한 번에 가든 중간 시각 \(s\)에서 끊어 두 번에 가든 결과가 같다. \((t-r)u(z_t,r,t) = (s-r)u(z_s,r,s) + (t-s)u(z_t,s,t)\)는 적분의 가법성일 뿐이어서, 일관성 모델이 따로 걸던 제약을 정답 장이 저절로 만족한다(4.1절).
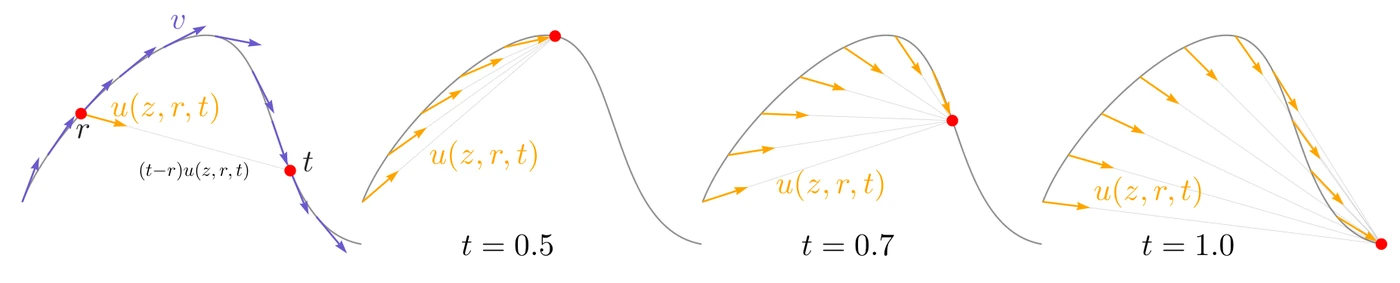
\(u\)를 신경망 \(u_\theta\)로 근사하면 생성은 \(z_0 = \epsilon - u_\theta(\epsilon, 0, 1)\) 한 번이다(식 12). 걸림돌은 학습이다. 식 3을 정답으로 쓰려면 표본마다 적분을 해야 한다.
수식: MeanFlow 항등식
저자들은 정의식을 조금 고쳐 적분 없는 학습 목표를 만들었다. 먼저 식 3의 양변에 구간 길이를 곱한다(식 4).
\[ (t-r)\,u(z_t, r, t) = \int_r^t v(z_\tau, \tau)\,d\tau \]
\(r\)을 고정하고 양변을 \(t\)로 미분한다. 왼쪽에는 곱의 미분법, 오른쪽에는 미적분학의 기본 정리를 쓰면 \(u + (t-r)\tfrac{d}{dt}u = v\)가 되고(식 5), 이를 정리한 것이 MeanFlow 항등식이다(식 6).
\[ \underbrace{u(z_t, r, t)}_{\text{평균 속도}} = \underbrace{v(z_t, t)}_{\text{순간 속도}} - (t-r)\,\frac{d}{dt}u(z_t, r, t) \]
여기서 \(\tfrac{d}{dt}\)는 \(z_t\)도 \(t\)를 따라 움직이는 전미분이다. \(dz_t/dt = v\), \(dr/dt = 0\), \(dt/dt = 1\)을 넣으면(식 7) 다음을 얻는다(식 8).
\[ \frac{d}{dt}u(z_t, r, t) = v(z_t, t)\,\partial_z u + \partial_t u \]
이는 \(u\)의 야코비안 \([\partial_z u, \partial_r u, \partial_t u]\)에 접벡터 \((v, 0, 1)\)을 곱한 야코비안 벡터 곱(Jacobian-vector product, JVP)이라서, jax.jvp나 torch.func.jvp를 한 번 부르면 계산된다.
거꾸로 항등식만 지켜도 정의가 성립한다. 미분이 같으면 적분은 상수만큼 다를 수 있지만, \(t = r\)에서 양쪽이 모두 0이라 그 상수가 사라진다(부록 B.3). 변위를 직접 모델링했다면 \(t = r\)에서 0이라는 경계 조건을 따로 걸어야 했을 텐데, 평균 속도로 쓰면 이 조건이 저절로 따라온다.
방법: 흐름 매칭 목표에 항 하나를 더한 회귀
항등식의 오른쪽을 회귀 목표로 쓴다(식 9, 11).
\[ \mathcal{L}(\theta) = \mathbb{E}\,\big\|u_\theta(z_t, r, t) - \mathrm{sg}(u_\mathrm{tgt})\big\|_2^2,\qquad u_\mathrm{tgt} = v_t - (t-r)\big(v_t\,\partial_z u_\theta + \partial_t u_\theta\big) \]
바꿔치기가 두 번 있다. 정답 장 \(u\)의 미분 자리에 신경망 자신의 미분 \(\partial u_\theta\)를, 주변 속도 자리에 흐름 매칭처럼 조건부 속도 \(v_t = \epsilon - x\)를 넣었다. \(\mathrm{sg}\)는 기울기 차단(stop-gradient)으로, JVP를 거쳐 다시 역전파하는 이중 역전파를 막는다(4.1절). 추가 비용은 JVP 한 번이라 B/4의 반복당 시간이 0.045초에서 0.052초로 16% 늘었다(부록 B.4).
\(r = t\)이면 둘째 항이 사라져 표준 흐름 매칭과 똑같다. MeanFlow는 흐름 매칭의 목표에 항 하나를 더했을 뿐이고, 알고리즘 1의 학습 코드도 열 줄 남짓이다. 학습 시각은 로짓 정규분포에서 두 값을 뽑아 큰 쪽을 \(t\)로 두고, 정해진 비율만큼은 \(r = t\)로 맞춘다(4.3절). 기본 설정에서 \(r \ne t\)인 표본은 25%뿐이다(표 4).
(가) 학습 한 걸음 (알고리즘 1)
(나) 시간 두 개가 만드는 평면
정답 장을 정확히 계산해 보면 평균 속도가 왜 한 걸음에 맞는지 분명해진다. 아래는 세 무리 가우스 혼합에서 주변 속도를 닫힌 꼴로 구해 ODE를 푼 결과다.
(가) 휘는 궤적과 두 가지 한 걸음
(나) 잡음 1,000개를 옮긴 결과
\(t = 1\)에서 순간 속도는 \(v(z, 1) = z - \mathbb{E}[x]\)다. 그래서 오일러 한 걸음 \(z_0 = z_1 - v(z_1, 1)\)은 출발점과 상관없이 데이터 평균 한 점에 떨어진다. 평균 속도로 한 걸음 가면 정의상 궤적의 끝점에 그대로 닿는다. 표 1a에서 흐름 매칭만으로 학습한 모델이 1-NFE에서 무너지는 것도 같은 이유로 읽힌다(블로그의 해석).
안내도 정답 장에 넣는다
분류기 없는 안내(classifier-free guidance, CFG)는 보통 걸음마다 조건부와 무조건부 예측을 섞느라 평가를 두 번 한다. MeanFlow는 안내된 속도장 \(v^\mathrm{cfg} = \omega\,v(z_t,t\mid c) + (1-\omega)\,v(z_t,t)\)(식 13)의 평균 속도 \(u^\mathrm{cfg}\)를 배운다(식 15). 무조건부 속도가 \(u^\mathrm{cfg}(z_t, t, t)\)와 같으므로(식 16), 목표의 \(v_t\) 자리에 \(\tilde v_t = \omega v_t + (1-\omega)\,u^\mathrm{cfg}_\theta(z_t, t, t)\)를 넣으면 된다(식 19). 샘플링은 여전히 평가 한 번이다(4.2절).
결과 해설
실험은 ImageNet 256×256의 VAE 잠재 공간(32×32×4)에서 DiT 구조의 ViT를 처음부터 학습한다(5장). 절제 실험은 B/4 모델을 80 에폭 학습해 비교했다(표 1). 같은 크기의 DiT-B/4와 SiT-B/4는 250걸음으로 FID 68.4와 58.9다.
\(r \ne t\) 비율(표 1a). 0%, 곧 흐름 매칭 그대로면 1-NFE FID가 328.91이다. 25%에서 61.06으로 가장 좋았고 50%에서 63.14, 100%에서 67.32였다. 한 걸음짜리 B/4가 250걸음 SiT-B/4와 비슷한 수준이다. 저자들은 순간 속도를 배우는 일과 그것을 \(r \ne t\)로 퍼뜨리는 일 사이의 균형으로 해석한다(5.1절).
JVP 접벡터(표 1b). 올바른 \((v, 0, 1)\)은 61.06이고, 일부러 틀린 \((v, 0, 0)\)은 268.06, \((v, 1, 1)\)은 137.96이었다. 1차원뿐인 시간 성분이 틀려도 학습이 무너진다.
시각 분포와 손실(표 1d, 1e). 시각 분포는 로짓 정규분포(61.06)가 균등분포(65.90)보다 나았고, 적응형 가중치 없이 제곱 오차만 쓰면 79.75였다.
안내(표 1f). 안내 없이 61.06이던 FID가 \(\omega = 3\)에서 15.53까지 내려갔다. 표 2의 주요 결과는 모두 안내를 쓴 값이다.
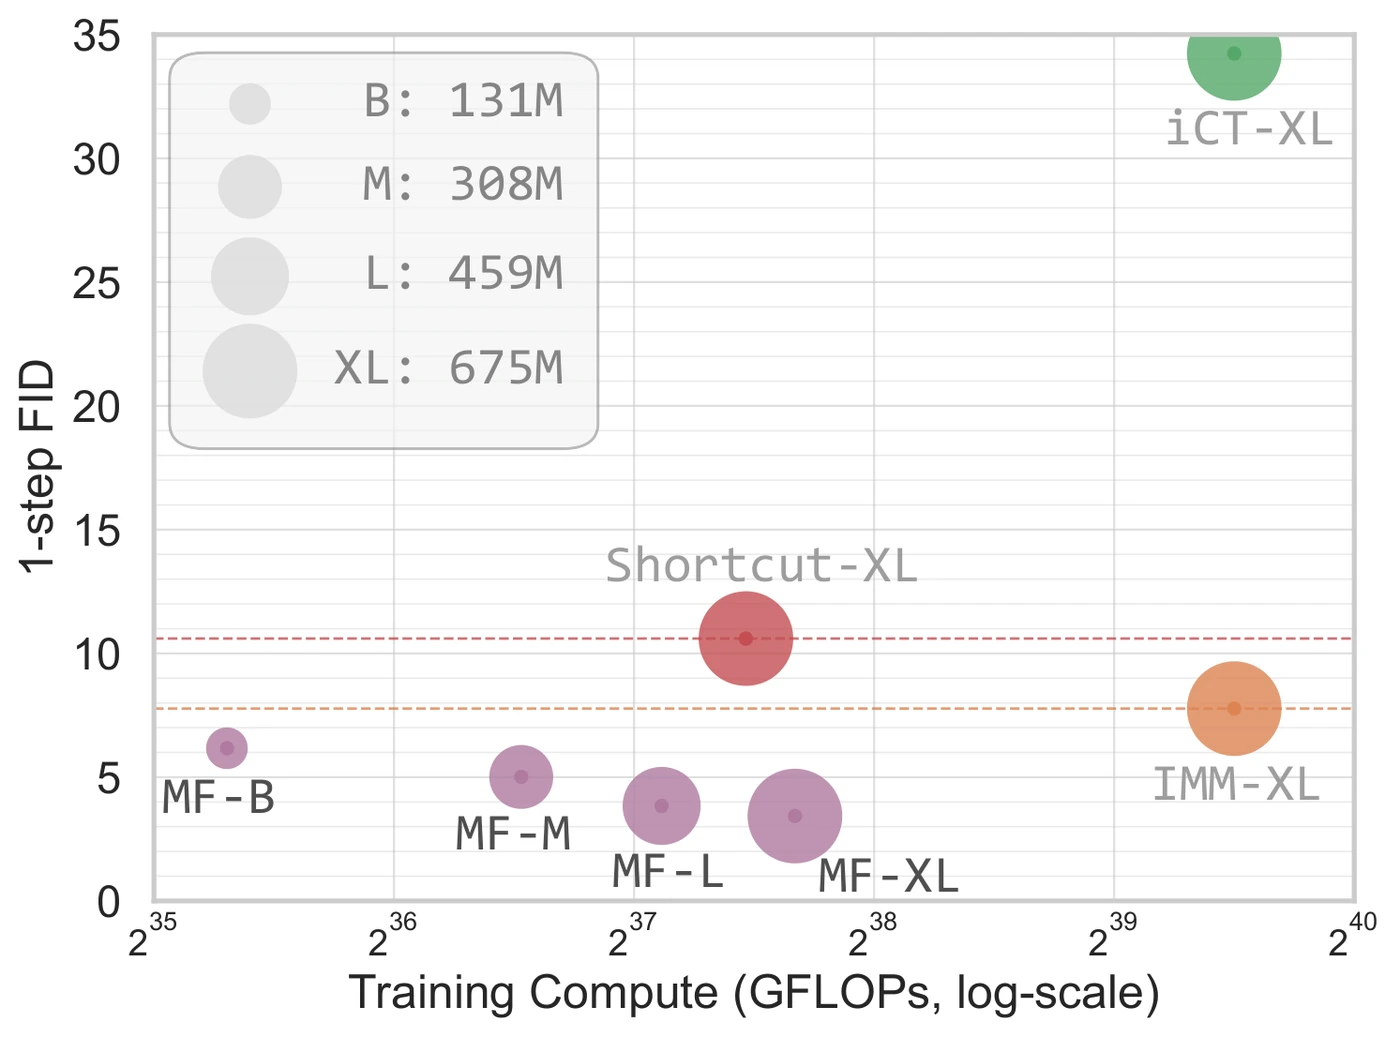
ImageNet 256 비교(표 2). 240 에폭 학습한 MeanFlow-XL/2가 1-NFE FID 3.43을 냈다. iCT-XL/2(34.24), Shortcut-XL/2(10.60), 안내 때문에 평가를 두 번 쓰는 IMM-XL/2(7.77)보다 낮다. B/2, M/2, L/2는 6.17, 5.01, 3.84로 모델이 클수록 좋아졌다. 두 걸음에서는 XL/2가 2.93, 1,000 에폭을 학습한 XL/2+가 2.20이다. 같은 XL/2 뼈대로 250걸음에 안내까지 쓰는 DiT(2.27), SiT(2.06)와 비슷하다(표 2).
CIFAR-10(표 3). 무조건부 1-NFE FID 2.92로 iCT(2.83), sCT(2.97), IMM(3.20)과 비슷하고, 가장 좋은 값은 아니다.
의심해볼 점
- 학습 목표가 자기 자신을 참조한다. \(u_\mathrm{tgt}\)에 신경망의 미분 \(\partial u_\theta\)가 들어 있어 목표가 학습을 따라 움직이고, 기울기 차단을 건 갱신은 어떤 고정된 손실의 기울기도 아니다. 논문은 손실이 0이면 정의를 만족한다는 데까지만 보였고(4.1절), 학습이 거기 닿는지, 용량이 모자라면 어디서 멈추는지는 다루지 않는다. 후속편 iMF도 이 의존성을 첫 문제로 꼽았다.
- 기울기 차단은 계산 절약 이상의 일을 한다(블로그의 해석). 목표는 \(v_t\)에 대해 일차식이므로 \(u_\mathrm{tgt}(v_t) = u_\mathrm{tgt}(v) + (I - (t-r)\partial_z u_\theta)(v_t - v)\)로 쓸 수 있다. 기울기 차단이 없으면 제곱 손실에 \(\mathbb{E}\|(I - (t-r)\partial_z u_\theta)(v_t - v)\|^2\)이 더해지고, 이 항이 \(\theta\)에 의존하니 신경망은 야코비안을 바꿔 조건부 속도의 잡음을 줄이는 쪽으로 끌려간다. 기울기 차단을 걸면 이 항이 기울기에서 빠지고, \(z_t\)를 고정한 기댓값에서 조건부 속도와 주변 속도의 기울기가 같아진다. 저자들이 심사 토론에서 낸 증명이 이것이고, 처음에 반대한 리뷰어도 기울기 차단이 이 등가성의 핵심이라고 정리했다.
- 안내 세기는 학습할 때 정해진다. 1-NFE로 안내를 쓰려면 \(\omega\)를 학습에 넣어야 하고 샘플링 때는 바꿀 수 없다. 모델 크기마다 유효 안내 세기(2.0~2.5)와 안내를 거는 \(t\) 구간(XL/2는 0~0.75)을 따로 골랐다(표 4). 목표 \(\tilde v_t\)에 신경망 자신의 무조건부 출력이 들어가니 여기도 자기 참조다. 후속 iMF는 안내 세기를 조건 변수로 넣어 이 제약을 풀었다.
- 한 걸음은 무리 사이의 경계를 날카롭게 배워야 한다(블로그의 해석). 앞의 가우스 혼합에서 잡음 평면을 끝점이 닿는 무리별로 나누면 경계 양쪽의 잡음은 다른 무리로 간다. 구간이 길수록 평균 속도는 이 경계에서 계단처럼 꺾인다(아래 그림). 매끄러운 신경망이 계단을 뭉개면 표본이 무리 사이에 떨어질 것이다. 직접 증거는 아니지만, 저자들이 심사 중 낸 추가 지표에서 1-NFE의 정밀도(precision)와 재현율(recall)은 0.78과 0.55로, 250걸음 SiT-XL/2의 0.83과 0.59보다 조금씩 낮았다.
(가) 잡음이 어느 무리로 가는가
(나) 단면 위의 평균 속도
- 계산 비용. 반복당 학습 시간은 흐름 매칭보다 16% 길고(부록 B.4) 최대 메모리는 같다고 저자들은 답했다. 다만 JAX와 TPU에서 잰 값이다. JVP는 순방향 자동 미분이라 어텐션 커널이 이를 지원해야 하고, JVP를 없앤 후속 SplitMeanFlow는 하드웨어 호환성을 장점으로 내세웠다. 두 걸음 최고 기록에는 1,000 에폭이 들었다(표 4).
리뷰어들이 짚은 점
- 새로움의 범위. 3점을 준 리뷰어는 흐름 사상(flow map)을 \(z_t + (r-t)u_\theta\)로 두고 시간 미분을 0으로 맞추는 것은 일관성 궤적 모델(CTM)이나 흐름 사상 매칭(Boffi 외)의 명제 3.5와 같다고 봤다. 저자들은 일관성 모델은 \(r = 0\) 한 줄만 배우고, CTM과 달리 풀이기 시뮬레이션이나 적대적 손실이 없으며, 흐름 사상 매칭과 달리 시간 미분을 거쳐 역전파하지 않는다고 답했다. 리뷰어는 MeanFlow를 더 잘 조율한 연속 시간 CTM으로 보는 의견을 유지했고, 결정문은 CTM과의 관계를 최종본에서 더 다루라고 권했다.
- 조건부 속도로 바꿔도 되는가. 세 리뷰어가 주변 속도를 조건부 속도로 바꾼 근거를 물었고, 저자들은 앞에서 본 증명을 토론에서 냈다. 증명을 본 세 리뷰어 모두 이 점은 받아들였다.
- 지표와 한계. 저자들은 추가 지표(1-NFE에서 IS 247.50, sFID 6.43)와 네 걸음 FID 1.89를 보고했고, 한계 절이 없다는 지적에는 여러 걸음 모델과의 격차, 이미지에 한정된 실험, VAE 잠재 공간 의존을 적겠다고 답했다.
계보
- 흐름 매칭. Lipman 외(2022), Liu 외(2022)의 정류 흐름(rectified flow), Albergo와 Vanden-Eijnden(2023)의 확률적 보간이 바탕이다. 이 블로그의 FALCON 논문 해설은 몇 걸음짜리 흐름 모델의 가능도를, 운동 에너지 논문 해설은 흐름 매칭 궤적의 에너지를 다뤘다.
- 한 걸음 생성. 일관성 모델(Song 외 2023)과 iCT, ECT, sCM은 \(r = 0\)에 고정한 사상을 배운다. Kim 외(2023)의 CTM과 Boffi 외(2024)의 흐름 사상 매칭은 두 시각 사이의 변위를, Shortcut(Frans 외 2024)과 IMM(Zhou 외 2025)은 두 시각 사이의 자기 일관성을 다뤘다. MeanFlow는 같은 대상을 평균 속도로 쓰고 항등식 하나로 학습한다.
- 후속 연구. 같은 연구진의 iMF(arXiv 2512.02012)는 손실을 순간 속도에 대한 회귀로 고치고 안내 세기를 조건으로 넣어 1-NFE FID 1.72를, 픽셀 공간판 pMF(arXiv 2601.22158)는 2.22를 냈다. AlphaFlow(arXiv 2510.20771)는 목표가 궤적 흐름 매칭과 궤적 일관성으로 나뉘고 두 항의 기울기가 부딪힌다고 보였고, SplitMeanFlow(arXiv 2507.16884)는 구간을 쪼개는 대수적 항등식으로 JVP를 없앴다. Boffi 외(arXiv 2505.18825)는 공간 미분과 짧은 구간의 부트스트랩을 모두 피하는 라그랑주형 학습이 더 안정적이라고 보고했다.
- 기울기 차단의 이론. 기울기 차단 목표의 정지점이 참 흐름 사상 하나뿐이고 MeanFlow 목표가 수렴한다는 결과(arXiv 2609.16222)와, 원래 손실이 조건부 속도를 쓰는 방식 때문에 기울기 분산이 커진다는 분석(arXiv 2605.09235)이 나왔다. 후자에서도 FID는 원래 손실이 가장 좋았다.
열린 질문
- 한 걸음 사상은 무리 사이의 경계를 어떻게 배우는가. 평균 속도장은 구간이 길수록 경계에서 가팔라진다. 이 날카로움이 표본 품질, 시각 분포, \(r = t\) 비율의 최적값과 어떻게 이어지는가.
- 용량이 유한할 때 기울기 차단 목표는 어디로 가는가. 함수 공간에서는 정지점이 참값 하나뿐이지만, 근사 오차가 짧은 구간에서 긴 구간으로 어떻게 번지고 쌓이는가.
- 학습에 넣은 안내는 여러 걸음 안내와 같은 분포를 주는가. 안내된 장의 평균 속도를 배운 한 걸음 모델과, 안내를 걸고 ODE를 끝까지 푼 모델의 분포는 얼마나 다른가.
이해 확인
1. MeanFlow 항등식 u = v − (t − r) du/dt(식 6)는 어떻게 얻었나?
- 평균 속도를 순간 속도의 테일러 전개로 근사했다
- (t − r)u = ∫v dτ의 양변을 r을 고정한 채 t로 미분했다
- 구간 [r, t]를 오일러 한 걸음으로 근사하고 오차 항을 덧붙였다
- 일관성 모델 손실의 r = 0을 다른 값으로 바꿨다
식 4의 왼쪽에 곱의 미분법, 오른쪽에 미적분학의 기본 정리를 쓰면 식 5가 되고, 이를 정리한 것이 식 6이다. 근사가 아닌 정확한 관계라 1번과 3번은 틀렸고, 거꾸로 이 식만 지켜도 정의가 성립한다(부록 B.3).
2. 학습할 때 r = t인 표본만 쓰면(표 1a의 0%) 어떻게 되나?
- 평균 속도를 그대로 배우지만 수렴이 느려진다
- 목표의 JVP 항이 커져 학습이 발산한다
- 표준 흐름 매칭과 같아지고, 1-NFE FID가 328.91로 무너진다
- r = 0에 고정한 일관성 모델과 같아진다
t − r = 0이면 목표의 둘째 항이 사라져 흐름 매칭이 된다(4.1절). 순간 속도로 한 걸음 가면 데이터 평균 쪽으로 몰린다. 기본 설정은 r ≠ t를 25%만 둔다(표 4).
3. 주변 속도 대신 조건부 속도 vt = ε − x를 목표에 넣어도 되는 이유로 저자들이 심사 토론에서 낸 것은?
- 목표가 vt의 일차식이고 기울기 차단이 걸려 있어 두 손실의 기울기가 기댓값에서 같아진다
- 직선 경로에서는 조건부 속도와 주변 속도가 늘 같다
- 적응형 가중치가 조건부 속도의 분산을 없앤다
- JVP가 조건부 속도의 잡음을 상쇄한다
목표는 조건부 속도의 일차식이고, 기울기 차단 때문에 상수로 취급된다. 그래서 zt를 고정한 기댓값을 목표 안으로 넣으면 조건부 속도가 주변 속도로 바뀐다. 두 속도는 직선 경로에서도 다르다(그림 2).
논문 정보
- 제목: Mean Flows for One-step Generative Modeling
- 저자: Zhengyang Geng (CMU), Mingyang Deng, Xingjian Bai (MIT), J. Zico Kolter (CMU), Kaiming He (MIT)
- 학회: NeurIPS 2025 구두 발표(Oral)
- 링크: arXiv 2505.13447, OpenReview, 코드