뉴턴 한 걸음으로 충분한지는 잣대가 정한다
머신 언러닝, 가우스 차분 프라이버시, 고차원 통계
한 줄 요약
매개변수 수 \(p\)가 표본 수 \(n\)과 맞먹는 고차원에서도, 지운 데이터의 흔적을 가설 검정으로 재면 뉴턴 한 걸음에 가우스 노이즈를 더하는 것만으로 지우기의 보장과 예측 정확도를 함께 얻는다. 두 걸음이 필요하다던 앞선 분석과 결론이 갈린 까닭은 프라이버시를 재는 잣대에 있었다.
무엇이 달라졌나
머신 언러닝(machine unlearning)은 학습에 쓴 일부 데이터의 영향을 재학습 없이 지우는 일이다. 뉴턴 한 걸음으로 재학습 결과를 흉내 내고 남은 차이를 노이즈로 가리는 방법이 대표적이고, Guo 외(2020)와 Sekhari 외(2021)는 한 걸음이면 충분하다고 보였다(1장).
다만 이런 분석들은 표본별 손실에 상수 크기의 강볼록성과 매끄러움 같은 가정을 둔다(1장, 표 1). \(p\)와 \(n\)이 비례하면 릿지 회귀에서도 둘이 함께 성립하지 않는다. 매끄러움을 지키려 \(\|x_i\|\)를 1 수준으로 맞추면 표본별 헤시안의 최소 고윳값이 \(2\lambda/n\)밖에 되지 않는다(1장, 부록 D.4).
가정을 풀어 비례 영역을 분석한 선행 연구는 Zou 외(2025)뿐이고, 이 연구는 데이터 하나를 지울 때도 뉴턴 두 걸음이 필요하다고 결론지었다. 이 논문은 같은 가정에서 노이즈를 가우스로 바꾸면 한 걸음으로 충분하다고 보인다. \(R = C_1(n)\sqrt{C_2(n)m^3/(2\lambda\nu n)}\)로 두고 노이즈 \(b\sim N(0, R^2/\varepsilon^2 I_p)\)를 더하면 \((\phi_n,\varepsilon)\)-가우스 인증이 성립한다(정리 2, 식 16). \(C_1, C_2\)는 polylog 인자, \(\lambda\)는 정규화 세기, \(\nu\)는 정규화항의 강볼록 상수다. 이때 새 표본에서 잰 재학습 모델과의 손실 차이(GED, 정의 3)는 \(O_p(m^2\,\mathrm{polylog}(n)/\sqrt{n})\)로 줄어든다(정리 3, 식 17).
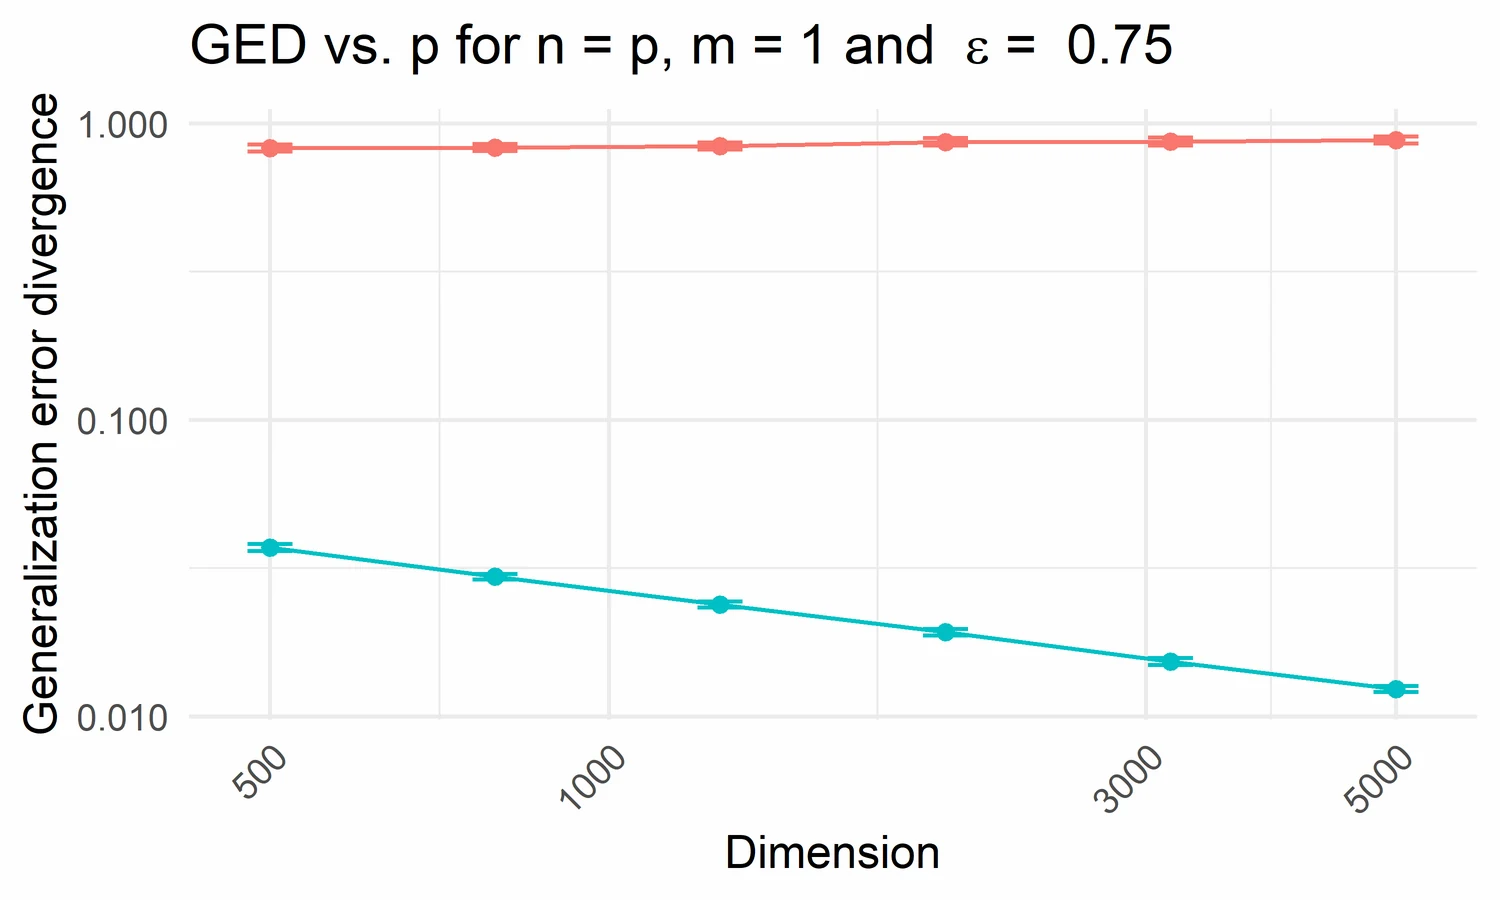
\(\log\) GED를 \(\log p\)에 맞춘 기울기가 가우스 쪽은 \(m\) = 1, 5, 10에서 \(-0.47\), \(-0.54\), \(-0.51\)이고, 라플라스 쪽은 \(0.03\), \(-0.03\), \(-0.01\)로 줄지 않는다(5장, 그림 1).
어떻게 보였나
공격자가 공개된 모델이 지울 데이터 없이 재학습한 뒤 같은 절차를 거친 출력(\(H_0\))인지, 지우기 절차의 출력(\(H_1\))인지 가린다고 하자(식 4). 1종 오류를 \(\alpha\) 이하로 묶을 때 가능한 가장 작은 2종 오류가 트레이드오프 함수다(정의 1). 데이터에 대해 \(1-\phi\) 이상의 확률로, 크기 \(m\) 이하의 모든 삭제 집합에서 양방향 트레이드오프가 기준 곡선 \(f\) 위에 있으면 \(f\)-인증이다(정의 2). 기준을 \(f_{G,\varepsilon}(\alpha)=\Phi(\Phi^{-1}(1-\alpha)-\varepsilon)\), 곧 \(N(0,1)\)과 \(N(\varepsilon,1)\)을 가리는 어려움으로 두면 가우스 인증(GPAR)이 된다(식 9).
블로그의 해석으로는, 이는 Dong 외(2022)의 가우스 차분 프라이버시(Gaussian differential privacy)에서 이웃 데이터셋 쌍을 “재학습 대 지우기” 쌍으로 바꾸고 데이터에 대한 실패 확률 \(\phi\)를 허용한 정의다. \(\varepsilon\)은 그 \(\mu\) 자리에 있다. 5장의 \(\varepsilon=0.75\)라면 1종 오류를 5%로 묶은 공격자의 2종 오류는 적어도 0.81이다(식 9).
(가) 공격자의 구별 문제
(나) 트레이드오프 곡선
두 출력은 재학습 해 \(\hat\beta_{\setminus M}\)와 뉴턴 한 걸음 \(\hat\beta^{(1)}_{\setminus M}\)에 같은 등방 가우스 노이즈를 더한 것이고, 이때 트레이드오프는 차원과 상관없이 평균 사이 거리를 \(\sigma\)로 나눈 값으로 정해진다(보조정리 1). 그 거리가 \(R\) 이하이면 \(\sigma=R/\varepsilon\)으로 인증이 끝나고(부록 G.2, 식 61), 그럴 확률이 \(1-\phi_n\) 이상이라는 것은 Zou 외의 정리에서 온다(부록 정리 7). 노이즈가 덮을 것은 지우기의 효과 전체가 아니라 뉴턴 근사의 오차뿐이다.
걸음 수를 가른 것은 노이즈의 모양이다. Zou 외의 등방 라플라스 노이즈는 같은 \(R\)에서 크기가 \(pR/\varepsilon\) 수준이고, 가우스 노이즈는 \(\sqrt{p}R/\varepsilon\) 수준이다. 가정 B1에서 새 표본의 예측값은 노이즈 크기를 \(\sqrt{p}\)로 나눈 정도로 흔들리므로, 라플라스 쪽은 줄지 않고 가우스 쪽은 \(R/\varepsilon\)처럼 줄어든다(Zou 외 3.3절, 부록 G.3).
눈여겨볼 점
첫째, 같은 \(\varepsilon\)이라도 두 잣대의 약속은 다르다. Zou 외의 \(\varepsilon\)-인증은 어떤 사건에서든 두 출력의 확률 비를 \(e^{\varepsilon}\) 안에 묶지만(Zou 외 2.1절), 가우스 인증은 꼬리에서 그 비가 커지는 것을 허용한다. 그림 (나)처럼 1종 오류가 작은 구간에서는 \(\varepsilon\)-인증이 더 엄격하다. 블로그의 해석으로는 한 걸음과 두 걸음의 차이 일부는 약속을 바꾼 데서 온다. 다만 가우스 인증이 함의하는 \((\varepsilon,\delta(\varepsilon))\) 기준에 맞춘 노이즈보다도 GED는 작았다(5.1절, 그림 4).
둘째, \(C_1(n)\), \(C_2(n)\)의 구체적인 값은 본문에 없다. 부록 F.3이 실제로 \(\sigma\)를 정하는 규칙 두 가지를 주지만 엄밀한 증명은 과제로 남겼다(각주 14). 리뷰어들도 이 점을 짚었다. 가정도 좁다. 볼록 손실과 분리 가능한 강볼록 정규화항, 서브가우시안 특징의 일반화 선형 모형이고(4.2절), GED가 0으로 간다는 보장도 지울 표본 수가 \(m=o(n^{1/4-\alpha})\)일 때만 선다. 실제 데이터에서는 저차원인 MNIST에서 세 잣대가 비슷했고 고차원인 IMDb에서만 가우스 쪽이 앞섰다(5.1절, 그림 5).
열린 질문
- \(p\times p\) 헤시안을 직접 풀지 않는 근사 뉴턴 걸음에서도, 근사 오차까지 합친 \(R\)을 같은 차수로 묶어 한 걸음 가우스 인증을 지킬 수 있을까.
이해 확인
정리 2에서 노이즈의 표준편차를 \(R/\varepsilon\)으로 두면 가우스 인증이 성립하는 까닭은?
- 노이즈가 지운 데이터의 영향 \(\hat\beta-\hat\beta_{\setminus M}\) 전체를 덮을 만큼 크기 때문이다
- 두 출력에 같은 등방 가우스 노이즈가 더해져 구별의 어려움이 평균 사이 거리를 \(\sigma\)로 나눈 값으로 정해지고, 그 거리가 높은 확률로 \(R\) 이하이기 때문이다
- 고차원에서는 어떤 노이즈를 더해도 가우스 노이즈와 같아지기 때문이다
- 차원 \(p\)가 커지면 트레이드오프 곡선이 저절로 대각선에 붙기 때문이다
보조정리 1에 따라 \(\hat\beta_{\setminus M}+b\)와 \(\hat\beta^{(1)}_{\setminus M}+b\)를 가리는 일은 \(N(0,1)\)과 \(N(\|\hat\beta^{(1)}_{\setminus M}-\hat\beta_{\setminus M}\|/\sigma,1)\)을 가리는 일과 같고, 그 거리가 \(1-\phi_n\) 이상의 확률로 \(R\) 이하라는 정리 7이 나머지를 맡는다(부록 G.2). 노이즈는 뉴턴 근사의 오차만 덮으면 되니 1번은 틀렸다. 3번의 보편성은 증명에 쓰이지 않고, 곡선은 차원과 무관하다.
논문 정보
- 제목: Gaussian Certified Unlearning in High Dimensions: A Hypothesis Testing Approach
- 저자: Aaradhya Pandey, Sanjeev Kulkarni (Princeton University), Arnab Auddy (The Ohio State University), Haolin Zou, Arian Maleki (Columbia University)
- 학회: ICLR 2026 구두 발표(Oral)
- 링크: arXiv 2510.13094, OpenReview