ICLR 2026 Oral
각도를 재지 않고 임계값만 넘는지 묻는 시험이 그래프 검색을 빠르게 한다
근사 최근접 이웃 검색, 무작위 투영, 그래프 기반 검색
한 줄 요약
그래프 기반 근사 최근접 이웃 검색(approximate nearest neighbor search)에서 이웃마다 정확한 거리를 계산하는 대신, 미리 저장한 투영값으로 “각이 임계값보다 작은가”만 확률적으로 판정한다. 가우시안 무작위 투영 대신 구 위에 고르게 놓은 투영 벡터와 그 벡터까지의 기준 각(reference angle)을 함께 쓰면, 투영 개수가 무한하다는 가정 없이 판정 확률을 정확히 쓸 수 있고 HNSW 검색이 2.5~3배 빨라진다.
무엇이 달라졌나
벡터 검색에서 노름을 미리 저장해 두면 거리와 내적은 결국 두 단위 벡터 사이 각의 코사인으로 바뀐다(1절). 그런데 검색 도중에는 각의 정확한 값보다 판정 결과가 필요할 때가 많다. 이 논문은 이를 각도 시험(angle testing)이라 부르고, 비교와 임계값 판정의 두 문제를 \(o(d)\) 비용으로 푸는 확률적 커널(probabilistic kernel)을 설계한다(문제 1.1, 1.2).
임계값 판정 쪽 커널을 HNSW에 붙인 KS2 시험이 핵심 결과다. 그래프를 돌다가 이웃이 시험을 통과할 때만 정확한 거리를 계산하고, 통과하지 못한 이웃은 버린다(6.2절). 단일 CPU 스레드로 여섯 개 데이터셋에서 잰 결과, Word를 뺀 모든 데이터셋에서 HNSW+KS2가 가장 빨랐다. HNSW보다 2.5~3배, 같은 저자들의 이전 방법인 HNSW+PEOs보다 1.1~1.3배 빠르다(7.2절, 그림 1). 폭은 데이터셋마다 달라서, 그림 1을 읽으면 재현율 0.9 부근에서 960차원 GIST는 약 3배, 128차원 SIFT는 약 2배다.
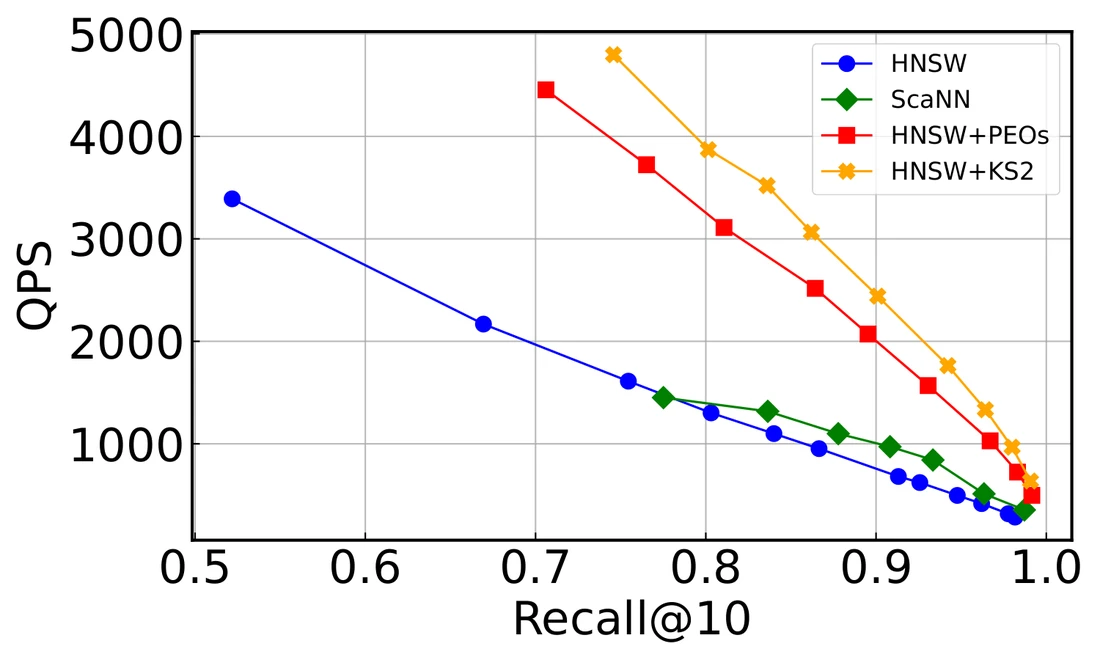
어떻게 보였나
PEOs를 포함한 기존 방법은 가우시안 벡터 \(m\)개 가운데 투영값이 가장 큰 것을 고르고, \(m\)이 무한대로 갈 때의 분포(보조정리 1.3)에 기대어 왔다. 실제 \(m\)은 유한하므로 이 근사가 얼마나 맞는지는 알 수 없었다(1절).
새 커널은 단위 벡터 집합 \(S\)와 무작위 회전 \(H\)를 쓴다. 후보 \(v\)와 가장 가까운 투영 벡터를 기준 벡터 \(Z_S(v)\)로 두고, 그 각 \(\psi\)의 코사인을 \(A_S(v)\)로 둔다. 커널은 질의를 기준 벡터에 투영한 값을 \(A_S\)로 나눈 \(K(q,v)=\langle Hq, Z_S(Hv)\rangle/A_S(Hv)\)다(식 3). 기준 벡터는 \(v\) 쪽 성분 \(\cos\psi\)와 나머지 방향 성분 \(\sin\psi\)로 나뉘므로, \(K\)는 참값 \(\cos\phi\)를 중심으로 \(\tan\psi\)에 비례하는 폭으로 흩어진다. 흩어지는 분포는 베타 분포로 정확히 쓸 수 있다(보조정리 4.2, 부록 B).
보장은 이렇다. 참 각도가 임계각 이하이면 시험을 통과할 확률이 0.5 이상이고, 임계각보다 크면 통과 확률이 정규화 불완전 베타 함수 값으로 0.5보다 작으며 각이 클수록 줄어든다(보조정리 4.3). 극한 가정은 없고 \(\psi\)만 작으면 판정이 날카로워진다. 그래서 투영 벡터를 대척점 쌍(알고리즘 1)이나 회전한 정축체(cross-polytope, 알고리즘 2)로 놓고, 공간을 \(L\)개 부분공간으로 나눠 가상의 투영 벡터 \(m^L\)개를 만든다(5절). \(m=256\)이라 기준 벡터 번호가 1바이트에 들어가고, 간선마다 표 조회 \(L\)번과 덧셈 몇 번이면 시험이 끝난다(6.2절).
(가) 부분공간 수와 기준 각
(나) 각도 임계값 시험의 통과 비율
위 그림은 이 판정식을 128차원에서 그대로 돌린 결과다. 어떤 \(L\)에서든 통과 비율은 임계각에서 0.5를 지나고, \(L=8\)이면 임계각보다 10도 먼 후보의 통과 비율이 0.06으로 떨어진다.
눈여겨볼 점
보장의 형태는 약하다. 진짜 이웃이 통과할 확률의 하한이 0.5라서 그래프 탐색 전체는 \((\delta, 0.5)\) 라우팅이라는 보장만 얻는다(따름정리 6.2). 최종 재현율은 실험으로만 확인된다. 시험에서 떨어진 이웃은 큐에도 들어가지 않으므로 탐색 가지 자체가 잘린다는 점을 리뷰 토론에서 저자들도 인정했다.
속도는 메모리와 바꾼 것이다. 그림 2(a)를 읽으면 SIFT에서 \(L=8\)일 때 HNSW 위에 더해지는 색인 크기가 HNSW의 80%를 넘는다. PEOs보다는 작다. 비교 대상에 그래프와 양자화를 함께 쓰는 최신 방법은 빠졌고, 평가는 단일 스레드였다는 지적도 리뷰에서 나왔다.
블로그의 해석으로는, 그림 (가)에서 구성을 바꿔 얻는 차이(L=8에서 0.64 대 0.59)보다 \(L\)을 늘려 얻는 차이가 훨씬 크다. 비교 문제용 커널 KS1이 CEOs보다 재현율을 최대 0.8% 높이는 데 그친 것(1절, 표 1)도 같은 방향을 가리킨다. 이 논문의 기여는 투영 벡터의 모양보다, 이미 알고 있는 기준 각을 판정식에 넣어 확률을 극한 없이 쓴 데 있다.
열린 질문
- 간선마다 기준 각을 알고 있으니 통과 확률도 간선마다 계산할 수 있다. 이를 이용해 임계값을 조절하면, 그래프 탐색 전체의 재현율을 실험 없이 미리 정하거나 그 하한을 보일 수 있을까.
이해 확인
KS2 시험의 커널이 PEOs 같은 가우시안 투영 방법과 다른 핵심은?
- 가우시안 투영 벡터를 무한히 많이 쓴다는 가정 아래 투영값의 분포를 근사한다
- 질의를 후보의 기준 벡터에 투영한 값을 기준 각의 코사인으로 나누어, 참 각도의 코사인을 중심으로 흩어지는 값을 만든다
- 질의와 후보가 같은 초평면 칸에 들어가는지만 보고 해시 충돌 여부로 판정한다
- 이웃마다 정확한 내적을 먼저 계산한 뒤 그 값을 임계값과 비교한다
식 3의 커널은 ⟨Hq, Z(Hv)⟩를 A(Hv)로 나누어 기준 각 정보까지 쓴다. 그래서 유한한 투영 개수에서도 분포를 베타 분포로 정확히 쓸 수 있다(보조정리 4.2, 4.3). 1은 기존 CEOs 계열이 기대던 극한 가정이고, 3은 SimHash 같은 해시 방식, 4는 시험으로 피하려던 계산이다.
논문 정보
- 제목: Probabilistic Kernel Function for Fast Angle Testing
- 저자: Kejing Lu (Yamanashi University), Chuan Xiao (Osaka University, Nagoya University), Yoshiharu Ishikawa (Nagoya University)
- 학회: ICLR 2026 구두 발표(Oral)
- 링크: arXiv, OpenReview, 코드